
شبکه عصبی کانولوشنی انقلابی بود که بینایی کامپیوتر را از آزمایشگاه به گوشی همهی ما آورد. پیش از آن، مهندسان باید با دست ویژگیهای تصویر را طراحی میکردند؛ لبه، گوشه، بافت. CNN این کار را خودش یاد میگیرد. از لبههای ساده در لایههای اول تا چشم و گوش و صورت در لایههای عمیقتر.
در قسمت ۳۱ یک شبکهی کاملاً متصل برای ارقام دستنویس ساختیم. آن شبکه تصویر را به یک بردار تخت تبدیل میکرد و ساختار مکانیاش را دور میریخت. در این قسمت میبینیم CNN چطور این ساختار را حفظ و از آن استفاده میکند. در پایان هم یک CNN را با PyTorch میسازیم.
مشکل شبکه کاملاً متصل با تصویر
در زندگی واقعی میخواهیم یک شیء را در هر جای تصویر تشخیص دهیم. گربه چه در گوشهی بالا باشد و چه در وسط، باید گربه تشخیص داده شود. شبکهی کاملاً متصل این را ذاتاً نمیفهمد. برای او گربهی بالا و گربهی پایین دو الگوی کاملاً متفاوتاند.
مشکل دوم تعداد پارامترهاست. یک تصویر رنگی ۲۲۴ در ۲۲۴ حدود ۱۵۰ هزار عدد دارد. اگر لایهی اول هزار نورون داشته باشد، ۱۵۰ میلیون وزن فقط در همین لایه لازم است. این هم کند است و هم به دادهی بسیار زیادی نیاز دارد.
فیلتر کانولوشنی؛ پنجرهای که میلغزد
راهحل از پردازش تصویر کلاسیک آمده است. فیلتر کانولوشنی یک پنجرهی کوچک، مثلاً سه در سه، از عددهاست. این پنجره روی تصویر میلغزد و در هر موقعیت، جمع وزندار پیکسلهای زیرش را حساب میکند. نتیجه یک تصویر تازه به نام نقشهی ویژگی است.
هر فیلتر به الگوی خاصی حساس است. فیلتر لبهی عمودی جایی که روشنایی از چپ به راست تغییر میکند، عدد بزرگ میدهد. اگر فیلترهای لبهی عمودی و افقی را روی ارقام MNIST اعمال کنید، خطوط عمودی و افقی هر رقم برجسته میشوند.
از فیلتر دستی تا فیلتر یادگرفته
قبلاً مهندسان مجموعهی بزرگی از فیلترهای دستی مثل بانک فیلتر لئونگ-مالیک طراحی میکردند. ایدهی بزرگ CNN این است که عددهای فیلتر را هم وزنهای شبکه در نظر بگیریم و بگذاریم با نزول گرادیان یاد گرفته شوند.
حالا شبکه خودش تصمیم میگیرد کدام الگوها برای حل مسئله مفیدند. و چون یک فیلتر در همهی نقاط تصویر اعمال میشود، الگو در هر جا تشخیص داده میشود. تعداد پارامترها هم فقط به اندازهی فیلتر بستگی دارد، نه به اندازهی تصویر.
اجزای شبکه عصبی کانولوشنی
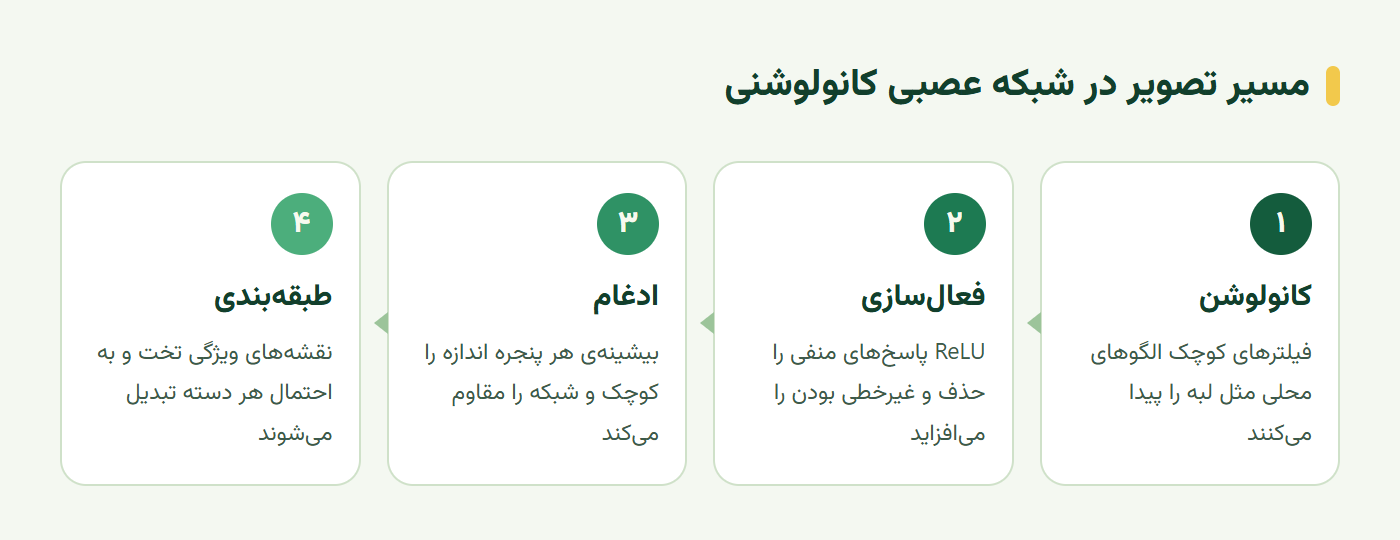
یک CNN از چند نوع لایه ساخته میشود که پشت سر هم تکرار میشوند. شناختن هر لایه کمک میکند معماریهای مختلف را بخوانید و بفهمید. نمودار زیر مسیر یک تصویر در CNN را نشان میدهد.
لایهی کانولوشن
لایهی کانولوشن چندین فیلتر را همزمان روی ورودی اعمال میکند. اگر ۱۶ فیلتر داشته باشد، ۱۶ نقشهی ویژگی تولید میکند. هر نقشه نشان میدهد یک الگوی خاص کجای تصویر پیدا شده است. پس از کانولوشن معمولاً یک تابع فعالسازی مثل ReLU اعمال میشود.
لایهی کانولوشن بعدی روی همین نقشههای ویژگی کار میکند، نه روی تصویر اصلی. پس الگوهای ترکیبی پیدا میکند؛ مثلاً گوشهای که از ترکیب دو لبه ساخته شده است. هرچه عمیقتر برویم، الگوها پیچیدهتر و انتزاعیتر میشوند.
لایهی ادغام
لایهی ادغام یا Pooling اندازهی نقشههای ویژگی را کوچک میکند. رایجترین نوع، ادغام بیشینه است که از هر پنجرهی دو در دو فقط بزرگترین عدد را نگه میدارد. پس عرض و ارتفاع نصف میشوند.
این کار دو فایده دارد. محاسبات لایههای بعد را کم میکند. و شبکه را نسبت به جابهجایی کوچک مقاوم میکند؛ اگر لبه یک پیکسل جابهجا شود، بیشینهی پنجره تقریباً همان میماند.
بیشتر بخوانید: ترتیب ابعاد تصویر، نرمالسازی و قرارداد ورودی را که پیش از CNN لازم است، در بینایی کامپیوتر چیست؟ با OpenCV دیدیم.
معماری هرمی و VGG-16
بیشتر CNNهای طبقهبندی تصویر معماری هرمی دارند. از بالا به پایین، اندازهی مکانی نقشهها کوچکتر و تعداد کانالها بیشتر میشود. یعنی شبکه بهتدریج از «کجا» به «چه چیزی» میرود.
VGG-16؛ نمونهی کلاسیک
VGG-16 نمونهی مشهور این معماری است که در سال ۲۰۱۴ به دقت ۹۲٫۷ درصد در پنج پیشبینی برتر روی ImageNet رسید. ساختارش ساده و منظم است. بلوکهایی از دو یا سه لایهی کانولوشن سه در سه، پشت هرکدام یک لایهی ادغام. تعداد فیلترها از ۶۴ شروع میشود و تا ۵۱۲ دو برابر میشود.
در انتهای شبکه، نقشههای ویژگی تخت میشوند و از چند لایهی کاملاً متصل میگذرند. لایهی آخر هزار خروجی برای هزار دستهی ImageNet دارد. معماریهای بعدی مثل ResNet عمیقتر و کارآمدترند، اما ایدهی هرمی همچنان پابرجاست.
بهینهسازها برای شبکههای عمیق
آموزش شبکهی عمیق با نزول گرادیان ساده کند است. نزول گرادیان تصادفی یا SGD روی مینیبچها کار میکند. نسخهی مومنتوم بخشی از گرادیان قدمهای قبلی را نگه میدارد؛ مثل توپی که با اینرسی از تپه پایین میغلتد و در درههای کوچک گیر نمیکند.
Adam ترکیبی از مومنتوم و نرخ یادگیری تطبیقی برای هر وزن است. معمولاً بدون تنظیم زیاد خوب کار میکند و انتخاب پیشفرض بسیاری از پروژههاست. برای رسیدن به بهترین دقت نهایی، گاهی SGD با مومنتوم و کاهش تدریجی نرخ یادگیری کمی بهتر است.
ساخت یک CNN با PyTorch
حالا یک CNN کوچک برای ارقام MNIST میسازیم و با شبکهی کاملاً متصل قسمت ۳۱ مقایسه میکنیم. دو بلوک کانولوشن و ادغام داریم و در پایان یک لایهی کاملاً متصل.
کد مدل
ورودی تصویر ۲۸ در ۲۸ با یک کانال است. پس از دو بار ادغام، اندازه به هفت در هفت میرسد:
import torch
from torch import nn

class SmallCNN(nn.Module):
    def __init__(self):
        super().__init__()
        self.features = nn.Sequential(
            nn.Conv2d(1, 16, kernel_size=3, padding=1), nn.ReLU(), nn.MaxPool2d(2),
            nn.Conv2d(16, 32, kernel_size=3, padding=1), nn.ReLU(), nn.MaxPool2d(2),
        )
        self.classifier = nn.Sequential(nn.Flatten(), nn.Dropout(0.3), nn.Linear(32 * 7 * 7, 10))

    def forward(self, x):
        return self.classifier(self.features(x))

model = SmallCNN()
print(sum(p.numel() for p in model.parameters()), "parameters")
مقایسه با شبکهی کاملاً متصل
این CNN حدود ۲۰ هزار پارامتر دارد. شبکهی کاملاً متصل قسمت ۳۱ با یک لایهی ۲۵۶ نورونی بیش از ۲۰۰ هزار پارامتر داشت. با همان حلقهی آموزش قسمت ۳۲، CNN معمولاً با پارامترهای بسیار کمتر به دقت بالاتری میرسد.
این همان قدرت اشتراک وزن است. برای مسئلهی سختتری مثل تشخیص ۳۷ نژاد گربه و سگ در مجموعهدادهی حیوانات خانگی آکسفورد، CNN از صفر هم کار میکند، اما دقتش محدود است. قسمت بعد نشان میدهد چطور با یادگیری انتقالی، همین مسئله را بسیار بهتر حل کنیم.
تمرین عملی؛ دیدن آنچه CNN میبیند
روی CNN بالا این آزمایشها را انجام دهید:
- آموزش و مقایسه: CNN را پنج دوره آموزش دهید و دقت و تعداد پارامترها را با شبکهی کاملاً متصل مقایسه کنید.
- فیلترهای لایهی اول: ۱۶ فیلتر سه در سهی لایهی اول را به شکل تصویر نمایش دهید.
- نقشههای ویژگی: یک رقم را از لایهی اول عبور دهید و ۱۶ نقشهی ویژگیاش را ببینید.
- جابهجایی: رقم را دو پیکسل جابهجا کنید و ببینید پیشبینی هر دو شبکه تغییر میکند یا نه.
آزمایش آخر تفاوت اصلی CNN را ملموس میکند. شبکهای که ساختار مکانی را میفهمد، به جابهجایی کوچک حساس نیست.
سخن پایانی
شبکه عصبی کانولوشنی با فیلترهای کوچکی که روی تصویر میلغزند، الگوهای محلی را پیدا میکند. وزنهای این فیلترها یاد گرفته میشوند و در همهی نقاط تصویر مشترکاند. لایهی ادغام اندازه را کوچک و شبکه را مقاوم میکند.
معماری هرمی از «کجا» به «چه چیزی» میرود و VGG-16 نمونهی کلاسیک آن است. نتیجه شبکهای است که با پارامترهای بسیار کمتر، دقیقتر از شبکهی کاملاً متصل تصویر را میفهمد. این ایده پایهی تقریباً همهی مدلهای بینایی امروز است.
این آموزش بر پایهی درس Convolutional Neural Networks از مجموعهی آزاد AI for Beginners مایکروسافت (مجوز MIT) به فارسی بازنویسی و تکمیل شده است.
پرسشهای پرتکرار
شبکه عصبی کانولوشنی چیست؟
شبکه عصبی کانولوشنی یا CNN نوعی شبکهی عصبی برای دادهی تصویری است. به جای اتصال هر نورون به همهی پیکسلها، فیلترهای کوچکی روی تصویر میلغزند و الگوهای محلی مثل لبه و بافت را پیدا میکنند. این فیلترها در طول آموزش خودکار یاد گرفته میشوند.
فیلتر کانولوشن چه کاری انجام میکند؟
فیلتر یک پنجرهی کوچک، مثلاً سه در سه، از وزنهاست که روی تصویر حرکت میکند و در هر موقعیت جمع وزندار پیکسلهای زیرش را حساب میکند. هر فیلتر به الگوی خاصی حساس است؛ مثلاً لبهی عمودی یا افقی.
لایه ادغام یا Pooling چیست؟
لایهی ادغام اندازهی نقشهی ویژگی را کوچک میکند؛ مثلاً از هر پنجرهی دو در دو فقط بیشینه را نگه میدارد. این کار محاسبات را کم میکند و شبکه را نسبت به جابهجایی کوچک اشیا مقاومتر میکند.
چرا CNN برای تصویر بهتر از شبکه کاملاً متصل است؟
چون وزنهای فیلتر در همهی نقاط تصویر مشترکاند، تعداد پارامترها بسیار کمتر است و شبکه یک الگو را در هر جای تصویر تشخیص میدهد. شبکهی کاملاً متصل ساختار مکانی تصویر را نادیده میگیرد و به دادهی خیلی بیشتری نیاز دارد.
دیدگاهها
هنوز دیدگاهی ثبت نشده است. شروعکننده باشید — پرسش و اصلاح را با آغوش باز میپذیریم.