
یادگیری انتقالی جواب مشکلی است که تقریباً هر پروژهی واقعی بینایی کامپیوتر با آن روبهروست. آموزش یک CNN خوب از صفر به صدها هزار تصویر برچسبخورده و روزها پردازندهی گرافیکی نیاز دارد. اما شما فقط چند صد تصویر دارید. خبر خوب این است که لازم نیست از صفر شروع کنید.
در قسمت قبل دیدیم CNN در لایههای اول لبه و بافت را یاد میگیرد و در لایههای عمیقتر مفاهیم پیچیدهتر را. این الگوهای اولیه تقریباً برای هر مسئلهی تصویری مفیدند. در این قسمت یاد میگیریم از مدلی که روی میلیونها تصویر آموزش دیده، برای مسئلهی خودمان استفاده کنیم.
یادگیری انتقالی چیست؟
یادگیری انتقالی یعنی دانش یک مدل را به مسئلهی دیگری منتقل کنیم. این اصطلاح در علوم تربیتی هم به کار میرود؛ وقتی دانش یک حوزه به یادگیری حوزهی دیگر کمک میکند. کسی که پیانو بلد است، گیتار را سریعتر یاد میگیرد.
در یادگیری عمیق، مدلی را برمیداریم که روی مجموعهدادهی بزرگی مثل ImageNet آموزش دیده است. این مدل هزار دسته از اشیا را میشناسد. لایههای اولش الگوهای عمومی بینایی را یاد گرفتهاند. ما فقط لایهی آخر را برای مسئلهی خودمان عوض میکنیم.
چرا کار میکند؟
لایههای اول هر CNN لبه، رنگ و بافت را تشخیص میدهند. این الگوها چه برای تشخیص گربه، چه برای تشخیص سند و چه برای تشخیص بیماری پوستی مفیدند. لایههای میانی ترکیبهایی مثل گوشه، دایره و الگوهای تکرارشونده را میشناسند.
فقط لایههای آخر مخصوص مسئلهی اصلیاند؛ مثلاً «این گوش گربه است». پس اگر لایههای آخر را با لایهی تازه جایگزین کنیم، بیشتر دانش مدل حفظ میشود. این دانش را با دادهی کم خودمان تکمیل میکنیم.
مدلهای آمادهی رایج
هم PyTorch و هم Keras دهها مدل آماده با وزنهای ImageNet دارند:
- VGG-16 و VGG-19: ساده و قابل فهم، اما سنگین و کند.
- ResNet: خانوادهای که مایکروسافت در ۲۰۱۵ معرفی کرد و با اتصالهای میانبر، آموزش شبکههای بسیار عمیق را ممکن کرد.
- MobileNet: کوچک و سریع، برای گوشی و دستگاههای کمتوان.
- EfficientNet: تعادل خوب بین دقت و اندازه با مقیاسبندی منظم.
برای شروع، ResNet-18 یا ResNet-50 انتخاب امنی است. اگر مدل باید روی گوشی اجرا شود، MobileNet را امتحان کنید.
دو روش یادگیری انتقالی
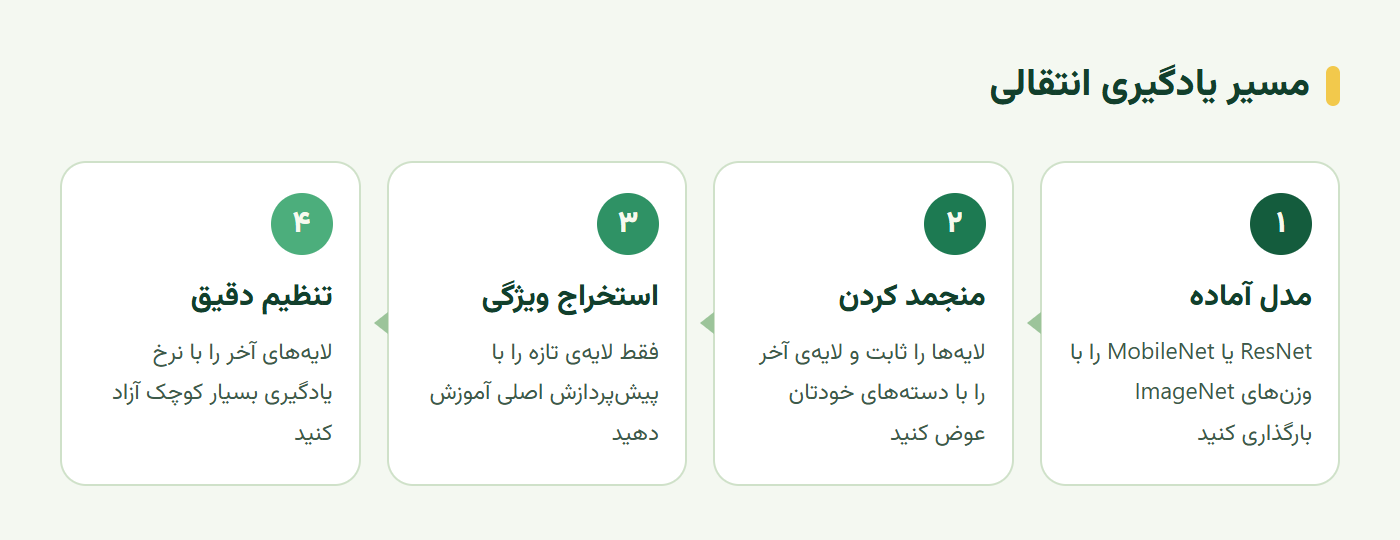
یادگیری انتقالی دو روش اصلی دارد که معمولاً پشت سر هم به کار میروند. انتخاب بین آنها به اندازهی داده و شباهت مسئله به ImageNet بستگی دارد. نمودار زیر مسیر کامل را نشان میدهد.
استخراج ویژگی
در روش اول، همهی لایههای مدل آماده منجمد میشوند؛ یعنی وزنهایشان تغییر نمیکند. فقط لایهی طبقهبند آخر با یک لایهی تازه جایگزین و آموزش داده میشود. مدل آماده عملاً یک استخراجکنندهی ویژگی است که هر تصویر را به یک بردار معنادار تبدیل میکند.
این روش بسیار سریع است و با چند صد تصویر هم خوب کار میکند. خطر بیشبرازش هم کم است، چون فقط تعداد کمی پارامتر آموزش میبیند. برای بیشتر پروژههای کوچک، همین روش کافی است.
تنظیم دقیق
اگر دادهی بیشتری دارید یا مسئلهتان با ImageNet تفاوت زیادی دارد، مثلاً تصویرهای پزشکی، تنظیم دقیق بهتر است. پس از آموزش لایهی آخر، چند لایهی آخر مدل آماده را هم از انجماد درمیآورید و با نرخ یادگیری بسیار کوچک آموزش میدهید.
نرخ یادگیری کوچک حیاتی است. با نرخ بزرگ، گرادیانهای لایهی تازه که هنوز تصادفی است، وزنهای ارزشمند مدل آماده را خراب میکنند. قاعدهی رایج این است که نرخ یادگیری تنظیم دقیق ده تا صد برابر کوچکتر از نرخ آموزش لایهی آخر باشد.
بیشتر بخوانید: لایهی کانولوشن، ادغام و معماری هرمی را که مدلهای آماده بر آن ساخته شدهاند، در شبکه عصبی کانولوشنی (CNN) چیست؟ دیدیم.
مثال عملی؛ نژاد حیوانات خانگی
مجموعهدادهی حیوانات خانگی آکسفورد ۳۷ نژاد گربه و سگ را دارد و برای هر نژاد حدود ۲۰۰ تصویر. آموزش CNN از صفر روی این داده دقت محدودی میدهد. با یادگیری انتقالی، همین مسئله در چند دقیقه با دقت بسیار بهتری حل میشود.
استخراج ویژگی با ResNet-18
کد زیر ResNet-18 را با وزنهای ImageNet بارگذاری میکند، همهی لایهها را منجمد میکند و لایهی آخر را با یک لایهی ۳۷ خروجی عوض میکند:
import torch
from torch import nn
from torchvision import models
weights = models.ResNet18_Weights.DEFAULT
model = models.resnet18(weights=weights)
for p in model.parameters():
p.requires_grad = False # منجمد کردن همهی لایهها
model.fc = nn.Linear(model.fc.in_features, 37) # لایهی تازه، قابل آموزش
opt = torch.optim.Adam(model.fc.parameters(), lr=1e-3)
preprocess = weights.transforms() # همان پیشپردازش آموزش اصلینکتهی پیشپردازش
به خط آخر دقت کنید. weights.transforms() دقیقاً همان تغییر اندازه، برش و نرمالسازی را برمیگرداند که مدل با آن آموزش دیده است. اگر نرمالسازی متفاوتی به کار ببرید، ویژگیهای استخراجشده بیمعنا میشوند.
این همان قرارداد ورودی است که در قسمت بینایی کامپیوتر دربارهاش حرف زدیم. پس از آموزش لایهی آخر، برای تنظیم دقیق، لایهی layer4 را از انجماد درمیآورید و با نرخ یادگیری حدود 1e-5 ادامه میدهید.
افزایش داده و محدودیتها
با دادهی کم، حتی یادگیری انتقالی هم ممکن است بیشبرازش کند. افزایش داده یکی از مؤثرترین راههای مقابله است. همزمان باید محدودیتهای مدلهای آماده را هم بشناسید.
افزایش داده
افزایش داده یعنی در هر دوره، نسخهی کمی تغییریافته از هر تصویر را به مدل بدهیم. چرخش کوچک، برش تصادفی، قرینهی افقی و تغییر روشنایی رایجترین روشها هستند. مدل هر بار تصویر را کمی متفاوت میبیند و به جزئیات نامربوط حساس نمیشود.
اما هر تبدیلی مناسب هر مسئلهای نیست. قرینهی افقی برای عکس حیوان بیخطر است، اما برای تشخیص سند یا عدد، متن را برعکس میکند. تبدیلها را بر اساس اینکه در دنیای واقعی چه تغییری ممکن است، انتخاب کنید.
گربهی ایدهآل و حملهی تخاصمی
یک آزمایش جالب نشان میدهد مدلها چطور «میبینند». اگر از یک تصویر تصادفی شروع کنیم و آن را طوری تغییر دهیم که احتمال «گربه» بیشینه شود، به تصویری شبیه نویز میرسیم. با افزودن جریمهی نرمی به تابع خطا، تصویر کمی شبیه گربه میشود، اما هنوز عجیب است.
همین روش برای حملهی تخاصمی هم به کار میرود. با تغییری نامحسوس برای انسان، عکس سگ را طوری تغییر میدهیم که مدل آن را گربه تشخیص دهد. درس مهم برای سازندهی محصول این است؛ اگر مدل بینایی تصمیم مهمی میگیرد، مثلاً تأیید هویت، باید در برابر ورودی دستکاریشده آزموده شود.
تمرین عملی؛ سه روش، یک مسئله
روی مجموعهدادهی حیوانات خانگی یا دادهی تصویری خودتان، سه روش را مقایسه کنید:
- از صفر: CNN کوچک قسمت قبل را آموزش دهید.
- استخراج ویژگی: ResNet-18 منجمد با لایهی آخر تازه.
- تنظیم دقیق: همان مدل با آزاد کردن
layer4و نرخ یادگیری کوچک.
برای هر روش دقت اعتبارسنجی، زمان آموزش و تعداد پارامترهای قابل آموزش را بنویسید. بعد افزایش داده را به بهترین روش اضافه کنید و اثرش را بسنجید. در پایان، پنج تصویری را که بهترین مدل اشتباه تشخیص داده، ببینید و علتش را حدس بزنید.
سخن پایانی
یادگیری انتقالی دانش مدلی را که روی میلیونها تصویر آموزش دیده، به مسئلهی شما با دادهی کم منتقل میکند. در استخراج ویژگی فقط لایهی آخر آموزش میبیند و در تنظیم دقیق، لایههای آخر مدل هم با نرخ یادگیری کوچک. ResNet و MobileNet نقطههای شروع خوبیاند.
پیشپردازش باید دقیقاً با آموزش اصلی یکی باشد و افزایش داده با دادهی کم کمک بزرگی است. حملهی تخاصمی هم یادآوری میکند مدلها مثل انسان نمیبینند. برای کاربردهای حساس، آنها را در برابر ورودی دستکاریشده هم بیازمایید.
این آموزش بر پایهی درس Pre-trained Networks and Transfer Learning از مجموعهی آزاد AI for Beginners مایکروسافت (مجوز MIT) به فارسی بازنویسی و تکمیل شده است.
پرسشهای پرتکرار
یادگیری انتقالی چیست؟
یادگیری انتقالی یعنی استفاده از مدلی که روی یک مسئلهی بزرگ، مثلاً میلیونها تصویر ImageNet، آموزش دیده، برای حل مسئلهی تازهای با دادهی کم. لایههای اول مدل الگوهای عمومی مثل لبه و بافت را یاد گرفتهاند که در مسئلهی تازه هم مفیدند.
تفاوت استخراج ویژگی و تنظیم دقیق چیست؟
در استخراج ویژگی، همهی لایههای مدل آماده منجمد میمانند و فقط یک لایهی طبقهبند تازه روی خروجی آن آموزش میبیند. در تنظیم دقیق یا فاینتیون، پس از آن، بعضی یا همهی لایههای مدل آماده هم با نرخ یادگیری کوچک آموزش میبینند.
کدام مدل آماده را انتخاب کنیم؟
ResNet برای بیشتر کاربردها نقطهی شروع خوبی است. MobileNet و EfficientNet برای گوشی و دستگاههای کمتوان مناسبترند. VGG ساده است اما سنگین. برای کار جدی، چند مدل را روی دادهی اعتبارسنجی خودتان مقایسه کنید.
حمله تخاصمی چیست؟
حملهی تخاصمی تغییری بسیار کوچک و نامحسوس برای انسان در تصویر است که مدل را فریب میدهد تا پاسخ اشتباه بدهد؛ مثلاً عکس سگ را گربه تشخیص دهد. این پدیده نشان میدهد مدلهای بینایی لزوماً مثل انسان نمیبینند.
دیدگاهها
هنوز دیدگاهی ثبت نشده است. شروعکننده باشید — پرسش و اصلاح را با آغوش باز میپذیریم.