
تشخیص اشیا همان کاری است که خودروی خودران در هر لحظه انجام میدهد. فقط دانستن اینکه در تصویر عابر پیاده هست کافی نیست؛ باید بداند دقیقاً کجاست و چقدر فاصله دارد. طبقهبندی تصویر میگوید «در این عکس گربه هست». تشخیص اشیا میگوید «دو گربه هست، یکی در گوشهی بالا و یکی کنار پنجره».
در قسمتهای قبل طبقهبندی تصویر با CNN و یادگیری انتقالی را دیدیم. حالا یک قدم جلوتر میرویم. در این قسمت یاد میگیریم محل اشیا را با کادر مشخص کنیم، دقت این کار را با IoU و mAP بسنجیم و دو خانوادهی اصلی الگوریتمها را بشناسیم.
تشخیص اشیا چیست؟
خروجی یک مدل تشخیص اشیا فهرستی از تشخیصهاست. هر تشخیص سه جزء دارد؛ یک کادر محدودکننده که محل شیء را با چهار عدد نشان میدهد، یک برچسب دسته و یک امتیاز اطمینان. تعداد تشخیصها در هر تصویر میتواند صفر یا دهها باشد.
رویکرد ساده؛ کاشیبندی تصویر
سادهترین ایده این است که تصویر را به چند کاشی تقسیم کنیم و روی هر کاشی یک طبقهبند اجرا کنیم. کاشیهایی که امتیاز بالا میگیرند، شیء را دارند. این روش برای درک مسئله خوب است، اما در عمل ضعیف است.
مشکل اول این است که کادر فقط میتواند به اندازهی کاشی باشد. شیء کوچک در یک کاشی بزرگ گم میشود و شیء بزرگ در چند کاشی پخش. مشکل دوم سرعت است؛ طبقهبند باید صدها بار اجرا شود. الگوریتمهای واقعی هر دو مشکل را هوشمندانهتر حل میکنند.
کاربردهای تشخیص اشیا
تشخیص اشیا در بسیاری از محصولات دیده میشود. شمارش خودرو در دوربینهای ترافیکی، پیدا کردن محصول در قفسهی فروشگاه، تشخیص عیب در خط تولید و تشخیص پلاک خودرو از این جملهاند.
در یک سکوی آموزشی هم کاربرد دارد. مثلاً پیدا کردن محل عکس، امضا و مهر در یک گواهینامهی اسکنشده. بعد هر بخش جداگانه بررسی میشود. این کار بسیار دقیقتر از طبقهبندی کل تصویر است.
معیارهای ارزیابی؛ IoU، AP و mAP
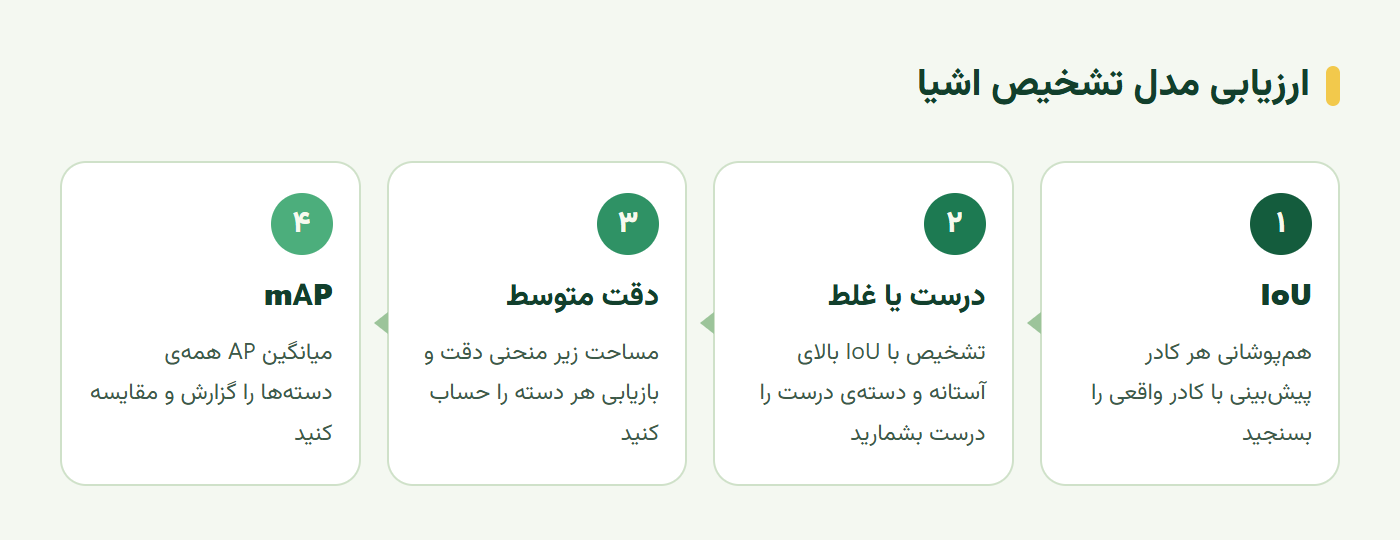
ارزیابی تشخیص اشیا از طبقهبندی سختتر است. کادر پیشبینیشده تقریباً هیچوقت دقیقاً بر کادر واقعی منطبق نیست. پس باید بسنجیم چقدر نزدیک است. نمودار زیر مسیر ارزیابی را نشان میدهد.
IoU؛ چقدر همپوشانی دارند؟
IoU یا نسبت اشتراک به اجتماع ساده است. مساحت ناحیهی مشترک دو کادر را بر مساحت کل ناحیهای که دو کادر میپوشانند تقسیم میکنیم. اگر دو کادر کاملاً یکی باشند، IoU یک است و اگر هیچ همپوشانی نداشته باشند، صفر.
def iou(a, b):
    """کادرها به شکل (x1, y1, x2, y2)"""
    ix1, iy1 = max(a[0], b[0]), max(a[1], b[1])
    ix2, iy2 = min(a[2], b[2]), min(a[3], b[3])
    inter = max(0, ix2 - ix1) * max(0, iy2 - iy1)
    area = lambda r: (r[2] - r[0]) * (r[3] - r[1])
    return inter / (area(a) + area(b) - inter)

print(round(iou((10, 10, 60, 60), (30, 30, 80, 80)), 3))
معمولاً تشخیصی با IoU بیش از ۰٫۵ درست حساب میشود. معیارهای سختگیرانهتر آستانههای بالاتر مثل ۰٫۷۵ را هم میسنجند.
دقت متوسط و mAP
برای هر دسته، تشخیصها را بر اساس امتیاز اطمینان مرتب میکنیم. با تغییر آستانهی اطمینان، دقت و بازیابی تغییر میکنند. منحنی دقت در برابر بازیابی رسم میشود و مساحت زیر آن، دقت متوسط یا AP آن دسته است.
میانگین AP همهی دستهها، mAP نام دارد و معیار اصلی مقایسهی مدلهاست. وقتی میبینید «mAP@0.5»، یعنی آستانهی IoU برای درست بودن ۰٫۵ بوده است. «mAP@0.5:0.95» میانگین روی چند آستانه از ۰٫۵ تا ۰٫۹۵ است و سختگیرانهتر.
بیشتر بخوانید: دقت مثبت، بازیابی و منحنیای که AP از آن ساخته میشود را در رگرسیون لجستیک چیست؟ برای مسئلهی دودویی دیدیم.
دو خانواده الگوریتم تشخیص اشیا
الگوریتمهای تشخیص اشیا در دو خانوادهی اصلی جا میگیرند. خانوادهی اول دومرحلهایاند و خانوادهی دوم یکمرحلهای. انتخاب بین آنها معمولاً تعادل بین دقت و سرعت است.
خانوادهی R-CNN؛ دومرحلهای
R-CNN اولین روش موفق بود. با الگوریتمی به نام جستجوی انتخابی حدود دو هزار ناحیهی احتمالی پیشنهاد میداد و هرکدام را جداگانه با CNN طبقهبندی میکرد. دقیق بود، اما بسیار کند.
Fast R-CNN سرعت را با یک ایده بالا برد؛ CNN را یک بار روی کل تصویر اجرا کرد و ناحیهها را روی نقشهی ویژگی برید. Faster R-CNN یک قدم جلوتر رفت و پیشنهاد ناحیه را هم به یک شبکهی عصبی سپرد. این خانواده هنوز در کاربردهایی که دقت از سرعت مهمتر است، رایج است.
YOLO و روشهای یکمرحلهای
YOLO یعنی «فقط یک بار نگاه کن». تصویر به یک شبکهی S در S تقسیم میشود. برای هر خانه، شبکه در یک عبور چند کادر، امتیاز اطمینان و احتمال دستهها را پیشبینی میکند. هیچ مرحلهی پیشنهاد ناحیهی جداگانهای در کار نیست.
نتیجه سرعت بسیار بالاست؛ دهها تصویر در ثانیه. به همین دلیل YOLO برای ویدئوی بلادرنگ و دستگاههای لبه محبوب است. SSD و RetinaNet هم روشهای یکمرحلهای دیگرند. نسخههای تازهی YOLO از نظر دقت هم به روشهای دومرحلهای رسیدهاند.
اجرای یک مدل آماده تشخیص اشیا
آموزش مدل تشخیص اشیا از صفر به دادهی برچسبخوردهی زیاد نیاز دارد؛ هر شیء باید با کادر مشخص شود. خوشبختانه مدلهای آمادهای روی مجموعهدادهی COCO با ۸۰ دستهی رایج آموزش دیدهاند. مثل یادگیری انتقالی، میشود از آنها شروع کرد.
Faster R-CNN با torchvision
کد زیر یک Faster R-CNN آماده را روی یک تصویر اجرا میکند و تشخیصهای با اطمینان بالا را چاپ میکند:
import torch
from torchvision.io import read_image
from torchvision.models.detection import fasterrcnn_resnet50_fpn_v2, FasterRCNN_ResNet50_FPN_V2_Weights

weights = FasterRCNN_ResNet50_FPN_V2_Weights.DEFAULT
model = fasterrcnn_resnet50_fpn_v2(weights=weights, box_score_thresh=0.7).eval()
img = read_image("street.jpg")
with torch.no_grad():
    out = model([weights.transforms()(img)])[0]

labels = weights.meta["categories"]
for box, lab, score in zip(out["boxes"], out["labels"], out["scores"]):
    print(labels[lab], round(score.item(), 2), [round(v) for v in box.tolist()])
حذف غیربیشینه
مدلها معمولاً برای یک شیء چند کادر همپوشان پیشبینی میکنند. حذف غیربیشینه یا NMS این تکرارها را پاک میکند. کادرها بر اساس امتیاز مرتب میشوند. از بالاترین امتیاز شروع میکنیم و هر کادری که IoU بالایی با آن دارد حذف میشود.
مدلهای آمادهی torchvision این کار را داخلی انجام میدهند. اما اگر خروجی خام مدلی را پردازش میکنید، torchvision.ops.nms آماده است. آستانهی IoU در NMS هم یک تصمیم است؛ برای اشیای شلوغ و نزدیک به هم، آستانهی بالاتری لازم است.
تمرین عملی؛ ارزیابی یک مدل آماده
روی چند تصویر واقعی از محیط خودتان، این کارها را انجام دهید:
- اجرای مدل: Faster R-CNN آماده را روی ده تصویر اجرا کنید و کادرها را روی تصویر رسم کنید.
- برچسب دستی: برای همین ده تصویر، کادرهای واقعی یک دسته، مثلاً «شخص»، را دستی مشخص کنید.
- IoU: برای هر تشخیص، IoU با نزدیکترین کادر واقعی را حساب کنید.
- آستانهها: تعداد تشخیص درست را با آستانهی اطمینان ۰٫۵ و ۰٫۸ مقایسه کنید.
- خطاها: سه تشخیص اشتباه را بررسی کنید و علتشان را بنویسید؛ مثلاً شیء کوچک یا نیمهپنهان.
این تمرین کوچک نشان میدهد عددهای mAP گزارششده روی COCO چقدر به تصویرهای شما منتقل میشوند.
سخن پایانی
تشخیص اشیا برای هر شیء یک کادر، یک برچسب و یک امتیاز اطمینان برمیگرداند. IoU همپوشانی کادرها را میسنجد و mAP معیار اصلی مقایسهی مدلهاست. خانوادهی R-CNN دومرحلهای و دقیق است و YOLO یکمرحلهای و بسیار سریع.
برای بیشتر پروژهها، شروع از یک مدل آماده روی COCO بهترین راه است. بعد با یادگیری انتقالی روی دادهی خودتان آن را تنظیم میکنید. حذف غیربیشینه و انتخاب درست آستانهها هم فاصلهی یک نمایش آزمایشی با یک سیستم قابل اعتماد را میسازند.
این آموزش بر پایهی درس Object Detection از مجموعهی آزاد AI for Beginners مایکروسافت (مجوز MIT) به فارسی بازنویسی و تکمیل شده است.
پرسشهای پرتکرار
تشخیص اشیا چیست؟
تشخیص اشیا وظیفهای در بینایی کامپیوتر است که همهی اشیای مورد نظر در تصویر را پیدا میکند و برای هرکدام یک کادر محدودکننده، یک برچسب دسته و یک امتیاز اطمینان برمیگرداند. برخلاف طبقهبندی، میتواند چند شیء را در یک تصویر پیدا کند.
IoU چیست؟
IoU یا نسبت اشتراک به اجتماع، میزان همپوشانی کادر پیشبینیشده با کادر واقعی را میسنجد. مساحت ناحیهی مشترک دو کادر بر مساحت کل ناحیهای که دو کادر میپوشانند تقسیم میشود. یک یعنی تطابق کامل و صفر یعنی بدون همپوشانی.
mAP در تشخیص اشیا چیست؟
mAP میانگین دقت متوسط همهی دستههاست. برای هر دسته، مساحت زیر منحنی دقت و بازیابی در یک آستانهی IoU حساب میشود و بعد بین دستهها میانگین گرفته میشود. معیار اصلی مقایسهی مدلهای تشخیص اشیاست.
تفاوت YOLO و Faster R-CNN چیست؟
Faster R-CNN دومرحلهای است؛ اول ناحیههای احتمالی را پیشنهاد میدهد و بعد هرکدام را طبقهبندی میکند. دقیق است اما کندتر. YOLO یکمرحلهای است و در یک عبور همهی کادرها و دستهها را پیشبینی میکند؛ بسیار سریع است و برای کاربردهای بلادرنگ مناسب.
دیدگاهها
هنوز دیدگاهی ثبت نشده است. شروعکننده باشید — پرسش و اصلاح را با آغوش باز میپذیریم.