
GAN چیست و چطور کامپیوتری که هیچوقت چهرهای ندیده، چهرههایی میسازد که از عکس واقعی قابل تشخیص نیستند؟ ایدهاش شبیه رقابت یک جاعل اسکناس و یک کارآگاه است. جاعل هر روز اسکناس بهتری میسازد و کارآگاه هر روز در تشخیص جعل ماهرتر میشود. در پایان، اسکناسهای جاعل تقریباً از واقعی قابل تشخیص نیستند.
در قسمت قبل دیدیم VAE با نمونهبرداری از فضای نهفته، دادهی تازه میسازد. اما تصویرهایش معمولاً تار بودند. در این قسمت GAN را میشناسیم که تصویرهای بسیار واضحتری میسازد. بعد به انتقال سبک و مدلهای امروزی تولید تصویر از متن میرسیم و یک برنامهی تولید تصویر مسئولانه طراحی میکنیم.
GAN چیست؟ دو شبکه در رقابت
شبکهی مولد تخاصمی یا GAN در سال ۲۰۱۴ معرفی شد. از دو شبکهی عصبی ساخته میشود که همزمان و در رقابت با هم آموزش میبینند. هیچکدام بهتنهایی کار نمیکند؛ ارزش در رقابت آنهاست.
مولد و تمییزدهنده
مولد یک بردار نویز تصادفی میگیرد و از آن تصویر میسازد. ساختارش شبیه رمزگشای اتوانکودر است. در ابتدا تصویرهایش چیزی جز نویز نیستند.
تمییزدهنده یک طبقهبند دودویی است. تصویری میگیرد و میگوید واقعی است یا ساختگی. ساختارش شبیه یک CNN معمولی است. در ابتدا این کار برایش آسان است، چون تصویرهای مولد بسیار بد هستند.
حلقهی آموزش GAN
آموزش GAN دو قدم متناوب دارد. در قدم اول، تمییزدهنده با یک دسته تصویر واقعی و یک دسته تصویر ساختهی مولد آموزش میبیند. هدفش این است که درست تشخیص دهد کدام کدام است.
در قدم دوم، مولد آموزش میبیند. هدفش این است که تمییزدهنده تصویرهایش را واقعی تشخیص دهد. گرادیان از تمییزدهنده به مولد برمیگردد و به مولد میگوید چطور تصویر را تغییر دهد تا واقعیتر به نظر برسد. این دو قدم هزاران بار تکرار میشوند.
چرا آموزش GAN سخت است؟
GANها به دشوار بودن آموزش مشهورند. رقابت دو شبکه تعادلی ظریف میخواهد و بهراحتی به هم میخورد. شناختن مشکلات رایج کمک میکند بفهمید چرا مدلهای تازهتر جای GAN را گرفتند.
فروپاشی حالت و ناپایداری
فروپاشی حالت رایجترین مشکل است. مولد یاد میگیرد یک یا چند تصویر محدود بسازد که تمییزدهنده را فریب میدهند. بعد دیگر سراغ تنوع نمیرود. نتیجه GANی است که فقط یک چهره یا یک رقم میسازد.
مشکل دوم حساسیت به ابرپارامترهاست. گاهی GAN اصلاً همگرا نمیشود و بعد ناگهان با تغییر کوچک نرخ یادگیری همگرا میشود. مشکل سوم تعادل است. اگر تمییزدهنده خیلی سریع قوی شود، گرادیانی برای مولد نمیماند و آموزش متوقف میشود.
تولید تصویر با وضوح بالا
ساختن تصویر پروضوح هم سخت است. هرچه تعداد پیکسلها بیشتر، یادگیری سختتر. معماریهایی مثل StyleGAN با آموزش تدریجی از وضوح کم به زیاد، این مشکل را تا حد زیادی حل کردند.
StyleGAN چهرههایی ساخت که از عکس واقعی قابل تشخیص نبودند. همین توانایی نگرانیهای جدی دربارهی جعل عمیق یا دیپفیک به وجود آورد. در بخش آخر این قسمت به این نگرانیها برمیگردیم.
بیشتر بخوانید: فضای نهفته و VAE را که ایدهی ساختن داده از نویز از آن شروع شد، در اتوانکودر چیست؟ دیدیم.
انتقال سبک؛ هنر با شبکه عصبی
انتقال سبک روش جالب دیگری برای تولید تصویر است. محتوای یک تصویر را با سبک هنری تصویر دیگر ترکیب میکند. مثلاً عکس یک خیابان تهران به سبک نقاشی ون گوگ. برخلاف GAN، به آموزش مدل تازه نیاز ندارد و از یک CNN آماده استفاده میکند.
خطای محتوا و خطای سبک
از یک تصویر شروع میکنیم و آن را با نزول گرادیان تغییر میدهیم تا دو خطا کم شوند. خطای محتوا ویژگیهای لایههای عمیق CNN را بین تصویر فعلی و تصویر محتوا مقایسه میکند. پس ساختار و اشیا حفظ میشوند.
خطای سبک از ماتریس گرام استفاده میکند. این ماتریس همبستگی بین ویژگیهای مختلف یک لایه را نشان میدهد و اطلاعات بافت و رنگ را بدون مکان دقیق نگه میدارد. یک خطای نرمی هم اضافه میشود تا تصویر نهایی نویز کمتری داشته باشد.
از انتقال سبک تا مدلهای امروزی
انتقال سبک نشان داد CNN آماده چقدر دربارهی تصویر میداند. اما کند است؛ برای هر تصویر باید بهینهسازی جداگانه اجرا شود. نسلهای بعدی این کار را در یک عبور سریع انجام دادند.
امروز بیشتر تولید تصویر با مدلهای انتشار یا Diffusion و مدلهای مبتنی بر ترنسفورمر انجام میشود. این مدلها تصویر را در چند قدم از نویز پاک میکنند و با متن هدایت میشوند. پایدارتر از GAN آموزش میبینند و تنوع بیشتری دارند.
ساخت برنامه تولید تصویر از متن
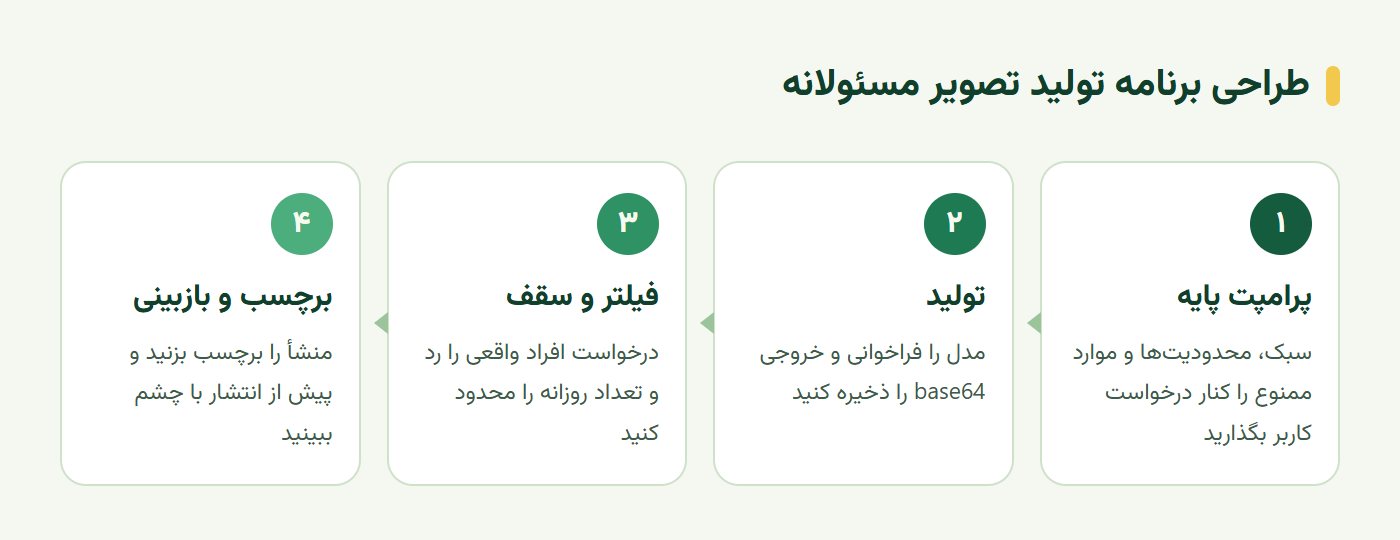
حالا از نظریه به محصول میرسیم. مدلهای تولید تصویر از متن، تصویر را از یک توضیح میسازند. برای یک سکوی آموزشی، این قابلیت میتواند تصویر مفهومی برای درس بسازد. نمودار زیر چهار قدم طراحی چنین برنامهای را نشان میدهد.
فراخوانی مدل تولید تصویر
بیشتر سرویسها رابط مشابهی دارند. کد زیر با کتابخانهی openai یک تصویر میسازد. مدلهای تازهی تولید تصویر خروجی را بهصورت base64 برمیگردانند، نه نشانی اینترنتی:
import base64
import os
from openai import OpenAI

client = OpenAI()
prompt = "Simple flat illustration of a teacher explaining a neural network on a green chalkboard, no text"
result = client.images.generate(model=os.environ["IMAGE_MODEL"], prompt=prompt, size="1024x1024")

with open("lesson.png", "wb") as f:
    f.write(base64.b64decode(result.data[0].b64_json))
پرامپت پایه و محدودیتها
کاربران پرامپت را آزاد مینویسند. اما برنامه باید چارچوب مشخصی داشته باشد. یک پرامپت پایه یا فراپرامپت کنار درخواست کاربر اضافه کنید. مثلاً «سبک ساده و آموزشی، بدون متن، مناسب همهی سنین، بدون چهرهی افراد واقعی».
عبارت «بدون متن» مهم است. بیشتر مدلها متن فارسی را درست نمینویسند و حروف بههمریخته تولید میکنند. متن را بعداً با ابزار طراحی روی تصویر بگذارید. هزینه هم مهم است؛ هر تصویر هزینه دارد. برای جلوگیری از سوءاستفاده، سقف تعداد درخواست برای هر کاربر تعیین کنید.
تولید تصویر مسئولانه
توانایی ساختن تصویر واقعینما، مسئولیت میآورد. هر برنامهی تولید تصویر باید از روز اول برای سوءاستفاده طراحی شود. نه به این دلیل که کاربران بدنیتاند، بلکه چون در مقیاس بزرگ، حتی درصد کمی سوءاستفاده آسیب واقعی میزند.
جعل عمیق و حقوق مالکیت
جعل عمیق یعنی ساختن تصویر یا ویدئوی ساختگی از افراد واقعی. این کار میتواند برای فریب، آزار یا انتشار اخبار جعلی استفاده شود. برنامهی شما باید درخواست ساخت تصویر افراد واقعی را رد کند و فیلتر محتوای سرویس را فعال نگه دارد.
حقوق مالکیت هم مسئله است. درخواست «به سبک فلان هنرمند زنده» ممکن است حقوق آن هنرمند را نادیده بگیرد. قوانین در این حوزه هنوز در حال شکلگیریاند. سیاست روشنی بنویسید و به کاربر نشان دهید.
نشانهگذاری و بازبینی
تصویر ساختهشده با هوش مصنوعی را برچسب بزنید. استانداردهایی مثل C2PA اطلاعات منشأ را در فایل تصویر ذخیره میکنند. در سکوی آموزشی، یک برچسب سادهی «تصویر مفهومی ساختهشده با هوش مصنوعی» کنار تصویر هم کمک میکند.
برای محتوای حساس، بازبینی انسانی پیش از انتشار لازم است. تصویرهایی که برای یک درس ساخته میشوند، باید پیش از انتشار با چشم دیده شوند. مدلها گاهی جزئیات نادرست یا نامناسبی میسازند که فقط انسان متوجهاش میشود.
تمرین عملی؛ طراحی برنامه تولید تصویر آموزشی
برای یک قابلیت «تصویر مفهومی درس» در سکوی آموزشی، این طرح را بنویسید:
- پرامپت پایه: سبک، محدودیتها و موارد ممنوع را در یک پاراگراف بنویسید.
- ده پرامپت آزمون: پنج درخواست عادی و پنج درخواست مرزی، مثل چهرهی افراد مشهور، طراحی کنید.
- رفتار مورد انتظار: برای هر پرامپت آزمون بنویسید برنامه باید چه کند؛ بسازد، رد کند یا اصلاح کند.
- هزینه و سقف: هزینهی هر تصویر و سقف روزانهی هر کاربر را تعیین کنید.
- برچسب و بازبینی: مشخص کنید چه تصویرهایی پیش از انتشار بازبینی انسانی میخواهند.
اگر دسترسی به یک سرویس تولید تصویر دارید، ده پرامپت را اجرا کنید و نتیجه را با رفتار مورد انتظار مقایسه کنید.
سخن پایانی
GAN با رقابت یک مولد و یک تمییزدهنده، تصویرهایی میسازد که در دنیا وجود ندارند. آموزشش به خاطر فروپاشی حالت، ناپایداری و تعادل ظریف دو شبکه سخت است. انتقال سبک هم نشان داد CNN آماده چقدر دربارهی محتوا و سبک تصویر میداند.
امروز مدلهای انتشار و ترنسفورمر بیشتر کار تولید تصویر از متن را انجام میدهند. برنامهای که با آنها میسازید، به پرامپت پایه، سقف هزینه، فیلتر محتوا، برچسب منشأ و بازبینی انسانی نیاز دارد. قدرت تولید تصویر بدون این محافظها، ریسک است.
این آموزش بر پایهی درس Generative Adversarial Networks از مجموعهی آزاد AI for Beginners و درس Building Image Generation Applications از مجموعهی Generative AI for Beginners مایکروسافت (مجوز MIT) به فارسی بازنویسی و تکمیل شده است.
پرسشهای پرتکرار
GAN چیست؟
GAN یا شبکهی مولد تخاصمی از دو شبکهی عصبی ساخته میشود که با هم رقابت میکنند. مولد از نویز تصادفی تصویر میسازد و تمییزدهنده تلاش میکند تصویر واقعی را از ساختگی تشخیص دهد. با این رقابت، مولد بهتدریج تصویرهای واقعیتری میسازد.
فروپاشی حالت در GAN یعنی چه؟
یعنی مولد یاد میگیرد فقط یک یا چند تصویر محدود بسازد که تمییزدهنده را فریب میدهند و تنوع دادهی واقعی را از دست میدهد. مثلاً GANی که باید همهی ارقام را بسازد، فقط رقم یک تولید میکند.
تفاوت GAN با مدلهای انتشار چیست؟
GAN در یک قدم از نویز تصویر میسازد و آموزشش ناپایدار است. مدلهای انتشار یا Diffusion تصویر را در چند قدم از نویز پاک میکنند، پایدارتر آموزش میبینند و تنوع بیشتری دارند. بیشتر مدلهای امروزی تولید تصویر از متن بر پایهی انتشار یا ترنسفورمرند.
انتقال سبک چیست؟
انتقال سبک روشی است که محتوای یک تصویر را با سبک هنری تصویر دیگر ترکیب میکند؛ مثلاً عکس یک خیابان به سبک نقاشی ون گوگ. با بهینهسازی تصویر برای کم کردن همزمان خطای محتوا و خطای سبک انجام میشود.
دیدگاهها
هنوز دیدگاهی ثبت نشده است. شروعکننده باشید — پرسش و اصلاح را با آغوش باز میپذیریم.