
هوش مصنوعی چندوجهی همان چیزی است که وقتی عکس یک برگهی امتحان را برای دستیار میفرستید و میپرسید «سؤال سوم را چطور حل کنم؟»، به کارتان میآید. دستیار باید عکس را ببیند، متن را بخواند و سؤال شما را بفهمد. تا چند سال پیش، این سه کار را سه مدل جداگانه انجام میدادند. امروز یک مدل همه را با هم انجام میدهد.
در قسمتهای قبل بینایی کامپیوتر را از طبقهبندی تا بخشبندی دیدیم. این قسمت آخرین قسمت بخش بینایی است و پلی به بخش پردازش زبان. در این قسمت میبینیم تصویر و متن چطور در یک فضای مشترک قرار میگیرند. بعد یک دستیار چندوجهی طراحی میکنیم که به شواهد تصویر وفادار بماند.
هوش مصنوعی چندوجهی چیست؟
وجه یا Modality در اینجا یعنی نوع داده؛ تصویر، متن، صدا یا ویدئو. سیستم چندوجهی بیش از یک وجه را همزمان پردازش میکند. انسان ذاتاً چندوجهی است. وقتی کسی حرف میزند، هم کلماتش را میشنوید و هم حالت چهرهاش را میبینید.
چرا ترکیب وجهها سخت بود؟
مدلهای بینایی و مدلهای زبانی سالها جدا از هم رشد کردند. هرکدام بازنمایی خودش را داشت. بردار ویژگی یک CNN و بردار یک کلمه در دو فضای کاملاً متفاوت بودند. مقایسهی مستقیمشان معنایی نداشت.
برای ترکیب، باید این دو فضا را به هم وصل کرد. یعنی تصویر گربه و کلمهی «گربه» به بردارهای نزدیک به هم تبدیل شوند. کلید این کار دادهی جفتشده بود؛ میلیونها تصویر همراه توضیح متنی که در اینترنت فراوان است.
از CLIP تا مدلهای بینایی-زبانی
CLIP در سال ۲۰۲۱ این پل را ساخت. دو رمزگذار دارد؛ یکی برای تصویر و یکی برای متن. هر دو خروجی خود را در یک فضای برداری مشترک قرار میدهند. پس میشود شباهت تصویر و متن را مستقیم حساب کرد.
نسل بعدی، مدلهای بینایی-زبانیاند. این مدلها تصویر را مستقیم به ورودی یک مدل زبانی بزرگ وصل میکنند. حالا مدل میتواند دربارهی تصویر گفتوگو کند، جدول داخل عکس را بخواند یا نمودار را توضیح دهد. بیشتر مدلهای زبانی بزرگ امروزی این توانایی را دارند.
CLIP چطور کار میکند؟
ایدهی CLIP ساده و هوشمندانه است. مدل با یادگیری مقایسهای آموزش میبیند. در هر دسته، چند صد تصویر و توضیح متنیشان هست. مدل یاد میگیرد هر تصویر را به توضیح خودش نزدیک و از بقیهی توضیحها دور کند.
یادگیری مقایسهای روی جفتهای تصویر و متن
در یک دسته با N جفت، یک ماتریس N در N از شباهتها ساخته میشود. قطر این ماتریس جفتهای درستاند و بقیهی خانهها جفتهای نادرست. هدف آموزش این است که قطر بزرگ و بقیه کوچک باشند.
پس از آموزش روی صدها میلیون جفت، دو رمزگذار فضای مشترکی ساختهاند که در آن معنا کنار معناست. تصویر یک سگ در ساحل به متن «سگی که در ساحل میدود» نزدیک است، حتی اگر این جملهی دقیق هرگز در دادهی آموزش نبوده باشد.
طبقهبندی بدون نمونه
یکی از کاربردهای شگفتانگیز CLIP، طبقهبندی بدون نمونه است. فرض کنید میخواهید عکسهای ارسالی را به «گواهینامه»، «کارت شناسایی» و «فیش پرداخت» دستهبندی کنید. هیچ نمونهی برچسبخوردهای ندارید.
با CLIP کافی است این سه عبارت را بهصورت متن بدهید. مدل تصویر را به دستهای نسبت میدهد که بردار متنش بیشترین شباهت را دارد:
from PIL import Image
from transformers import CLIPModel, CLIPProcessor

model = CLIPModel.from_pretrained("openai/clip-vit-base-patch32")
proc = CLIPProcessor.from_pretrained("openai/clip-vit-base-patch32")
labels = ["a photo of a certificate", "a photo of an ID card", "a photo of a payment receipt"]

inputs = proc(text=labels, images=Image.open("upload.jpg"), return_tensors="pt", padding=True)
probs = model(**inputs).logits_per_image.softmax(dim=1)[0]
print({l: round(p.item(), 3) for l, p in zip(labels, probs)})
عبارت «a photo of» پیش از هر برچسب تصادفی نیست. CLIP با توضیحهایی از این شکل آموزش دیده است. پس این قالب معمولاً دقت را بالا میبرد.
بیشتر بخوانید: ایجنتی که با یک مدل بینایی تصویر را تحلیل میکند و ابزار صدا میزند را در ایجنت تحلیل تصویر با کد ساختهایم.
تولید تصویر با CLIP؛ ایده VQGAN
CLIP فقط برای فهمیدن نیست؛ میتواند تولید را هم هدایت کند. ترکیب VQGAN و CLIP یکی از اولین روشهای محبوب تولید تصویر از متن بود. ایدهاش شبیه انتقال سبک است که در قسمت GAN دیدیم.
بهینهسازی تصویر با راهنمای CLIP
VQGAN یک مولد تصویر است که از یک کد نهفته، تصویر میسازد. از یک کد تصادفی شروع میکنیم. تصویر ساختهشده را به CLIP میدهیم و شباهتش با متن مورد نظر را حساب میکنیم. بعد با نزول گرادیان، کد نهفته را طوری تغییر میدهیم که این شباهت بیشتر شود.
پس از صدها قدم، تصویری ساخته میشود که CLIP آن را شبیه متن میداند. این تصویرها اغلب رؤیاگونه و عجیب بودند، اما نشان دادند فضای مشترک تصویر و متن چقدر قدرتمند است. مدلهای امروزی تولید تصویر از متن، از همین ایدهی هدایت با متن استفاده میکنند.
محدودیتهای CLIP
CLIP سوگیریهای دادهی اینترنتی را به ارث برده است. ممکن است بعضی گروهها را با برچسبهای کلیشهای مرتبط کند. پیش از استفاده در تصمیمهای مربوط به افراد، باید با دقت ارزیابی شود.
CLIP در شمردن اشیا، خواندن متن دقیق و فهم رابطههای مکانی هم ضعیف است. «گربه روی میز» و «میز روی گربه» برایش تقریباً یکساناند. برای این کارها، مدلهای بینایی-زبانی بزرگتر مناسبترند.
طراحی دستیار چندوجهی وفادار به شواهد
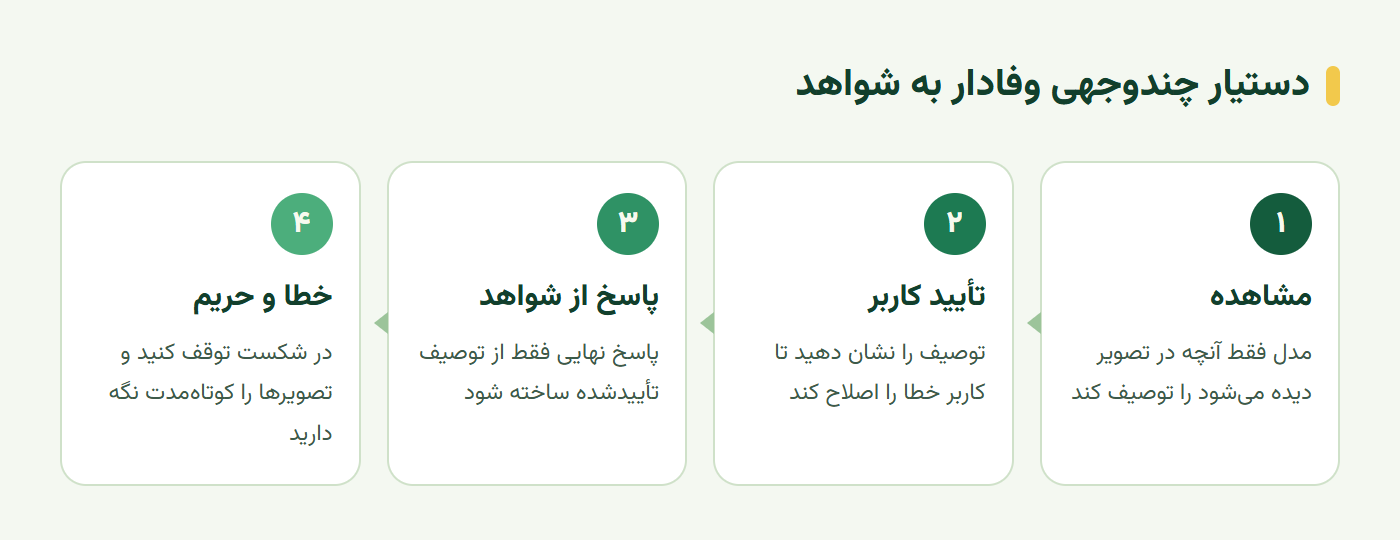
حالا یک دستیار چندوجهی طراحی میکنیم. در درس اصلی، برنامهای عکس حیوان خانگی را میگیرد و دربارهاش داستان مینویسد. ساختار این برنامه درس مهمی دارد؛ کار در دو مرحلهی جدا انجام میشود. نمودار زیر این دو مرحله را نشان میدهد.
مرحلهی اول؛ فقط مشاهده
در مرحلهی اول، مدل بینایی-زبانی فقط آنچه در تصویر میبیند را توصیف میکند. دستور صریح این است: «فقط چیزهایی را که در تصویر دیده میشود بنویس؛ حدس نزن.» این توصیف به کاربر نشان داده میشود و در فرم ذخیره میشود.
کاربر میتواند توصیف را ببیند و اگر اشتباه است، اصلاحش کند. مثلاً مدل نژاد سگ را اشتباه گفته است. این قدم ساده، خطای مدل بینایی را پیش از رسیدن به پاسخ نهایی قابل مشاهده و اصلاح میکند.
مرحلهی دوم؛ پاسخ فقط از شواهد
در مرحلهی دوم، پاسخ یا داستان فقط بر اساس توصیف تأییدشده ساخته میشود. مدل دیگر تصویر را نمیبیند؛ فقط متن توصیف را. پس نمیتواند چیزی بسازد که در توصیف نیست.
این جداسازی مشاهده از تفسیر، اصل مهمی در همهی دستیارهای چندوجهی است. اگر پاسخ اشتباه بود، میدانید خطا از کجا آمده؛ از مشاهده یا از تفسیر. هر مرحله را هم جداگانه میشود آزمود. برای برگهی امتحان هم همینطور است؛ اول متن سؤال از عکس استخراج و به کاربر نشان داده میشود، بعد حل میشود.
مدیریت خطا و حریم خصوصی
اگر مدل در مرحلهی اول شکست بخورد، برنامه باید خطای روشن نشان دهد و مرحلهی دوم را اجرا نکند. تولید پاسخ بدون توصیف معتبر، یعنی دعوت به ساختن پاسخ ساختگی.
تصویرها معمولاً اطلاعات شخصی دارند؛ چهره، آدرس یا شمارهی کارت. پیش از فرستادن تصویر به سرویس بیرونی، به کاربر اطلاع دهید. تصویرها را فقط تا زمانی که لازم است نگه دارید، همانطور که در قسمت اخلاق داده گفتیم.
تمرین عملی؛ طبقهبند بدون نمونه و دستیار دومرحلهای
این دو تمرین را انجام دهید:
- طبقهبندی بدون نمونه: با CLIP بیست عکس از سه نوع سند را بدون هیچ آموزشی دستهبندی کنید و دقت را حساب کنید.
- اثر عبارت: به جای «certificate» عبارت «a photo of a certificate» را امتحان کنید و تفاوت دقت را ببینید.
- مرحلهی مشاهده: یک دستور بنویسید که مدل فقط محتوای دیدنی یک عکس را فهرست کند.
- مرحلهی پاسخ: دستور دوم را طوری بنویسید که فقط از فهرست مرحلهی اول استفاده کند.
- آزمون خطا: یک توصیف را عمداً اشتباه کنید و ببینید پاسخ نهایی چطور تغییر میکند.
آزمون آخر نشان میدهد وقتی مشاهده و تفسیر جدا هستند، ردیابی خطا چقدر آسانتر است.
سخن پایانی
هوش مصنوعی چندوجهی تصویر و متن را در یک فضای مشترک میفهمد. CLIP با یادگیری مقایسهای روی جفتهای تصویر و متن، این فضا را ساخت و طبقهبندی بدون نمونه را ممکن کرد. ترکیبش با VQGAN هم نشان داد متن میتواند تولید تصویر را هدایت کند.
مدلهای بینایی-زبانی امروزی دربارهی تصویر گفتوگو میکنند. اما برای ساختن دستیار قابل اعتماد، مشاهده را از تفسیر جدا کنید. اول آنچه دیده میشود ثبت و تأیید شود، بعد پاسخ فقط از همان شواهد ساخته شود.
این آموزش بر پایهی درس Multi-Modal Networks از مجموعهی آزاد AI for Beginners و نمونهی Pet Story از مجموعهی Generative AI for Beginners Java مایکروسافت (مجوز MIT) به فارسی بازنویسی و تکمیل شده است.
پرسشهای پرتکرار
هوش مصنوعی چندوجهی چیست؟
هوش مصنوعی چندوجهی سیستمی است که بیش از یک نوع داده را همزمان میفهمد یا تولید میکند؛ مثل تصویر و متن، یا صدا و متن. مثلاً میتواند عکسی را ببیند و دربارهاش به سؤال متنی جواب دهد.
CLIP چیست؟
CLIP مدلی از OpenAI است که روی میلیونها جفت تصویر و متن آموزش دیده تا تصویر و توضیح متنی آن را به بردارهای نزدیک در یک فضای مشترک تبدیل کند. با آن میشود بدون آموزش اضافه، تصویر را با هر فهرست دلخواه از برچسبهای متنی طبقهبندی کرد.
طبقهبندی بدون نمونه یعنی چه؟
یعنی مدل دستههایی را تشخیص دهد که هیچ نمونهی برچسبخوردهای از آنها ندیده است. در CLIP کافی است نام دستهها را بهصورت متن بدهید؛ مدل تصویر را به دستهای نسبت میدهد که بردار متنش بیشترین شباهت را دارد.
چطور مطمئن شویم دستیار چندوجهی از تصویر چیزی نمیسازد؟
کار را دو مرحله کنید. اول مدل فقط آنچه در تصویر میبیند را توصیف کند و این توصیف ذخیره و به کاربر نشان داده شود. بعد پاسخ نهایی فقط بر اساس همین توصیف تأییدشده ساخته شود. این جداسازی مشاهده از تفسیر، خطا را قابل ردیابی میکند.
دیدگاهها
هنوز دیدگاهی ثبت نشده است. شروعکننده باشید — پرسش و اصلاح را با آغوش باز میپذیریم.