
پردازش زبان طبیعی چیست و چرا جملهای که هر کودک پنجسالهای میفهمد، سالها کامپیوترها را گیج میکرد؟ جملهی «کلاس فردا تشکیل نمیشه؟» را در نظر بگیرید. محاورهای است، فعلش شکسته است و آهنگش پرسشی است. معلوم نیست گوینده میپرسد یا تعجب میکند. انسان از بافت میفهمد؛ کامپیوتر باید یاد بگیرد.
در بخش قبل بینایی کامپیوتر را دیدیم. از این قسمت وارد پردازش زبان طبیعی میشویم؛ بخشی که قلب هر دستیار گفتوگو است. در این قسمت وظایف اصلی NLP را میشناسیم، سیر تحولش را مرور میکنیم و چالشهای ویژهی زبان فارسی را میبینیم. در پایان یک نقشهی راه برای چند قسمت بعدی داریم.
پردازش زبان طبیعی چیست؟
پردازش زبان طبیعی یا NLP شاخهای از هوش مصنوعی است که به کامپیوتر یاد میدهد زبان انسان را بفهمد و تولید کند. «طبیعی» در برابر زبانهای برنامهنویسی است که قواعد دقیق و بیابهام دارند. زبان انسان پر از ابهام، استثنا و وابستگی به بافت است.
زبانشناسی محاسباتی
پیش از NLP مبتنی بر یادگیری ماشین، حوزهای به نام زبانشناسی محاسباتی سالها روی این مسئله کار میکرد. زبانشناسان قواعد دستوری را صریح مینوشتند و برنامهها جمله را بر اساس آنها تجزیه میکردند. مثلاً فاعل، فعل و مفعول را پیدا میکردند.
این رویکرد برای جملههای ساده و رسمی خوب کار میکرد. اما زبان واقعی پر از استثناست. هر قاعدهی تازه، استثنای تازهای میساخت. همان مشکلی که در قسمت سوم دربارهی سیستمهای خبره دیدیم، اینجا هم تکرار شد.
وظایف اصلی NLP
NLP یک وظیفهی واحد نیست؛ مجموعهای از وظایف است که هرکدام سؤال متفاوتی میپرسد. بعضی متن را میفهمند، مثل دستهبندی و تحلیل احساس. بعضی اطلاعات مشخصی را بیرون میکشند، مثل استخراج نام و تاریخ. و بعضی متن تازه تولید میکنند، مثل ترجمه و خلاصهسازی.
یک دستیار واقعی معمولاً چند وظیفه را پشت سر هم انجام میدهد. اول موضوع پیام را تشخیص میدهد، بعد نام دوره را از آن بیرون میکشد و در پایان پاسخ را مینویسد. جدول زیر مهمترین وظایف را با مثال در دستیار آموزشی نشان میدهد.
| وظیفه | سؤال | مثال در دستیار آموزشی |
|---|---|---|
| دستهبندی متن | این متن از چه نوعی است؟ | تشخیص موضوع پیام پشتیبانی |
| تحلیل احساس | لحن متن مثبت است یا منفی؟ | شناسایی دانشجوی ناراضی |
| استخراج موجودیت | چه نامها و تاریخهایی در متن است؟ | استخراج نام دوره و تاریخ کلاس |
| پاسخ به پرسش | پاسخ این سؤال در متن کجاست؟ | یافتن پاسخ در آییننامه |
| خلاصهسازی | خلاصهی این متن چیست؟ | خلاصهی بازخوردهای یک دوره |
| ترجمه و تولید متن | این را به زبان دیگر یا شکل تازه بنویس | پیشنویس پاسخ به ایمیل |
سیر تحول پردازش زبان طبیعی
NLP سه دورهی اصلی را پشت سر گذاشته است. هر دوره محدودیتهای دورهی قبل را حل کرد. شناختن این مسیر کمک میکند بفهمید چرا روشهای امروزی اینطور کار میکنند.
از ELIZA و آزمون تورینگ تا قاعده
در دههی ۱۹۶۰، برنامهای به نام ELIZA نقش یک رواندرمانگر را بازی میکرد. قاعدههایش ساده بودند؛ کلمههای کلیدی را پیدا میکرد و جملهی کاربر را به سؤال برمیگرداند. «من ناراحتم» به «چرا ناراحتی؟» تبدیل میشد. بعضی کاربران باور کردند با انسان حرف میزنند.
ELIZA هیچچیز نمیفهمید، اما نشان داد مردم چقدر راحت به ماشین ویژگی انسانی نسبت میدهند. همان درسی که در قسمت اول دربارهی آزمون تورینگ گرفتیم. پاسخ روان و قانعکننده با فهمیدن یکی نیست.
از آمار تا شبکهی عصبی
در دهههای بعد، روشهای آماری جای قاعده را گرفتند. به جای نوشتن قاعده، از شمارش کلمات در متنهای زیاد الگو استخراج شد. ترجمهی ماشینی آماری، کلمات را بر اساس احتمال همآیی در متنهای ترجمهشده جفت میکرد. کتابخانهی NLTK بسیاری از این روشها را پیاده کرده است.
دورهی سوم با شبکههای عصبی شروع شد. بازنمایی برداری کلمات، شبکههای بازگشتی و در نهایت ترنسفورمرها، NLP را متحول کردند. امروز مدلهای زبانی بزرگ بیشتر وظایف جدول بالا را با یک مدل واحد انجام میدهند. قسمتهای بعدی این مجموعه همین مسیر را قدمبهقدم میروند.
بیشتر بخوانید: ماجرای ELIZA، آزمون تورینگ و چتبات Eugene Goostman را در هوش مصنوعی چیست؟ بیشتر توضیح دادهایم.
چالشهای پردازش زبان فارسی
بیشتر آموزشها و ابزارهای NLP برای انگلیسی ساخته شدهاند. فارسی چالشهای خاص خودش را دارد که اگر نشناسید، مدل شما بیصدا ضعیف کار میکند.
نیمفاصله، حروف و ارقام
نیمفاصله مشهورترین چالش است. «میروم» ممکن است به شکل «میروم» یا «می روم» هم نوشته شود. برای کامپیوتر این سه کلمهی متفاوتاند. «کتابها» و «کتابها» و «کتاب ها» هم همینطور.
حروف همشکل عربی و فارسی چالش دوم است. «ی» فارسی و «ي» عربی، یا «ک» و «ك»، در ظاهر یکساناند اما کد متفاوت دارند. ارقام فارسی، عربی و لاتین هم مشکل مشابهی دارند. کتابخانههایی مثل Hazm اینها را یکدست میکنند:
from hazm import Normalizer, word_tokenize

norm = Normalizer()
text = norm.normalize("كلاس هاي فردا ساعت ۱۰ تشكيل ميشن؟")
print(text)
print(word_tokenize(text))
زبان محاوره و کمبود داده
فارسی نوشتاری و محاورهای فاصلهی زیادی دارند. «میخواهم» در محاوره «میخوام» میشود و «نمیشود» به «نمیشه» تبدیل میشود. کاربران دستیار تقریباً همیشه محاورهای مینویسند، اما بیشتر دادهی آموزشی از متن رسمی است.
چالش دیگر کمبود دادهی برچسبخورده است. برای انگلیسی میلیونها نمونهی برچسبخورده برای هر وظیفه هست. برای فارسی خیلی کمتر. خوشبختانه مدلهای چندزبانه و یادگیری انتقالی این فاصله را تا حد زیادی کم کردهاند.
نقشه راه NLP برای ساخت دستیار
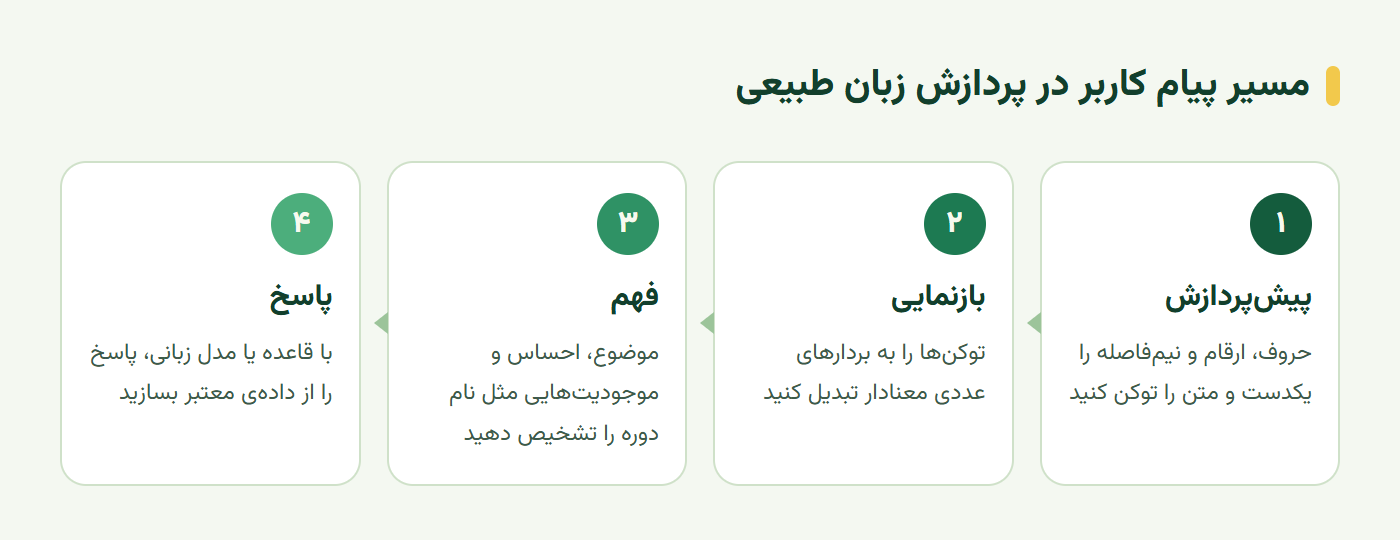
حالا که وظایف و چالشها را میشناسیم، ببینیم یک پیام کاربر در دستیار آموزشی چه مسیری را طی میکند تا به پاسخ برسد. این مسیر نقشهی راه چند قسمت بعدی است. نمودار زیر چهار قدم اصلی آن را نشان میدهد.
از پیام خام تا فهم
قدم اول پیشپردازش است؛ یکدستسازی حروف و نیمفاصله و تقسیم متن به توکن. قدم دوم بازنمایی است؛ تبدیل توکنها به بردار عددی که معنا را نگه دارد. این دو قدم موضوع دو قسمت بعدیاند.
قدم سوم فهم است؛ دستهبندی موضوع، تشخیص احساس و استخراج موجودیتهایی مثل نام دوره و تاریخ. مدلهایی که این کار را انجام میدهند، از شبکههای بازگشتی تا ترنسفورمر، در قسمتهای میانی این بخش میآیند.
از فهم تا پاسخ
قدم چهارم تولید پاسخ است. ممکن است یک قاعدهی ساده باشد؛ اگر موضوع «ساعت کلاس» است، از تقویم بخوان. یا ممکن است یک مدل زبانی باشد که پاسخ را از روی اسناد مینویسد. انتخاب بین این دو همان تصمیم «قاعده یا یادگیری» است که از قسمت سوم با آن آشنا هستید.
یک ربات بسیار سادهی ELIZA مانند، هر چهار قدم را در شکل ابتدایی نشان میدهد. پیام را نرمال میکند، کلمهی کلیدی را پیدا میکند و پاسخ از پیش نوشته را برمیگرداند. هر قسمت بعدی یکی از این قدمها را هوشمندتر میکند.
تمرین عملی؛ نقشهی NLP دستیار خودتان
بیست پیام واقعی کاربران را از دستیار یا پشتیبانی خودتان جمع کنید و این کارها را انجام دهید:
- وظیفه: برای هر پیام بنویسید کدام وظیفهی NLP لازم است؛ دستهبندی، استخراج موجودیت یا پاسخ به پرسش.
- چالش فارسی: پیامهایی را که نیمفاصلهی نادرست، حروف عربی یا محاوره دارند علامت بزنید.
- نرمالسازی: همه را با Hazm نرمال کنید و تفاوت را ببینید.
- قاعده یا مدل: برای هر وظیفه تصمیم بگیرید قاعدهی ساده کافی است یا مدل لازم است.
این جدول نقشهی راه شخصی شما برای بخش NLP است. در هر قسمت بعدی یکی از ستونهایش را کاملتر میکنید.
سخن پایانی
پردازش زبان طبیعی به کامپیوتر یاد میدهد زبان انسان را بفهمد و تولید کند. از قاعدههای دستوری زبانشناسی محاسباتی شروع شد، به روشهای آماری رسید و امروز با شبکههای عصبی و ترنسفورمرها بیشتر وظایف را با یک مدل انجام میدهد.
فارسی چالشهای خاص خودش را دارد؛ نیمفاصله، حروف همشکل، فاصلهی نوشتار و محاوره و کمبود داده. نقشهی راه ما چهار قدم دارد؛ پیشپردازش، بازنمایی، فهم و پاسخ. قسمتهای بعدی هر قدم را از نزدیک میسازند.
این آموزش بر پایهی درسهای Natural Language Processing از مجموعهی AI for Beginners و Introduction to natural language processing از مجموعهی ML for Beginners مایکروسافت (مجوز MIT) به فارسی بازنویسی و تکمیل شده است.
پرسشهای پرتکرار
پردازش زبان طبیعی چیست؟
پردازش زبان طبیعی یا NLP شاخهای از هوش مصنوعی است که به کامپیوتر یاد میدهد زبان انسان را بفهمد، تحلیل کند و تولید کند. دستهبندی متن، تحلیل احساس، ترجمه، خلاصهسازی، پاسخ به پرسش و تولید متن از وظایف آناند.
چرا پردازش زبان فارسی سختتر است؟
فارسی چالشهای خاص خودش را دارد؛ نیمفاصله که گاهی فاصله یا بیفاصله نوشته میشود، حروف عربی و فارسی همشکل مثل ی و ي، تفاوت زیاد زبان نوشتاری و محاورهای، و دادهی آموزشی برچسبخوردهی کمتر نسبت به انگلیسی.
تفاوت NLP کلاسیک و NLP با شبکه عصبی چیست؟
NLP کلاسیک بر قاعدههای دستوری و آمار شمارش کلمات تکیه داشت و برای هر وظیفه ویژگیها با دست طراحی میشد. NLP مبتنی بر شبکهی عصبی، بهویژه ترنسفورمرها، بازنمایی معنا را از حجم عظیم متن خودش یاد میگیرد و در بیشتر وظایف بسیار دقیقتر است.
برای شروع NLP با پایتون از چه کتابخانههایی استفاده کنیم؟
برای مفاهیم پایه NLTK و TextBlob سادهاند. برای فارسی Hazm و Parsivar نرمالسازی و توکنسازی دارند. برای مدلهای امروزی کتابخانهی Transformers از Hugging Face استاندارد است و هزاران مدل آماده، از جمله مدلهای فارسی، دارد.
دیدگاهها
هنوز دیدگاهی ثبت نشده است. شروعکننده باشید — پرسش و اصلاح را با آغوش باز میپذیریم.