
پیشپردازش متن جایی است که بیشتر تصمیمهای پنهان پروژهی NLP گرفته میشود. فرض کنید در پاکسازی، کلمات پرتکرار مثل «نه» و «نمی» را حذف کردهاید. حالا جملهی «این دوره اصلاً خوب نبود» برای مدل تبدیل میشود به «دوره اصلاً خوب». مدل تحلیل احساس با اطمینان میگوید نظر مثبت است و هیچ خطایی هم نمیبینید.
در قسمت قبل نقشهی راه NLP را دیدیم و قدم اول آن پیشپردازش بود. در این قسمت همین قدم را از نزدیک میسازیم. توکنسازی، ریشهیابی، N-gram و TF-IDF را یاد میگیریم. مهمتر از آن، یاد میگیریم کدام پاکسازی مفید است و کدام اطلاعات مهم را از بین میبرد.
پیشپردازش متن چیست و چرا مهم است؟
مدلهای یادگیری ماشین فقط عدد میفهمند. پس متن باید به شکل عددی درآید. پیشپردازش متن مجموعهی قدمهایی است که متن خام را برای این تبدیل آماده میکند. هر قدم تصمیمی است دربارهی اینکه چه اطلاعاتی حفظ و چه اطلاعاتی دور ریخته شود.
دو هدف متضاد
پیشپردازش دو هدف متضاد دارد. هدف اول کم کردن تنوع بیمعناست. «کتابها»، «کتابها» و «كتابها» باید یک چیز دیده شوند. هدف دوم حفظ تنوع معنادار است. «میخواهم» و «نمیخواهم» نباید یک چیز دیده شوند.
هر قدم پیشپردازش باید با این دو هدف سنجیده شود. قاعدهی سرانگشتی ساده است؛ هر اطلاعاتی را که برای وظیفهی شما مهم است، حفظ کنید. آنچه برای دستهبندی موضوع بیاهمیت است، ممکن است برای تحلیل احساس حیاتی باشد.
پیشپردازش سبک و سنگین
برای مدلهای کلاسیک مثل کیسهی کلمات، پیشپردازش سنگینتر معمولاً کمک میکند. این مدلها فقط کلمات را میشمارند و هر کاهش تنوع بیمعنا، کارشان را آسانتر میکند.
برای مدلهای ترنسفورمر امروزی، پیشپردازش سبک بهتر است. این مدلها توکنساز خودشان را دارند و از بافت کامل جمله استفاده میکنند. معمولاً فقط یکدستسازی حروف و حذف نویزهای واضح مثل کدهای HTML لازم است.
توکنسازی و یکدستسازی متن فارسی
اولین قدم پیشپردازش، تقسیم متن به توکن است. توکن معمولاً یک کلمه است، اما میتواند بخشی از کلمه یا حتی یک نویسه باشد. در انگلیسی، تقسیم با فاصله تقریباً کار میکند. در فارسی نه.
چرا تقسیم با فاصله کافی نیست؟
در فارسی، «میروم» با نیمفاصله یک کلمه است. اگر بهاشتباه با فاصله نوشته شود، دو توکن «می» و «روم» میشود. «کتابهایمان» یک کلمه با دو پسوند است. علائم نگارشی هم اغلب به کلمه چسبیدهاند؛ «چرا؟» باید دو توکن «چرا» و «؟» باشد.
توکنسازهای مخصوص فارسی این قواعد را میشناسند. در قسمت قبل Hazm را دیدیم. ترتیب درست این است که اول یکدستسازی و بعد توکنسازی انجام شود. یکدستساز نیمفاصلهها را درست میکند و بعد توکنساز کلمات را درست جدا میکند.
ریشهیابی و بنواژهیابی
ریشهیابی یا Stemming پسوندها و پیشوندها را با قاعدههای ساده حذف میکند. «کتابها» و «کتابی» هر دو به «کتاب» میرسند. سریع است، اما گاهی نتیجهی بیمعنا میدهد.
بنواژهیابی یا Lemmatization دقیقتر است. از واژهنامه و دستور زبان استفاده میکند تا شکل پایهی واقعی کلمه را پیدا کند. «رفتم» و «میروم» هر دو به بن فعل «رفت#رو» میرسند. برای کیسهی کلمات، این کار تنوع را بسیار کم میکند. اما تفاوت زمان فعل را پاک میکند که گاهی مهم است.
بیشتر بخوانید: چالشهای نیمفاصله، حروف عربی و زبان محاوره را در پردازش زبان طبیعی چیست؟ با مثال Hazm دیدیم.
کلمات توقف؛ حذف با احتیاط
کلمات توقف پرتکرارترین کلمات زباناند؛ مثل «و»، «از»، «به»، «که» و «این». در بسیاری از آموزشها، اولین توصیه حذف آنهاست. اما این توصیه همیشه درست نیست.
کی حذف کلمات توقف مفید است؟
برای جستجوی کلیدواژهای و مدلهای سادهی دستهبندی موضوع، حذف کلمات توقف معمولاً مفید است. این کلمات در همهی اسناد هستند و چیزی دربارهی موضوع نمیگویند. حذفشان اندازهی واژگان را کم میکند و مدل را سریعتر میکند.
مثلاً برای تشخیص اینکه پیامی دربارهی «پرداخت» است یا «ثبتنام»، کلمهی «که» هیچ کمکی نمیکند. کلمات «قسط»، «کارت» و «تراکنش» همهی کار را انجام میدهند.
کی حذف کلمات توقف خطرناک است؟
بسیاری از فهرستهای آمادهی کلمات توقف، کلمات منفیساز را هم دارند. «نه»، «نیست» و «هیچ» در این فهرستها رایجاند. پیشوند منفی «ن» و «نمی» هم ممکن است در ریشهیابی حذف شود. نتیجه همان مثال ابتدای این قسمت است.
برای تحلیل احساس، پاسخ به پرسش و هر وظیفهای که به معنای دقیق جمله وابسته است، کلمات توقف را حذف نکنید. اگر مجبورید، فهرست را خودتان بازبینی کنید و کلمات منفیساز، پرسشی و قیدهای شدت مثل «خیلی» و «اصلاً» را از آن بیرون بیاورید.
از متن به بردار؛ کیسه کلمات، N-gram و TF-IDF
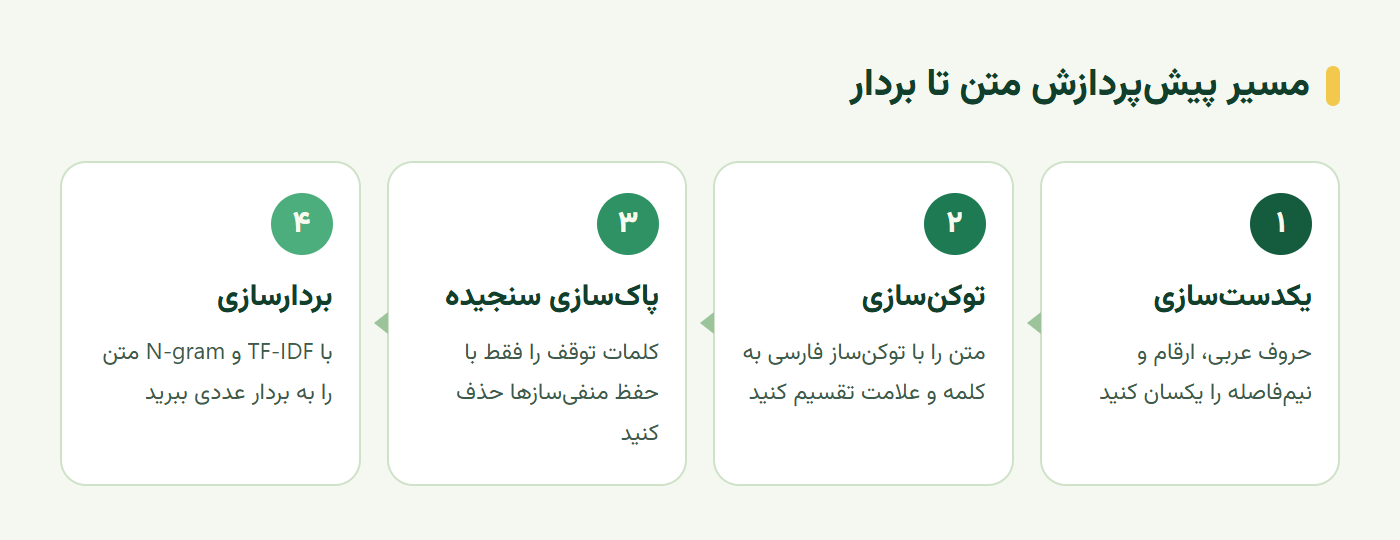
پس از توکنسازی، متن باید به بردار عددی تبدیل شود. سادهترین روشها بر شمارش کلمات تکیه دارند. این روشها هنوز برای خط پایه و مسائل ساده بسیار کاربردیاند. نمودار زیر مسیر کامل پیشپردازش تا بردار را نشان میدهد.
کیسه کلمات و N-gram
در کیسهی کلمات، هر سند برداری است که طولش برابر اندازهی واژگان است. هر خانه تعداد تکرار یک کلمه در سند است. ترتیب کلمات کاملاً از دست میرود؛ «سگ گربه را دنبال کرد» و «گربه سگ را دنبال کرد» یک بردار دارند.
N-gram بخشی از این ترتیب را برمیگرداند. به جای تککلمه، جفت یا سهتایی کلمات پشت سر هم را هم میشماریم. حالا «خوب نبود» یک ویژگی جداست و از «خوب» تفکیک میشود. همین ترفند ساده، مدلهای کلاسیک تحلیل احساس را بسیار بهتر میکند.
TF-IDF؛ وزن کلمات مهم
در شمارش ساده، کلمات پرتکرار وزن زیادی میگیرند، حتی اگر در همهی اسناد باشند. TF-IDF این را اصلاح میکند. TF تعداد تکرار کلمه در سند است. IDF لگاریتم معکوس نسبت اسنادی است که کلمه را دارند.
حاصلضرب این دو، وزن کلمه است. کلمهای که در یک سند زیاد و در بقیه کم است، وزن بالا میگیرد. کد زیر TF-IDF را با توکنساز فارسی و N-gram یک و دو کلمهای میسازد:
from hazm import Normalizer, word_tokenize
from sklearn.feature_extraction.text import TfidfVectorizer

norm = Normalizer()
docs = ["این دوره اصلاً خوب نبود", "دوره خیلی خوب بود", "پرداخت قسط دوم انجام نشد"]

vec = TfidfVectorizer(tokenizer=lambda t: word_tokenize(norm.normalize(t)),
                      token_pattern=None, ngram_range=(1, 2), min_df=1)
X = vec.fit_transform(docs)
print(X.shape)
print(sorted(vec.vocabulary_)[:10])تمرین عملی؛ آزمون اثر پیشپردازش
با پنجاه نظر واقعی کاربران که برچسب مثبت یا منفی دارند، این آزمایش را انجام دهید:
- خط پایه: TF-IDF تککلمهای با رگرسیون لجستیک بسازید و F1 را ثبت کنید.
- N-gram:
ngram_range=(1, 2)را امتحان کنید و تفاوت را بسنجید. - کلمات توقف: یک فهرست آمادهی کلمات توقف فارسی را حذف کنید و ببینید F1 چه میشود.
- بازبینی فهرست: کلمات منفیساز را از فهرست بیرون بیاورید و دوباره بسنجید.
- پنج نمونهی خطا: نظرهایی را که مدل اشتباه کرده بخوانید و علت را بنویسید.
احتمالاً میبینید حذف کورکورانهی کلمات توقف F1 را پایین میآورد و N-gram آن را بالا میبرد. این تمرین درس این قسمت را ملموس میکند.
سخن پایانی
پیشپردازش متن دو هدف متضاد دارد؛ کم کردن تنوع بیمعنا و حفظ تنوع معنادار. یکدستسازی و توکنسازی مخصوص فارسی، ریشهیابی و بنواژهیابی، و کیسهی کلمات با N-gram و TF-IDF ابزارهای اصلی این کارند.
مهمترین درس این قسمت احتیاط است. هیچ قدم پیشپردازش را بدون سنجیدن اثرش روی وظیفهی خودتان اضافه نکنید. حذف کلمات توقف و ریشهیابی سنگین میتوانند بیصدا معنای جمله را عوض کنند. برای مدلهای ترنسفورمر، پیشپردازش سبک تقریباً همیشه بهتر است.
این آموزش بر پایهی درسهای Representing Text as Tensors از مجموعهی AI for Beginners و Common NLP tasks and techniques از مجموعهی ML for Beginners مایکروسافت (مجوز MIT) به فارسی بازنویسی و تکمیل شده است.
پرسشهای پرتکرار
پیشپردازش متن چیست؟
پیشپردازش متن مجموعهی کارهایی است که متن خام را برای مدل آماده میکند؛ مثل یکدستسازی حروف، تقسیم به توکن، حذف یا نگهداشتن علائم، ریشهیابی و تبدیل به بردار عددی. انتخاب درست این مراحل روی دقت مدل اثر زیادی دارد.
توکنسازی چیست؟
توکنسازی یعنی تقسیم متن به واحدهای کوچکتر به نام توکن؛ معمولاً کلمه، بخشی از کلمه یا نویسه. در فارسی به خاطر نیمفاصله و پیشوندها و پسوندها، توکنساز مخصوص فارسی نتیجهی بسیار بهتری از تقسیم با فاصله میدهد.
TF-IDF چیست؟
TF-IDF وزنی برای هر کلمه در یک سند است. TF نشان میدهد کلمه در این سند چقدر تکرار شده و IDF نشان میدهد در کل اسناد چقدر نادر است. کلمههایی که در یک سند زیاد و در بقیه کماند، وزن بالا میگیرند.
آیا همیشه باید کلمات توقف را حذف کرد؟
نه. حذف کلمات توقف برای جستجو و مدلهای ساده گاهی مفید است، اما میتواند اطلاعات مهمی را پاک کند. مثلاً حذف «نه» یا «نمی» جملهی منفی را مثبت میکند. برای مدلهای ترنسفورمر معمولاً هیچ کلمهای حذف نمیشود.
دیدگاهها
هنوز دیدگاهی ثبت نشده است. شروعکننده باشید — پرسش و اصلاح را با آغوش باز میپذیریم.