
شبکه عصبی بازگشتی پاسخی به مشکلی بود که همهی روشهای قبلی داشتند. جملهی «سگ گربه را دنبال کرد» و «گربه سگ را دنبال کرد» کلمات یکسانی دارند. کیسهی کلمات و میانگین امبدینگها آنها را یکی میبینند. اما معنایشان کاملاً برعکس است. ترتیب کلمات معنا دارد.
در قسمت قبل امبدینگ کلمه را دیدیم. حالا میخواهیم مدلی بسازیم که علاوه بر معنای هر کلمه، ترتیب آنها را هم بفهمد. در این قسمت RNN و نسخهی قویتر آن LSTM را میشناسیم. یک طبقهبند متن با LSTM میسازیم و در پایان میبینیم چرا ترنسفورمر جایشان را گرفت.
شبکه عصبی بازگشتی چیست؟
شبکههای قبلی ورودی را یکجا میگرفتند. RNN ورودی را قدمبهقدم میخواند؛ درست مثل انسان که جمله را کلمه به کلمه میخواند. در هر قدم، یک توکن را میگیرد و حافظهاش را بهروز میکند. به این حافظه، حالت پنهان میگویند.
حالت پنهان؛ حافظهی شبکه
در هر قدم، سلول RNN دو ورودی دارد؛ توکن فعلی و حالت پنهان قدم قبل. خروجیاش حالت پنهان تازه است. این حالت از قدم به قدم منتقل میشود و خلاصهای از همهی توکنهای دیدهشده را نگه میدارد.
در پایان جمله، آخرین حالت پنهان بازنمایی کل جمله است. برای دستهبندی متن، همین حالت به یک لایهی خطی داده میشود. چون حالت از ابتدا تا انتها ساخته شده، ترتیب کلمات در آن اثر دارد. «سگ گربه را» و «گربه سگ را» حالتهای متفاوتی میسازند.
ساختار سلول RNN
یک سلول RNN ساده دو ماتریس وزن دارد. یکی توکن ورودی را تبدیل میکند و دیگری حالت پنهان قبلی را. حاصل این دو با هم جمع میشود، بایاس اضافه میشود و از تابع فعالسازی tanh عبور میکند.
نکتهی مهم این است که وزنها در همهی قدمها مشترکاند. یک سلول واحد روی همهی توکنها تکرار میشود. این همان ایدهی اشتراک وزن است که در CNN هم دیدیم؛ آنجا در مکان، اینجا در زمان. پس RNN میتواند دنبالههایی با هر طولی را پردازش کند.
مشکل محو شدن گرادیان
RNN در تئوری میتواند وابستگیهای طولانی را یاد بگیرد. در عمل، با یک مشکل جدی روبهرو میشود. در جملهی «دانشجویی که دیروز در کلاس صبح دربارهی پروژه سؤال پرسیده بود، امروز غایب است»، فعل «است» باید با «دانشجو» هماهنگ باشد. اما بینشان ده کلمه فاصله است.
چرا گرادیان محو میشود؟
برای آموزش RNN، پسانتشار در طول زمان انجام میشود. گرادیان باید از آخر جمله تا ابتدا برگردد و از همهی قدمها عبور کند. در هر قدم، در مشتق tanh و ماتریس وزن ضرب میشود. این عددها معمولاً کوچکتر از یکاند.
ضرب ده یا بیست عدد کوچک، عددی بسیار نزدیک به صفر میدهد. پس گرادیانی که به قدمهای اول میرسد، عملاً صفر است. شبکه نمیتواند یاد بگیرد که کلمهی اول روی کلمهی آخر اثر دارد. به این مشکل محو شدن گرادیان میگویند.
انفجار گرادیان
مشکل برعکس هم ممکن است. اگر عددها بزرگتر از یک باشند، گرادیان بهسرعت بزرگ میشود و آموزش منفجر میشود. وزنها به بینهایت میروند و خطا به NaN میرسد.
راهحل انفجار ساده است؛ برش گرادیان. اگر طول گرادیان از یک آستانه بیشتر شد، آن را کوچک میکنیم. در PyTorch این کار با clip_grad_norm_ انجام میشود. اما برای محو شدن گرادیان، به معماری تازهای نیاز بود.
بیشتر بخوانید: پسانتشار خطا و قاعدهی زنجیرهای را که ریشهی مشکل محو شدن گرادیان است، در شبکه عصبی چیست؟ از صفر دیدیم.
LSTM؛ حافظهای که انتخاب میکند
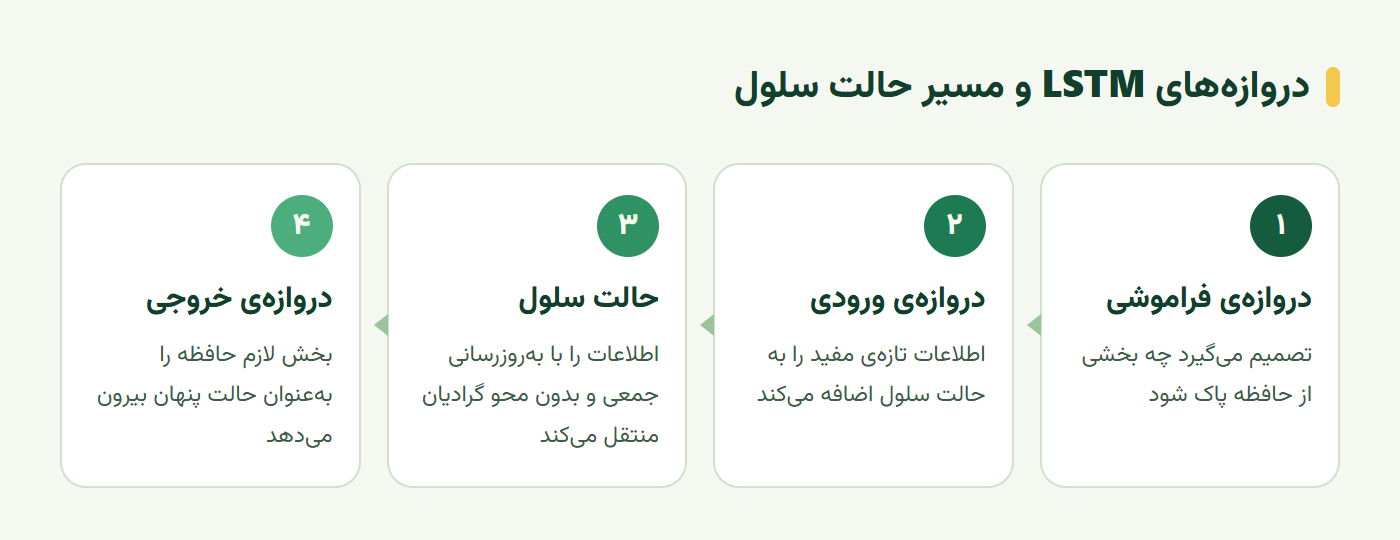
LSTM یا حافظهی کوتاهمدت طولانی، راهحل مشکل محو شدن گرادیان بود. علاوه بر حالت پنهان، یک حالت سلول جداگانه دارد. این حالت مثل یک نوار نقاله است که اطلاعات را با کمترین تغییر از ابتدا تا انتها منتقل میکند. نمودار زیر سه دروازهی LSTM و مسیر اطلاعات را نشان میدهد.
سه دروازه
دروازهی فراموشی تصمیم میگیرد چه بخشی از حالت سلول پاک شود. مثلاً وقتی جملهی تازهای شروع میشود، فاعل جملهی قبل دیگر لازم نیست. دروازهی ورودی تصمیم میگیرد چه اطلاعات تازهای به حالت سلول اضافه شود.
دروازهی خروجی تصمیم میگیرد چه بخشی از حالت سلول، بهعنوان حالت پنهان، به بیرون داده شود. هر دروازه یک لایهی کوچک با فعالسازی سیگموید است که عددی بین صفر و یک میدهد. صفر یعنی بسته و یک یعنی کاملاً باز.
چرا LSTM گرادیان را حفظ میکند؟
راز LSTM در بهروزرسانی حالت سلول است. این بهروزرسانی جمعی است، نه ضربی. حالت قبلی، ضرب در دروازهی فراموشی، با اطلاعات تازه جمع میشود. وقتی دروازهی فراموشی نزدیک یک است، گرادیان بدون کوچک شدن از این مسیر عبور میکند.
GRU نسخهی سادهتر LSTM است که دو دروازه دارد و حالت سلول و پنهان را یکی میکند. پارامتر کمتری دارد و سریعتر است. در بسیاری از مسائل، دقتش نزدیک LSTM است.
ساخت طبقهبند متن با LSTM
حالا یک طبقهبند موضوع پیام با LSTM در PyTorch میسازیم. ورودی شمارهی توکنهاست. لایهی امبدینگ آنها را به بردار تبدیل میکند، LSTM دنباله را میخواند و لایهی خطی دسته را پیشبینی میکند.
شبکهی دوطرفه و چندلایه
RNN معمولی فقط از چپ به راست میخواند. اما گاهی معنای یک کلمه به کلمات بعدی بستگی دارد. شبکهی دوطرفه دو RNN دارد؛ یکی از ابتدا به انتها و دیگری از انتها به ابتدا. حالت نهایی ترکیب هر دوست.
چند لایهی RNN را هم میشود روی هم گذاشت. خروجی لایهی اول، ورودی لایهی دوم است. لایههای بالاتر الگوهای انتزاعیتری از دنباله یاد میگیرند. در کد زیر هر دو ایده به کار رفته است:
import torch
from torch import nn

class LSTMClassifier(nn.Module):
    def __init__(self, vocab_size, n_classes, emb=128, hidden=128):
        super().__init__()
        self.emb = nn.Embedding(vocab_size, emb, padding_idx=0)
        self.lstm = nn.LSTM(emb, hidden, num_layers=2, batch_first=True,
                            bidirectional=True, dropout=0.2)
        self.fc = nn.Linear(2 * hidden, n_classes)

    def forward(self, ids, lengths):
        x = nn.utils.rnn.pack_padded_sequence(self.emb(ids), lengths.cpu(),
                                              batch_first=True, enforce_sorted=False)
        _, (h, _) = self.lstm(x)
        return self.fc(torch.cat([h[-2], h[-1]], dim=1))   # آخرین لایه، دو جهت
طول متغیر و packing
جملهها طول متفاوت دارند. برای ساختن دسته، جملههای کوتاه با توکن صفر پر میشوند. اما نمیخواهیم LSTM این صفرها را هم بخواند. pack_padded_sequence به LSTM میگوید هر جمله کجا تمام میشود.
خروجی h آخرین حالت پنهان هر لایه و هر جهت است. h[-2] و h[-1] حالتهای لایهی آخر در دو جهتاند. ترکیب این دو، بازنمایی کل جمله را میدهد. با همان حلقهی آموزش قسمت ۳۲ میشود این مدل را آموزش داد.
تمرین عملی؛ ترتیب مهم است
روی دادهی دستهبندی متن خودتان یا یک مجموعهدادهی عمومی این مقایسه را انجام دهید:
- خط پایه: میانگین امبدینگ کلمات با یک لایهی خطی.
- RNN ساده: یک لایهی
nn.RNNبا همان امبدینگ. - LSTM دوطرفه: مدل کد بالا.
- آزمون ترتیب: کلمات جملههای آزمون را تصادفی بر هم بزنید و افت دقت هر مدل را ببینید.
آزمایش آخر نشان میدهد کدام مدل واقعاً به ترتیب کلمات تکیه میکند. خط پایهی میانگین امبدینگ هیچ تغییری نمیکند، چون ترتیب را نمیبیند.
سخن پایانی
شبکه عصبی بازگشتی متن را قدمبهقدم میخواند و با حالت پنهان، ترتیب کلمات را در بازنماییاش نگه میدارد. اما در دنبالههای طولانی با محو شدن گرادیان روبهرو میشود. LSTM با حالت سلول و سه دروازه، این مشکل را تا حد زیادی حل کرد و GRU نسخهی سادهتر آن است.
شبکههای دوطرفه و چندلایه قدرت RNN را بیشتر میکنند. اما RNN یک محدودیت بنیادی دارد؛ پردازش پشت سر هم که موازی نمیشود. همین محدودیت راه را برای ترنسفورمر باز کرد که در دو قسمت بعد به آن میرسیم.
این آموزش بر پایهی درس Recurrent Neural Networks از مجموعهی آزاد AI for Beginners مایکروسافت (مجوز MIT) به فارسی بازنویسی و تکمیل شده است.
پرسشهای پرتکرار
شبکه عصبی بازگشتی چیست؟
شبکه عصبی بازگشتی یا RNN نوعی شبکهی عصبی برای دادهی ترتیبی مثل متن و سری زمانی است. توکنها را یکییکی میخواند و یک حالت پنهان را از هر قدم به قدم بعد منتقل میکند. این حالت خلاصهای از آنچه تا آن لحظه دیده شده را نگه میدارد.
مشکل محو شدن گرادیان در RNN چیست؟
در دنبالههای طولانی، گرادیان هنگام پسانتشار از قدمهای زیاد عبور میکند و در هر قدم در عددی کوچک ضرب میشود. نتیجه این است که گرادیان به صفر نزدیک میشود و شبکه نمیتواند وابستگی بین کلمات دور از هم را یاد بگیرد.
LSTM چیست و چه فرقی با RNN ساده دارد؟
LSTM نوعی RNN با یک حالت سلول جداگانه و سه دروازه است؛ دروازهی فراموشی، ورودی و خروجی. این دروازهها تصمیم میگیرند چه اطلاعاتی حفظ، اضافه یا خوانده شود. به همین دلیل LSTM وابستگیهای طولانیتر را بسیار بهتر از RNN ساده یاد میگیرد.
چرا ترنسفورمر جای RNN را گرفت؟
RNN توکنها را یکییکی و پشت سر هم پردازش میکند، پس روی پردازندهی گرافیکی موازی نمیشود و آموزش روی دادهی بزرگ کند است. ترنسفورمر با سازوکار توجه همهی توکنها را همزمان میبیند، موازی آموزش میبیند و وابستگیهای دور را مستقیم مدل میکند.
دیدگاهها
هنوز دیدگاهی ثبت نشده است. شروعکننده باشید — پرسش و اصلاح را با آغوش باز میپذیریم.