
امبدینگ کلمه یکی از زیباترین ایدههای هوش مصنوعی است. فرض کنید بردار «پادشاه» را بردارید، بردار «مرد» را از آن کم کنید و بردار «زن» را اضافه کنید. نتیجه به بردار «ملکه» بسیار نزدیک است. هیچکس این رابطه را به مدل یاد نداده است. مدل فقط میلیونها جمله خوانده و خودش فهمیده است.
در قسمت قبل متن را با TF-IDF به بردار تبدیل کردیم. اما آن بردارها معنا را نمیفهمیدند. برای TF-IDF، «معلم» و «استاد» دو کلمهی کاملاً بیربطاند. در این قسمت یاد میگیریم برداری بسازیم که معنا را نگه دارد. از لایهی امبدینگ و Word2Vec شروع میکنیم و به بردار جمله میرسیم.
امبدینگ کلمه چیست؟
امبدینگ یعنی قرار دادن هر کلمه در یک فضای برداری با تعداد بعد نسبتاً کم؛ مثلاً ۳۰۰ بعد. در این فضا، فاصله معنا دارد. کلماتی که معنا یا کاربرد نزدیک دارند، کنار هم قرار میگیرند. کلماتی که بیربطاند، از هم دورند.
مشکل بردار یکداغ و TF-IDF
در روشهای قسمت قبل، هر کلمه یک بعد جداگانه داشت. واژگان ۵۰ هزار کلمهای یعنی بردارهای ۵۰ هزار بعدی که تقریباً همهی خانههایشان صفر است. بدتر اینکه همهی کلمات به یک اندازه از هم دورند.
در این فضا، «معلم» به «استاد» همانقدر نزدیک است که به «ماشین لباسشویی». مدلی که با این بردارها آموزش ببیند، باید رابطهی هر جفت کلمه را از دادهی برچسبخورده یاد بگیرد. با دادهی محدود، این عملاً ممکن نیست.
لایهی امبدینگ
راهحل اول، لایهی امبدینگ در شبکهی عصبی است. این لایه یک جدول است که برای هر کلمه یک بردار کوچک نگه میدارد. بردارها در ابتدا تصادفیاند و همراه بقیهی شبکه آموزش میبینند.
مثلاً در یک مدل دستهبندی موضوع، لایهی امبدینگ یاد میگیرد «قسط» و «پرداخت» را نزدیک هم قرار دهد، چون هر دو به یک موضوع اشاره میکنند. اما این بردارها فقط برای همان وظیفه معنا دارند. برای معنای عمومیتر، باید روی متن بسیار بیشتری آموزش دید.
Word2Vec؛ یادگیری معنا از بافت
ایدهی اصلی Word2Vec از یک جملهی مشهور زبانشناسی آمده است؛ هر کلمه را از همنشینهایش بشناس. کلماتی که در بافتهای مشابه میآیند، معنای مشابه دارند. «معلم» و «استاد» هر دو کنار «کلاس»، «درس» و «دانشجو» میآیند.
CBoW و Skip-gram
Word2Vec دو معماری دارد. در کیسهی کلمات پیوسته یا CBoW، مدل کلمهی وسط را از روی کلمات اطرافش پیشبینی میکند. در Skip-gram برعکس است؛ مدل کلمات اطراف را از روی کلمهی وسط پیشبینی میکند.
هر دو روی متن بدون برچسب آموزش میبینند. خود متن برچسب را فراهم میکند. CBoW سریعتر است و Skip-gram برای کلمات کمتکرار بهتر عمل میکند. پس از آموزش، وظیفهی پیشبینی را دور میریزیم و فقط بردارهای یادگرفته را نگه میداریم.
قیاس برداری
بردارهای Word2Vec رابطههای معنایی را هم نگه میدارند. تفاوت بردار «پادشاه» و «ملکه» تقریباً همان تفاوت «مرد» و «زن» است. رابطههایی مثل پایتخت و کشور یا زمان فعل هم در جهتهای مشخصی از فضا دیده میشوند.
from gensim.models import Word2Vec

sentences = [s.split() for s in open("fa_corpus.txt", encoding="utf-8")]
model = Word2Vec(sentences, vector_size=100, window=5, min_count=5, sg=1, epochs=5)

print(model.wv.most_similar("معلم", topn=5))
print(model.wv.most_similar(positive=["پادشاه", "زن"], negative=["مرد"], topn=3))
این رابطهها جذاباند، اما همیشه دقیق نیستند. سوگیریهای متن آموزش هم در آنها منعکس میشود. پژوهشها نشان دادهاند امبدینگها گاهی مشاغل را به جنسیت خاصی نزدیک میکنند. همان سوگیریای که در قسمت هشتم دربارهاش حرف زدیم.
بیشتر بخوانید: TF-IDF و کیسهی کلمات را که امبدینگ جایگزینشان شد، در پیشپردازش متن با مثال فارسی ساختیم.
شباهت کسینوسی؛ سنجیدن نزدیکی معنا
برای مقایسهی دو بردار، معمولاً از شباهت کسینوسی استفاده میشود. این معیار کسینوس زاویهی بین دو بردار را حساب میکند. عدد یک یعنی کاملاً همجهت، صفر یعنی عمود و بیربط، و منفی یک یعنی مخالف.
چرا کسینوس و نه فاصله؟
فاصلهی معمولی به طول بردار حساس است. بردار یک سند بلند ممکن است فقط به خاطر طولش از یک سند کوتاه دور باشد، حتی اگر موضوعشان یکی باشد. شباهت کسینوسی فقط جهت را میسنجد و طول را نادیده میگیرد.
در عمل، بسیاری از مدلهای امبدینگ بردارهای نرمالشده با طول یک تولید میکنند. برای این بردارها، شباهت کسینوسی همان ضرب داخلی است که محاسبهاش بسیار سریع است. این نکته در جستجوی میلیونها بردار اهمیت زیادی پیدا میکند.
کاربرد در دستیار
شباهت کسینوسی پایهی جستجوی معنایی است. کاربر مینویسد «کی کلاسها شروع میشه؟» و در اسناد جملهای هست که میگوید «تاریخ آغاز دورهها». هیچ کلمهی مشترکی ندارند، اما بردارهایشان نزدیک است.
همین ایده برای پیدا کردن پرسشهای تکراری، گروهبندی بازخوردها و پیشنهاد مقالهی مرتبط هم کاربرد دارد. در قسمت خوشهبندی K-Means گفتیم پرسشها پیش از خوشهبندی باید به بردار تبدیل شوند. امبدینگ همان بردار است.
از امبدینگ ایستا تا بردار جمله
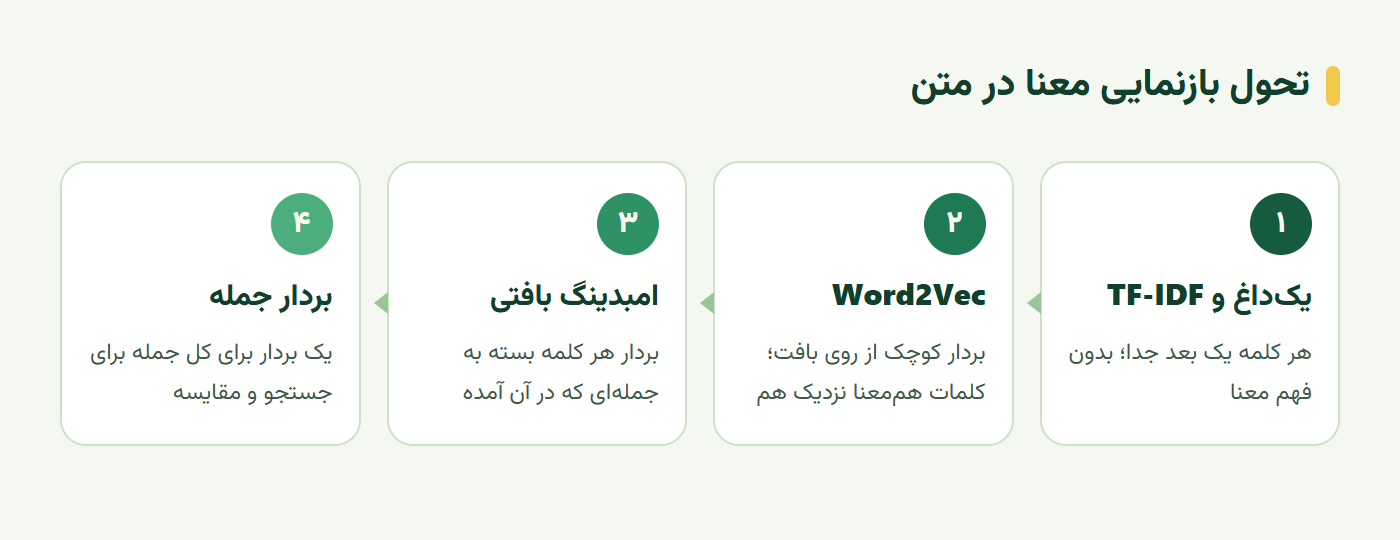
Word2Vec یک محدودیت مهم دارد. هر کلمه فقط یک بردار دارد. «شیر» در «شیر پاستوریزه» و «شیر جنگل» یک بردار میگیرد. «سیر» در «سیر شدم» و «یک حبه سیر» هم همینطور. معنا به بافت وابسته است و امبدینگ ایستا این را نمیبیند. نمودار زیر مسیر تحول امبدینگ را نشان میدهد.
امبدینگ بافتی
مدلهایی مثل BERT امبدینگ بافتی تولید میکنند. بردار هر کلمه بسته به جملهای که در آن آمده عوض میشود. «شیر» در جملهی خوراکی، برداری نزدیک به «ماست» میگیرد و در جملهی جنگل، برداری نزدیک به «ببر». این مدلها بر پایهی ترنسفورمرند که در قسمتهای بعدی میبینیم.
در کتابخانهی Transformers، هر مدل ترنسفورمر امبدینگ بافتی تولید میکند. مدلها را میشود با from_pretrained بارگذاری کرد یا فقط از روی پیکربندی با وزن تصادفی ساخت. برای امبدینگ، همیشه نسخهی آموزشدیده را بارگذاری کنید.
بردار جمله
برای جستجو و مقایسه، معمولاً به بردار کل جمله یا پاراگراف نیاز داریم، نه تککلمه. مدلهای بردار جمله برای همین کار آموزش دیدهاند. کتابخانهی sentence-transformers مدلهای چندزبانهای دارد که فارسی را هم پشتیبانی میکنند:
from sentence_transformers import SentenceTransformer, util
model = SentenceTransformer("sentence-transformers/paraphrase-multilingual-MiniLM-L12-v2")
q = model.encode("کی کلاسها شروع میشه؟", normalize_embeddings=True)
docs = model.encode(["تاریخ آغاز دورهها", "روش پرداخت قسطی"], normalize_embeddings=True)
print(util.cos_sim(q, docs))تمرین عملی؛ فضای معنایی دستیار
این آزمایشها را با یک مدل بردار جملهی چندزبانه انجام دهید:
- جفتهای هممعنا: ده جفت پرسش هممعنا با کلمات متفاوت بنویسید و شباهت کسینوسیشان را حساب کنید.
- جفتهای بیربط: ده جفت بیربط بسازید و شباهتشان را مقایسه کنید.
- آستانه: یک آستانهی شباهت پیدا کنید که بیشتر جفتهای هممعنا را از بیربط جدا کند.
- جملهی منفی: شباهت «کلاس فردا تشکیل میشود» و «کلاس فردا تشکیل نمیشود» را ببینید.
آزمایش آخر محدودیت مهمی را نشان میدهد. بسیاری از مدلهای بردار جمله، جملهی مثبت و منفی را بسیار نزدیک میبینند. برای وظایفی که منفی بودن مهم است، به مدل یا روش دیگری نیاز دارید.
سخن پایانی
امبدینگ کلمه معنا را به بردار تبدیل میکند، طوری که کلمات هممعنا کنار هم قرار بگیرند. Word2Vec با پیشبینی بافت از متن بدون برچسب، این بردارها را یاد میگیرد و حتی رابطههایی مثل قیاس را نگه میدارد. شباهت کسینوسی هم ابزار اصلی سنجیدن نزدیکی معناست.
امبدینگ ایستا هر کلمه را یک بار نمایش میدهد، اما امبدینگ بافتی معنا را از جمله میگیرد. بردار جمله پایهی جستجوی معنایی و بسیاری از قابلیتهای دستیار است. محدودیتهایش را هم بشناسید؛ سوگیری متن آموزش و ضعف در تشخیص جملهی منفی.
این آموزش بر پایهی درس Embeddings از مجموعهی AI for Beginners و درس Building Search Applications از مجموعهی Generative AI for Beginners مایکروسافت (مجوز MIT) و بخش Models از دورهی Hugging Face (مجوز Apache 2.0) به فارسی بازنویسی و تکمیل شده است.
پرسشهای پرتکرار
امبدینگ کلمه چیست؟
امبدینگ کلمه برداری از عددهاست، معمولاً با صد تا چند صد بعد، که معنای یک کلمه را نشان میدهد. این بردارها طوری یاد گرفته میشوند که کلمات هممعنا یا همکاربرد، مثل «معلم» و «استاد»، بردارهای نزدیک به هم داشته باشند.
Word2Vec چیست؟
Word2Vec روشی برای یادگیری امبدینگ کلمه از حجم زیاد متن بدون برچسب است. در روش CBoW، کلمه از روی کلمات اطرافش پیشبینی میشود و در روش Skip-gram، کلمات اطراف از روی خود کلمه. بردارهایی که در این فرایند یاد گرفته میشوند، معنا را نگه میدارند.
شباهت کسینوسی چیست؟
شباهت کسینوسی کسینوس زاویهی بین دو بردار است و عددی بین منفی یک و یک میدهد. هرچه به یک نزدیکتر باشد، دو بردار همجهتترند و معنای دو کلمه یا دو جمله به هم نزدیکتر است. برخلاف فاصلهی معمولی، به طول بردار حساس نیست.
تفاوت امبدینگ ایستا و بافتی چیست؟
در امبدینگ ایستا مثل Word2Vec، هر کلمه فقط یک بردار دارد. پس «شیر» خوراکی و «شیر» جنگل یکساناند. در امبدینگ بافتی مثل BERT، بردار هر کلمه بسته به جملهای که در آن آمده عوض میشود و معنای دقیق همان کاربرد را نشان میدهد.
دیدگاهها
هنوز دیدگاهی ثبت نشده است. شروعکننده باشید — پرسش و اصلاح را با آغوش باز میپذیریم.