
ترنسفورمر چیست و چرا مقالهای با عنوان «توجه، تنها چیزی است که لازم دارید» مسیر هوش مصنوعی را عوض کرد؟ پیش از آن، مدلهای زبان متن را کلمه به کلمه میخواندند؛ مثل کسی که با انگشت زیر خطوط را دنبال میکند. ترنسفورمر کل صفحه را یکجا میبیند و برای هر کلمه تصمیم میگیرد به کدام کلمات دیگر نگاه کند.
در دو قسمت قبل RNN و LSTM را دیدیم و محدودیتشان را شناختیم؛ پردازش پشت سر هم که موازی نمیشود و وابستگیهای دور را سخت یاد میگیرد. در این قسمت با سازوکار توجه این دو مشکل را حل میکنیم. بعد اجزای ترنسفورمر را یکییکی میشناسیم و در پایان با یک مدل BERT فارسی کار میکنیم.
از RNN تا توجه؛ مشکل گلوگاه
در ترجمهی ماشینی با RNN، معماری رمزگذار-رمزگشا رایج بود. رمزگذار جملهی مبدأ را میخواند و در پایان یک حالت پنهان میساخت. رمزگشا از روی همین یک بردار، جملهی مقصد را تولید میکرد. کل معنای جمله باید در یک بردار فشرده میشد.
گلوگاه یک بردار
برای جملههای کوتاه، این روش کار میکرد. اما برای جملهی چهل کلمهای، یک بردار نمیتوانست همهی جزئیات را نگه دارد. کیفیت ترجمه با طولانیتر شدن جمله بهشدت افت میکرد. اطلاعات ابتدای جمله تقریباً از دست میرفت.
مثال سادهای را در نظر بگیرید. از کسی بخواهید یک پاراگراف طولانی را فقط یک بار بخواند و بعد بدون نگاه دوباره، آن را ترجمه کند. جملههای اول را تقریباً فراموش کرده است. مترجم واقعی هنگام ترجمهی هر بخش، دوباره به همان بخش متن اصلی نگاه میکند. سازوکار توجه دقیقاً همین توانایی را به مدل داد.
اولین سازوکار توجه
راهحل اول این بود که رمزگشا به همهی حالتهای پنهان رمزگذار دسترسی داشته باشد، نه فقط آخری. در هر قدم تولید، رمزگشا تصمیم میگیرد به کدام کلمات مبدأ بیشتر توجه کند. هنگام ترجمهی فعل، به فعل جملهی مبدأ توجه میکند و هنگام ترجمهی فاعل، به فاعل.
این وزنهای توجه قابل مشاهدهاند و نشان میدهند مدل چه چیزی را به چه چیزی ربط داده است. کیفیت ترجمهی جملههای بلند بهطور چشمگیری بهتر شد. اما مدل هنوز RNN داشت و پشت سر هم کار میکرد. قدم بعدی حذف کامل RNN بود.
توجه به خود؛ قلب ترنسفورمر
در سال ۲۰۱۷، مقالهی Attention Is All You Need ترنسفورمر را معرفی کرد. ایدهی اصلی توجه به خود است. هر کلمهی جمله به همهی کلمات دیگر همان جمله توجه میکند تا بافت خودش را بسازد. هیچ RNNی در کار نیست.
پرسش، کلید و مقدار
برای هر کلمه سه بردار ساخته میشود؛ پرسش، کلید و مقدار. این سه از ضرب بردار امبدینگ کلمه در سه ماتریس وزن به دست میآیند. یک تمثیل کمک میکند. در یک کتابخانه، پرسش چیزی است که دنبالش هستید، کلید برچسب روی قفسههاست و مقدار محتوای کتابها.
برای کلمهی «ش» در «دانشجو کتابش را گم کرد»، پرسش این است: «من به چه کسی اشاره میکنم؟» این پرسش با کلید همهی کلمات مقایسه میشود. کلید «دانشجو» بیشترین شباهت را دارد. پس بردار نهایی «ش» بیشتر از مقدار «دانشجو» ساخته میشود.
فرمول توجه
از نظر ریاضی، شباهت پرسش هر کلمه با کلید همهی کلمات با ضرب داخلی حساب میشود. حاصل بر ریشهی دوم بعد بردار تقسیم میشود تا عددها خیلی بزرگ نشوند. بعد softmax آنها را به وزنهایی تبدیل میکند که جمعشان یک است. در پایان، مجموع وزندار بردارهای مقدار، خروجی است:
import math
import torch
def attention(q, k, v, mask=None):
scores = q @ k.transpose(-2, -1) / math.sqrt(q.size(-1))
if mask is not None:
scores = scores.masked_fill(mask == 0, float("-inf"))
weights = torch.softmax(scores, dim=-1)
return weights @ v, weights
x = torch.randn(1, 6, 16) # یک جمله با ۶ توکن و بعد ۱۶
out, w = attention(x, x, x)
print(out.shape, w[0].sum(dim=-1)) # جمع وزنهای هر توکن برابر یک استهمهی این محاسبات ضرب ماتریساند و روی پردازندهی گرافیکی کاملاً موازی اجرا میشوند. همهی کلمات همزمان پردازش میشوند. همین موازی بودن آموزش روی حجم عظیم متن را ممکن کرد.
بیشتر بخوانید: محدودیت پردازش پشت سر هم و محو شدن گرادیان را که ترنسفورمر حل کرد، در شبکه عصبی بازگشتی و LSTM دیدیم.
اجزای دیگر ترنسفورمر
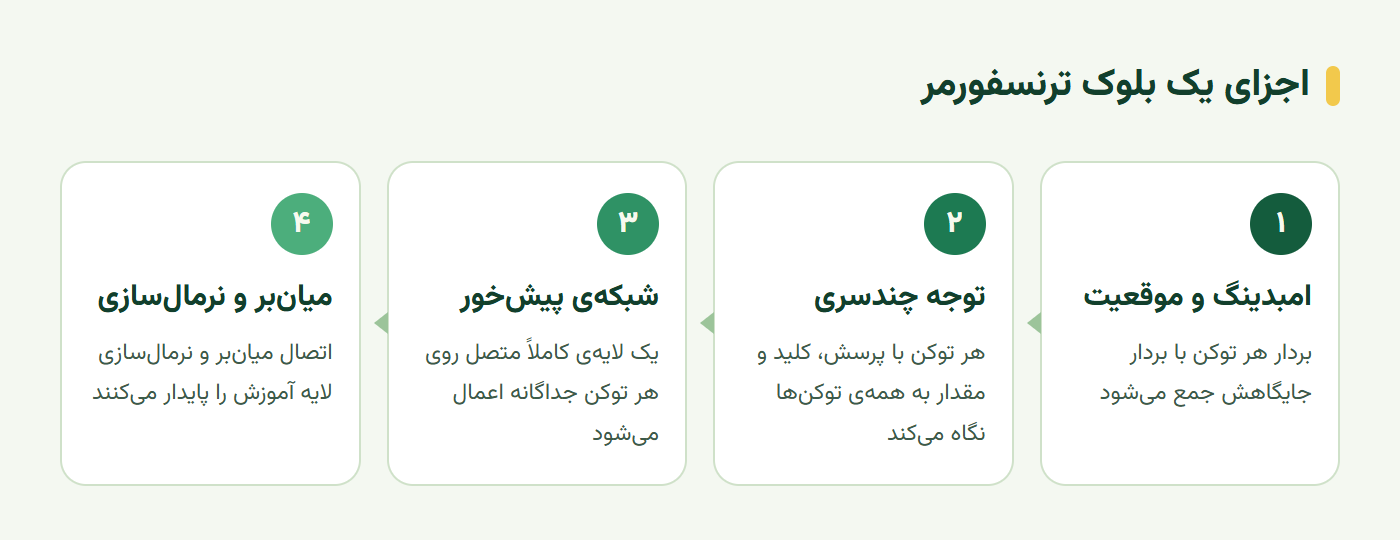
توجه به خود قلب ترنسفورمر است، اما چند جزء دیگر هم لازم است تا مدل کامل شود. نمودار زیر اجزای اصلی یک بلوک ترنسفورمر را نشان میدهد.
کدگذاری موقعیتی
سازوکار توجه یک ضعف دارد. ترتیب کلمات را نمیبیند. برای آن، مجموعهی کلمات مهم است، نه جایگاهشان. «سگ گربه را دنبال کرد» و «گربه سگ را دنبال کرد» یکسان دیده میشوند.
کدگذاری موقعیتی این مشکل را حل میکند. به بردار امبدینگ هر کلمه، برداری اضافه میشود که جایگاهش را نشان میدهد. در مقالهی اصلی، این بردار از توابع سینوس و کسینوس با فرکانسهای مختلف ساخته میشد. در بسیاری از مدلهای امروزی، کدگذاری موقعیتی هم یاد گرفته میشود.
توجه چندسری
یک سری توجه فقط یک نوع رابطه را میبیند. اما کلمات رابطههای مختلفی دارند؛ دستوری، معنایی، ارجاعی. توجه چندسری چند سازوکار توجه را موازی اجرا میکند. هر سر ماتریسهای پرسش، کلید و مقدار خودش را دارد.
مثلاً یک سر ممکن است یاد بگیرد ضمیر را به مرجعش وصل کند. سر دیگر فعل را به فاعلش. خروجی همهی سرها کنار هم گذاشته و ترکیب میشوند. پس از توجه، یک شبکهی کاملاً متصل کوچک روی هر کلمه جداگانه اعمال میشود. اتصال میانبر و نرمالسازی لایه هم آموزش شبکهی عمیق را پایدار میکنند.
سه خانواده ترنسفورمر؛ BERT، GPT و T5
ترنسفورمر اصلی رمزگذار و رمزگشا داشت؛ برای ترجمه. رمزگشا علاوه بر توجه به خود، به خروجی رمزگذار هم توجه میکرد. بعدها سه خانواده از این معماری شکل گرفتند که هرکدام بخشی از آن را نگه داشتند.
BERT؛ فقط رمزگذار
BERT فقط بخش رمزگذار را دارد. هر کلمه با دیدن کل جمله، هم کلمات چپ و هم راست، بافتش را میسازد. BERT با پنهان کردن تصادفی بعضی کلمات و پیشبینی آنها آموزش میبیند. برای فهم متن مثل دستهبندی، تحلیل احساس و استخراج موجودیت بسیار مناسب است.
برای فارسی، مدلهایی مثل ParsBERT روی متن فارسی آموزش دیدهاند. کد زیر با کتابخانهی Transformers یک کلمهی پنهان را پیشبینی میکند:
from transformers import pipeline
fill = pipeline("fill-mask", model="HooshvareLab/bert-fa-base-uncased")
for r in fill("کلاسهای این دوره هر هفته [MASK] برگزار میشود.")[:3]:
print(r["token_str"], round(r["score"], 3))GPT و T5
GPT فقط بخش رمزگشا را دارد. هر کلمه فقط کلمات قبلی را میبیند؛ ماسک مخصوصی جلوی دیدن آینده را میگیرد. با پیشبینی کلمهی بعدی آموزش میبیند و برای تولید متن ساخته شده است. مدلهای زبانی بزرگ امروزی بیشتر از همین خانوادهاند.
T5 و BART رمزگذار و رمزگشا را با هم دارند. برای وظایفی که ورودی و خروجی هر دو متناند، مثل ترجمه و خلاصهسازی، مناسباند. انتخاب بین این سه خانواده به وظیفهی شما بستگی دارد؛ فهم، تولید، یا تبدیل متن به متن.
تمرین عملی؛ دیدن توجه
این آزمایشها کمک میکنند توجه را ملموس ببینید:
- تابع توجه: کد بالا را اجرا کنید و ماتریس وزنهای توجه را به شکل نقشهی حرارتی رسم کنید.
- ماسک علّی: یک ماسک پایینمثلثی بسازید و ببینید هر توکن فقط به توکنهای قبلی توجه میکند.
- BERT فارسی: پنج جمله با یک کلمهی پنهان بنویسید و پیشبینیهای ParsBERT را بررسی کنید.
- وزنهای واقعی: با
output_attentions=Trueوزنهای توجه یک جمله را از BERT بگیرید و ببینید ضمیر به کجا توجه میکند.
تمرین آخر نشان میدهد بعضی سرهای توجه واقعاً رابطههای قابل تفسیری یاد گرفتهاند.
سخن پایانی
ترنسفورمر با سازوکار توجه، مشکل گلوگاه و پردازش پشت سر هم را حل کرد. در توجه به خود، هر کلمه با پرسش، کلید و مقدار، بافتش را از همهی کلمات دیگر میسازد. توجه چندسری رابطههای مختلف را موازی میبیند و کدگذاری موقعیتی ترتیب را حفظ میکند.
سه خانواده از این معماری شکل گرفت؛ BERT برای فهم، GPT برای تولید و T5 برای تبدیل متن به متن. همهی مدلهای زبانی بزرگ امروزی بر همین پایه ساخته شدهاند. در قسمتهای بعدی، از این مدلها برای کارهای عملی استفاده میکنیم.
این آموزش بر پایهی درس Attention Mechanisms and Transformers از مجموعهی آزاد AI for Beginners مایکروسافت (مجوز MIT) و مقدمهی دورهی Hugging Face (مجوز Apache 2.0) به فارسی بازنویسی و تکمیل شده است.
پرسشهای پرتکرار
ترنسفورمر چیست؟
ترنسفورمر معماری شبکهی عصبیای است که در سال ۲۰۱۷ معرفی شد و به جای خواندن متن کلمه به کلمه، با سازوکار توجه همهی کلمات را همزمان میبیند. هر کلمه با همهی کلمات دیگر مقایسه میشود تا بافتش ساخته شود. همهی مدلهای زبانی بزرگ امروز بر این معماری ساخته شدهاند.
سازوکار توجه چیست؟
سازوکار توجه روشی است که مدل برای هر کلمه تعیین میکند به کدام کلمات دیگر جمله چقدر توجه کند. مثلاً در جملهی «دانشجو کتابش را گم کرد»، ضمیر «ش» بیشترین توجه را به «دانشجو» میدهد. وزنهای توجه از شباهت بردارهای پرسش و کلید حساب میشوند.
کدگذاری موقعیتی چرا لازم است؟
چون سازوکار توجه ذاتاً ترتیب کلمات را نمیبیند؛ برای آن «سگ گربه را» و «گربه سگ را» یکسان است. کدگذاری موقعیتی به بردار هر کلمه اطلاعات جایگاهش در جمله را اضافه میکند تا ترتیب حفظ شود.
تفاوت BERT و GPT چیست؟
BERT فقط بخش رمزگذار ترنسفورمر را دارد و هر کلمه را با دیدن کل جمله، از چپ و راست، میفهمد. برای فهم متن مثل دستهبندی و استخراج موجودیت مناسب است. GPT فقط بخش رمزگشا را دارد و هر کلمه فقط کلمات قبلی را میبیند. برای تولید متن ساخته شده است.
دیدگاهها
هنوز دیدگاهی ثبت نشده است. شروعکننده باشید — پرسش و اصلاح را با آغوش باز میپذیریم.