
دما در مدل زبانی شاید پرکاربردترین تنظیمی باشد که کمتر کسی دقیقاً میداند چه کار میکند. وقتی دستیار آموزشی شما برای یک پرسش ساده هر بار پاسخ متفاوتی میدهد، یا وقتی داستانی که مینویسد خستهکننده و تکراری است، احتمالاً مشکل از دماست. این عدد کوچک تعادل بین دقت و خلاقیت را تعیین میکند.
در قسمت قبل دیدیم RNN چطور ترتیب کلمات را در طبقهبندی به کار میبرد. حالا از RNN برای کار دیگری استفاده میکنیم؛ تولید متن. در این قسمت میبینیم مدل چطور متن را توکن به توکن میسازد. بعد روشهای انتخاب توکن بعدی را از حریصانه تا top-p یاد میگیریم و میفهمیم برای هر کاربرد کدام تنظیم مناسب است.
تولید متن توکن به توکن
همهی مدلهای مولد متن، از RNNهای ساده تا مدلهای زبانی بزرگ امروزی، یک کار را انجام میدهند. با گرفتن متن تا اینجا، توکن بعدی را پیشبینی میکنند. بعد آن توکن را به متن اضافه میکنند و دوباره پیشبینی میکنند. این حلقه تا پایان متن ادامه دارد.
معماریهای RNN برای تولید
در قسمت قبل RNN را به شکل «چند به یک» به کار بردیم؛ یک دنباله ورودی و یک برچسب خروجی. اما RNN در هر قدم یک خروجی هم میتواند بدهد. این انعطاف معماریهای مختلفی را ممکن میکند.
- یک به چند: یک ورودی و یک دنباله خروجی؛ مثل تولید شرح برای یک تصویر.
- چند به یک: یک دنباله ورودی و یک خروجی؛ مثل دستهبندی متن.
- چند به چند: یک دنباله ورودی و یک دنباله خروجی؛ مثل ترجمهی ماشینی.
برای تولید متن، از حالت سادهای استفاده میکنیم. در هر قدم، خروجی RNN یک توزیع احتمال روی همهی نویسهها یا توکنهای ممکن است. مدل یاد میگیرد نویسهی بعدی را از روی نویسههای قبلی پیشبینی کند.
آموزش و تولید
آموزش ساده است. متن زیادی را به تکههای کوتاه تقسیم میکنیم. برای هر تکه، ورودی نویسههای اول تا یکی مانده به آخر است و هدف همان تکه با یک قدم جابهجایی. مدل در هر قدم یاد میگیرد نویسهی بعدی را پیشبینی کند.
برای تولید، با یک متن آغازین شروع میکنیم. آن را از RNN عبور میدهیم تا حالت پنهان ساخته شود. بعد از توزیع خروجی، یک نویسه انتخاب میکنیم، به ورودی اضافه میکنیم و ادامه میدهیم. سؤال مهم این است: از توزیع، کدام نویسه را انتخاب کنیم؟
انتخاب توکن بعدی؛ حریصانه یا نمونهبرداری
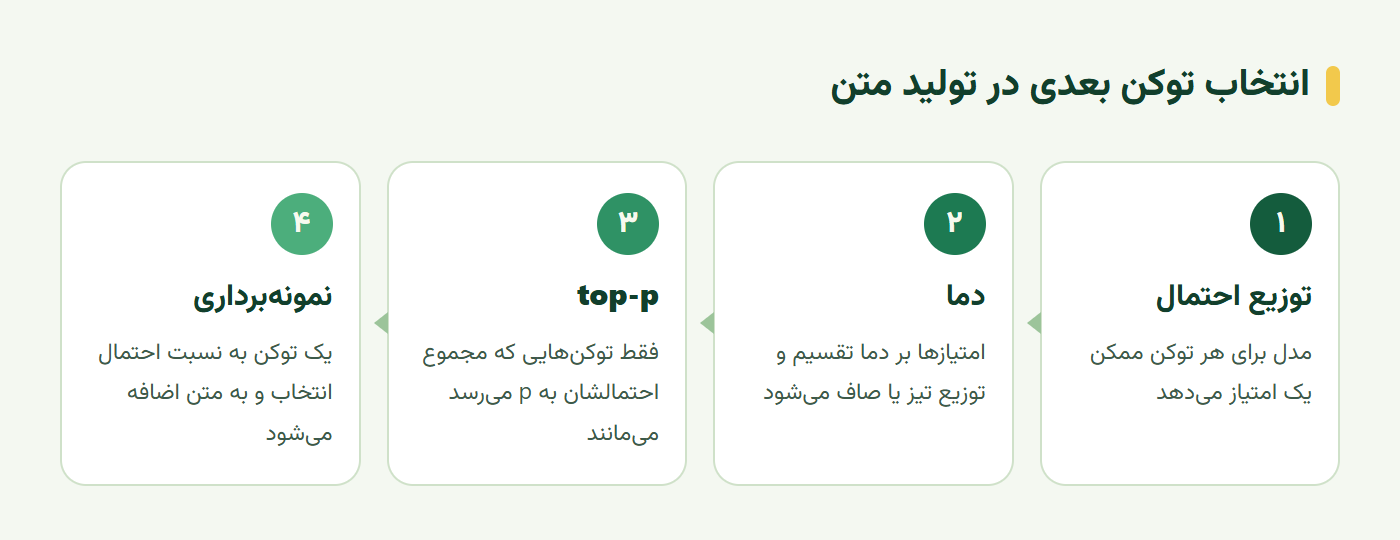
سادهترین راه این است که همیشه محتملترین توکن را انتخاب کنیم. به این روش انتخاب حریصانه میگویند. منطقی به نظر میرسد، اما نتیجهاش معمولاً ناامیدکننده است. نمودار زیر روشهای اصلی انتخاب توکن را نشان میدهد.
مشکل انتخاب حریصانه
وقتی یک RNN کوچک روی متن خبری انگلیسی آموزش ببیند و با انتخاب حریصانه متن تولید کند، خروجی چیزی شبیه این است: «today of the second the company and a second the company». مدل در یک حلقه گیر کرده است.
دلیلش این است که محتملترین ادامهی «the company» ممکن است دوباره عبارتی باشد که به «the company» میرسد. انتخاب حریصانه هیچ راه فراری از این حلقه ندارد. مدلهای زبانی بزرگ هم با انتخاب حریصانه گاهی جمله یا پاراگرافی را تکرار میکنند.
نمونهبرداری با دما
راهحل، نمونهبرداری است. به جای انتخاب محتملترین توکن، یک توکن را به نسبت احتمالش بهطور تصادفی انتخاب میکنیم. توکنی که احتمال ۶۰ درصد دارد، در ۶۰ درصد موارد انتخاب میشود. این کمی تصادف حلقهها را میشکند.
دما این تصادف را کنترل میکند. پیش از softmax، همهی امتیازها بر دما تقسیم میشوند. دمای کمتر از یک توزیع را تیزتر میکند؛ محتملترین توکنها باز محتملتر میشوند. دمای بیشتر از یک توزیع را صافتر میکند و شانس توکنهای نادر بالا میرود:
import torch

def sample_next(logits, temperature=0.8, top_p=0.9):
    if temperature == 0:
        return int(torch.argmax(logits))                 # حریصانه
    probs = torch.softmax(logits / temperature, dim=-1)
    sorted_p, idx = torch.sort(probs, descending=True)
    keep = torch.cumsum(sorted_p, dim=-1) - sorted_p < top_p
    sorted_p = sorted_p * keep
    choice = torch.multinomial(sorted_p / sorted_p.sum(), 1)
    return int(idx[choice])
بیشتر بخوانید: ساخت یک برنامهی کامل تولید متن با API و پرامپت را در برنامه تولید متن با هوش مصنوعی قدمبهقدم ساختهایم.
top-k و top-p؛ کنترل دم توزیع
نمونهبرداری با دمای بالا یک مشکل دارد. هزاران توکن بسیار کماحتمال هم شانس کوچکی دارند. جمع این شانسهای کوچک قابل توجه است. گاهی مدل یک توکن کاملاً بیربط انتخاب میکند و متن از مسیر خارج میشود.
top-k؛ فقط k گزینهی برتر
در top-k، فقط k توکن محتملتر نگه داشته میشوند و بقیه حذف میشوند. نمونهبرداری فقط بین این k توکن انجام میشود. مثلاً با k برابر ۴۰، توکنهای بیربط هیچ شانسی ندارند.
مشکل top-k این است که k ثابت است. وقتی مدل مطمئن است و فقط دو گزینهی معقول وجود دارد، k برابر ۴۰ باز هم ۳۸ گزینهی نامعقول را نگه میدارد. وقتی مدل نامطمئن است و صد گزینهی معقول هست، k برابر ۴۰ گزینههای خوب را حذف میکند.
top-p؛ تطبیق با شکل توزیع
top-p یا نمونهبرداری هستهای این مشکل را حل میکند. به جای تعداد ثابت، کوچکترین مجموعهای از توکنها نگه داشته میشود که مجموع احتمالشان به p برسد. با p برابر ۰٫۹، وقتی مدل مطمئن است شاید فقط دو توکن بماند و وقتی نامطمئن است شاید صد توکن.
در کد بالا، همین منطق پیاده شده است. توکنها بر اساس احتمال مرتب میشوند و تا وقتی مجموع تجمعی از p کمتر است، نگه داشته میشوند. بیشتر APIهای مدلهای زبانی پارامتر top_p را هم مستقیم پشتیبانی میکنند.
انتخاب دما برای کاربردهای دستیار
دما یک تنظیم فنی است، اما انتخابش به کاربرد بستگی دارد. دستیار آموزشی کارهای مختلفی انجام میدهد و هرکدام دمای متفاوتی میخواهد.
دمای پایین؛ دقت و ثبات
برای پاسخ به پرسش از روی اسناد، دستهبندی پیام، استخراج اطلاعات و تولید کد، دمای پایین نزدیک صفر مناسب است. در این کارها یک پاسخ درست وجود دارد و تنوع فقط خطر خطا را زیاد میکند. کاربر هم انتظار دارد برای یک پرسش، پاسخ ثابتی بگیرد.
حتی با دمای صفر، بعضی سرویسها پاسخ کاملاً یکسانی تضمین نمیکنند. محاسبات موازی روی پردازندهی گرافیکی گاهی تفاوتهای کوچک عددی ایجاد میکند. برای ارزیابی، هر پرسش را چند بار اجرا کنید و ثبات پاسخ را هم بسنجید.
دمای بالاتر؛ خلاقیت و تنوع
برای ایدهپردازی، نوشتن مثالهای متنوع برای تمرین، متن تبلیغاتی یا داستان، دمای متوسط تا بالا بهتر است. مثلاً اگر دستیار باید ده سؤال تمرینی متفاوت دربارهی یک مبحث بسازد، دمای پایین سؤالهای بسیار شبیه به هم میسازد.
یک توصیهی عملی هم هست؛ دما و top-p را همزمان خیلی تغییر ندهید. معمولاً یکی را ثابت نگه دارید و دیگری را تنظیم کنید. و هر تغییری را روی مجموعهی ثابتی از نمونهها بسنجید، نه با حس کلی.
تمرین عملی؛ جدول دما برای دستیار
برای سه کار مختلف دستیار آموزشی، این آزمایش را انجام دهید:
- سه کار: پاسخ به پرسش از آییننامه، دستهبندی موضوع پیام و ساخت پنج سؤال تمرینی.
- سه دما: هر کار را با دمای ۰، ۰٫۷ و ۱٫۲ پنج بار اجرا کنید.
- ثبات و کیفیت: برای هر ترکیب، درستی پاسخ و میزان تفاوت پنج اجرا را ثبت کنید.
- انتخاب نهایی: برای هر کار، دما و top-p نهایی را با دلیل بنویسید.
این جدول را در پیکربندی دستیار نگه دارید. هر وقت مدل را عوض کردید، دوباره اجرایش کنید؛ دمای مناسب از مدلی به مدل دیگر فرق میکند.
سخن پایانی
مدلهای مولد متن را توکن به توکن میسازند و در هر قدم، توکن بعدی را از یک توزیع احتمال انتخاب میکنند. انتخاب حریصانه به تکرار و حلقه میرسد و نمونهبرداری این حلقهها را میشکند. دما تیزی یا صافی توزیع را تعیین میکند و top-k و top-p دم نامعقول آن را حذف میکنند.
برای کاربردهای دقیق، دمای پایین و برای کاربردهای خلاق، دمای بالاتر مناسب است. اما عدد درست را فقط آزمون روی نمونههای واقعی خودتان مشخص میکند. این اصول از RNNهای کوچک تا بزرگترین مدلهای زبانی یکساناند.
این آموزش بر پایهی درس Generative Networks از مجموعهی AI for Beginners و درس Building Text Generation Applications از مجموعهی Generative AI for Beginners مایکروسافت (مجوز MIT) به فارسی بازنویسی و تکمیل شده است.
پرسشهای پرتکرار
دما در مدل زبانی چیست؟
دما یا Temperature پارامتری است که توزیع احتمال توکن بعدی را پیش از نمونهبرداری تیزتر یا صافتر میکند. دمای پایین مدل را به انتخاب محتملترین توکنها میکشاند و متن قابل پیشبینیتر میشود. دمای بالا شانس توکنهای کماحتمال را بیشتر میکند و متن متنوعتر و گاهی بیربطتر میشود.
چه دمایی برای چه کاری مناسب است؟
برای استخراج اطلاعات، دستهبندی، پاسخ از روی سند و تولید کد، دمای پایین نزدیک صفر مناسب است. برای نوشتن خلاقانه، ایدهپردازی و متن تبلیغاتی، دمای متوسط تا بالا بهتر است. همیشه روی نمونههای واقعی خودتان بیازمایید.
تفاوت top-k و top-p چیست؟
در top-k فقط k توکن محتملتر نگه داشته میشوند و نمونهبرداری بین آنها انجام میشود. در top-p کوچکترین مجموعهای از توکنها نگه داشته میشود که مجموع احتمالشان به p برسد. top-p خودش را با شکل توزیع تطبیق میدهد و معمولاً انتخاب بهتری است.
چرا انتخاب حریصانه متن تکراری میسازد؟
چون در هر قدم فقط محتملترین توکن انتخاب میشود و مدل بهراحتی در یک حلقه گیر میکند؛ عبارتی را تولید میکند که محتملترین ادامهاش دوباره همان عبارت است. نمونهبرداری با کمی تصادف این حلقهها را میشکند.
دیدگاهها
هنوز دیدگاهی ثبت نشده است. شروعکننده باشید — پرسش و اصلاح را با آغوش باز میپذیریم.