
استخراج موجودیت نامدار همان کاری است که دستیار باید انجام دهد وقتی کاربر مینویسد «میخوام از شنبه تو دورهی پایتون پیشرفتهی شعبهی شیراز ثبتنام کنم». تشخیص اینکه کاربر میخواهد ثبتنام کند کافی نیست. دستیار باید نام دوره، تاریخ و شعبه را هم از جمله بیرون بکشد تا بتواند کاری انجام دهد.
در قسمتهای قبل بیشتر روی دستهبندی کل متن تمرکز داشتیم. در این قسمت یک قدم ریزتر میرویم و به هر کلمه برچسب میدهیم. استخراج موجودیت نامدار یا NER را میشناسیم، روش برچسبگذاری BIO را یاد میگیریم و با یک مدل فارسی آماده کار میکنیم.
نیت و اسلات؛ NER در دستیار گفتوگو
دستیارهای گفتوگو معمولاً پیام کاربر را در دو لایه میفهمند. لایهی اول نیت است؛ کاربر چه میخواهد؟ لایهی دوم اسلاتها هستند؛ پارامترهایی که برای انجام آن خواسته لازم است.
نیت با دستهبندی، اسلات با NER
برای جملهی بالا، نیت «ثبتنام» است. این را یک مدل دستهبندی متن تشخیص میدهد؛ همان کاری که در قسمتهای قبل کردیم. اما اسلاتها سه تا هستند؛ نام دوره «پایتون پیشرفته»، تاریخ «شنبه» و شعبه «شیراز».
دستیار بدون اسلاتها نمیتواند ثبتنام را انجام دهد. اگر یکی از آنها در پیام نباشد، باید بپرسد. مثلاً «ثبتنام برای کدام شعبه؟» این الگوی نیت و اسلات در دستیارهای صوتی و رباتهای پشتیبانی بسیار رایج است.
کاربردهای دیگر NER
NER فقط برای دستیار گفتوگو نیست. در تحلیل مقالههای پزشکی، نام بیماریها و داروها استخراج میشود. در اخبار، نام اشخاص، سازمانها و مکانها. در قراردادها، طرفین، مبالغ و تاریخها.
در سکوی آموزشی هم کاربردهای زیادی دارد. از بازخوردهای آزاد دانشجویان، نام استادان و دورههایی که از آنها تعریف یا انتقاد شده استخراج میشود. بعد این دادهی ساختاریافته با آمار تحلیل میشود.
NER بهعنوان طبقهبندی توکن
از نظر فنی، NER یک مسئلهی طبقهبندی توکن است. برای هر توکن ورودی، مدل یک برچسب پیشبینی میکند. تفاوتش با دستهبندی متن این است که خروجی یک برچسب نیست، دنبالهای از برچسبهاست؛ یکی برای هر توکن.
برچسبگذاری BIO
یک موجودیت ممکن است چند توکن باشد. «پایتون پیشرفته» دو توکن است، اما یک موجودیت. برای نشان دادن مرز موجودیتها، از برچسبگذاری BIO استفاده میشود. B یعنی ابتدای موجودیت، I یعنی ادامهی آن و O یعنی بیرون از هر موجودیت.
نوع موجودیت هم کنار این حرف میآید؛ مثلاً B-COURSE یا I-LOC. پس مدل در یک برچسب هم مرز و هم نوع را پیشبینی میکند. جدول زیر برچسبهای جملهی ابتدای این قسمت را نشان میدهد.
| توکن | برچسب |
|---|---|
| ثبتنام | O |
| در | O |
| دورهی | O |
| پایتون | B-COURSE |
| پیشرفته | I-COURSE |
| شعبهی | O |
| شیراز | B-LOC |
| از | O |
| شنبه | B-DATE |
چرا B و I هر دو لازماند؟
فرض کنید دو موجودیت همنوع پشت سر هم بیایند؛ مثلاً «دورههای پایتون و جاوا». اگر فقط برچسب COURSE داشتیم، نمیفهمیدیم «پایتون و جاوا» یک دوره است یا دو دوره. با BIO، «پایتون» برچسب B-COURSE و «جاوا» هم B-COURSE میگیرد. پس دو موجودیت جداگانهاند.
برچسب «و» بین آنها O است. این جزئیات کوچک در استخراج دقیق بسیار مهم است. روشهای دیگری مثل BIOES هم هستند که پایان موجودیت و موجودیت تکتوکنی را هم مشخص میکنند، اما BIO رایجترین است.
بیشتر بخوانید: معماری BERT و سازوکار توجه را که مدلهای امروزی NER بر آن ساخته شدهاند، در ترنسفورمر چیست؟ دیدیم.
مدلهای NER؛ از RNN تا BERT
چون NER طبقهبندی توکن است، هر مدلی که برای هر توکن یک خروجی بدهد، مناسب است. RNN دوطرفه که در قسمت ۴۴ دیدیم، یک انتخاب کلاسیک بود. در هر قدم، حالت پنهان به یک لایهی خطی داده میشود که برچسب آن توکن را پیشبینی میکند.
BERT برای طبقهبندی توکن
امروز بهترین نتیجهها با مدلهای BERT به دست میآید. یک لایهی خطی روی خروجی هر توکن BERT قرار میگیرد. چون BERT هر کلمه را با دیدن کل جمله میفهمد، تشخیص میدهد «شیراز» در «شعبهی شیراز» مکان است، اما در «رستوران شیراز» بخشی از نام یک سازمان است.
برای فارسی، مدلهای آمادهای روی دادهی NER فارسی تنظیم شدهاند. کد زیر یک مدل ParsBERT تنظیمشده برای NER را اجرا میکند و موجودیتها را با تجمیع زیرکلمهها برمیگرداند:
from transformers import pipeline

ner = pipeline("token-classification", model="HooshvareLab/bert-fa-zwnj-base-ner",
               aggregation_strategy="simple")
text = "علی رضایی از دانشگاه شیراز در کارگاه هوش مصنوعی تهران شرکت کرد."
for ent in ner(text):
    print(ent["entity_group"], ent["word"], round(ent["score"], 2))
مشکل زیرکلمهها
مدلهای BERT کلمات نادر را به چند زیرکلمه تقسیم میکنند. مثلاً «رضایی» ممکن است به دو توکن تبدیل شود. اما برچسبهای آموزشی در سطح کلمهاند. هنگام آموزش، باید برچسب هر کلمه را به زیرکلمههایش نسبت دهید.
روش رایج این است که فقط زیرکلمهی اول برچسب واقعی بگیرد و بقیه با عدد ویژهی -100 از محاسبهی خطا حذف شوند. در زمان استفاده هم aggregation_strategy زیرکلمهها را دوباره به کلمه و موجودیت کامل تبدیل میکند.
ارزیابی و ترکیب با قاعده
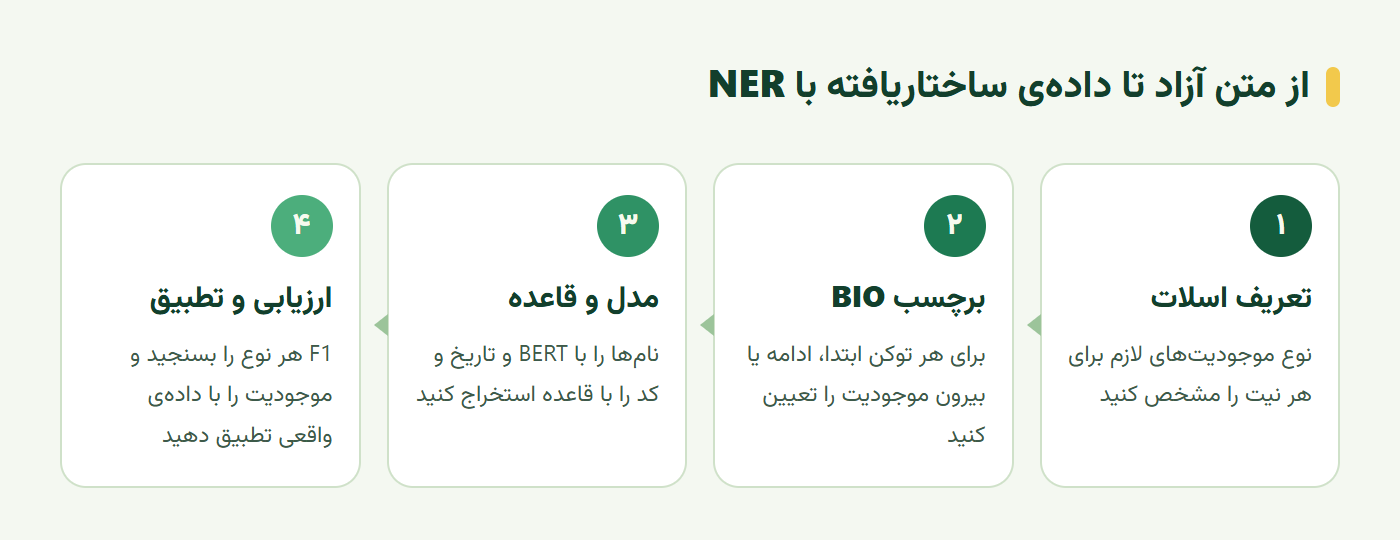
ارزیابی NER با طبقهبندی معمولی فرق دارد. دقت در سطح توکن گمراهکننده است، چون بیشتر توکنها O هستند. مدلی که همه را O بگوید، دقت توکنی بالایی دارد، اما هیچ موجودیتی پیدا نمیکند. نمودار زیر مسیر کامل استخراج و ارزیابی را نشان میدهد.
ارزیابی در سطح موجودیت
در ارزیابی درست، یک موجودیت فقط وقتی درست است که هم مرزش و هم نوعش دقیقاً درست باشد. اگر مدل «پایتون» را COURSE تشخیص دهد اما «پیشرفته» را جا بیندازد، این یک خطاست. کتابخانهی seqeval این نوع ارزیابی را انجام میدهد.
دقت مثبت، بازیابی و F1 را برای هر نوع موجودیت جداگانه گزارش کنید. ممکن است مدل مکانها را عالی پیدا کند، اما نام دورهها را ضعیف. چون مدل آماده روی اخبار آموزش دیده و نام دورههای شما را ندیده است.
ترکیب مدل با قاعده
برای موجودیتهایی با شکل قابل پیشبینی، قاعده اغلب از مدل بهتر است. تاریخ شمسی، شمارهی دانشجویی، کد دوره و مبلغ را با عبارتهای منظم دقیقتر پیدا میکنید. نام دورهها را هم میشود با تطبیق با فهرست دورههای موجود پیدا کرد.
بهترین سیستمها ترکیبیاند. مدل NER برای نام اشخاص و مکانها که تنوع زیاد دارند و قاعده برای الگوهای ثابت. در پایان، هر موجودیت استخراجشده را با دادهی واقعی تطبیق دهید. اگر نام دورهای که مدل پیدا کرده در فهرست نیست، از کاربر بپرسید.
تمرین عملی؛ اسلاتهای دستیار ثبتنام
برای نیت «ثبتنام در دوره» در دستیار آموزشی، این کارها را انجام دهید:
- تعریف اسلاتها: نام دوره، شعبه، تاریخ شروع و نوع کلاس را با نوع BIO مشخص کنید.
- برچسبگذاری: سی پیام واقعی یا ساختگی بنویسید و با BIO برچسب بزنید.
- مدل آماده: مدل NER فارسی را روی آنها اجرا کنید و ببینید کدام اسلاتها را پیدا میکند.
- قاعده: برای تاریخ و کد دوره عبارت منظم بنویسید.
- ارزیابی: F1 هر نوع موجودیت را با seqeval برای مدل و قاعده جداگانه حساب کنید.
احتمالاً میبینید مدل آماده نام دوره را نمیشناسد و قاعده برای تاریخ بهتر است. این نتیجه طراحی ترکیبی را توجیه میکند.
سخن پایانی
استخراج موجودیت نامدار متن آزاد را به دادهی ساختاریافته تبدیل میکند. در دستیار گفتوگو، کنار تشخیص نیت، اسلاتهای لازم را پر میکند. از نظر فنی طبقهبندی توکن است و با برچسبگذاری BIO مرز موجودیتها را مشخص میکند.
مدلهای BERT امروز بهترین نتیجه را میدهند، اما زیرکلمهها را باید درست مدیریت کرد. ارزیابی را در سطح موجودیت انجام دهید، نه توکن. و برای الگوهای ثابت مثل تاریخ و کد، قاعده را کنار مدل به کار ببرید.
این آموزش بر پایهی درس Named Entity Recognition از مجموعهی آزاد AI for Beginners مایکروسافت (مجوز MIT) به فارسی بازنویسی و تکمیل شده است.
پرسشهای پرتکرار
استخراج موجودیت نامدار چیست؟
استخراج موجودیت نامدار یا NER وظیفهای در پردازش زبان است که بخشهایی از متن را که به موجودیتهای مشخص اشاره میکنند پیدا و دستهبندی میکند؛ مثل نام شخص، سازمان، مکان، تاریخ یا نام محصول. نتیجه دادهی ساختاریافته از دل متن آزاد است.
برچسبگذاری BIO چیست؟
روشی برای برچسب زدن توکنها در NER است. B یعنی ابتدای یک موجودیت، I یعنی ادامهی همان موجودیت و O یعنی خارج از هر موجودیت. مثلاً در «دورهی پایتون پیشرفته»، «پایتون» برچسب B-COURSE و «پیشرفته» برچسب I-COURSE میگیرد.
تفاوت نیت و اسلات در دستیار چیست؟
نیت هدف کلی پیام کاربر است؛ مثلاً «ثبتنام در دوره». اسلاتها پارامترهای لازم برای انجام آن هدفاند؛ مثلاً نام دوره و تاریخ شروع. تشخیص نیت یک طبقهبندی متن است و پر کردن اسلاتها با استخراج موجودیت نامدار انجام میشود.
NER را چطور ارزیابی کنیم؟
در سطح موجودیت، نه توکن. یک موجودیت فقط وقتی درست است که مرز و نوعش کاملاً درست باشد. دقت مثبت، بازیابی و F1 برای هر نوع موجودیت جداگانه حساب میشود. کتابخانهی seqeval این محاسبه را انجام میدهد.
دیدگاهها
هنوز دیدگاهی ثبت نشده است. شروعکننده باشید — پرسش و اصلاح را با آغوش باز میپذیریم.