
تحلیل احساسات در ظاهر سادهترین وظیفهی NLP است؛ فقط باید بگوییم نظر مثبت است یا منفی. اما جملهی «عالی، باز هم کلاس کنسل شد» را در نظر بگیرید. کلمهی «عالی» مثبت است، اما هر فارسیزبانی میفهمد گوینده عصبانی است. همین ظرافتها تحلیل احساسات را از یک شمارش ساده به مسئلهای واقعی تبدیل میکند.
در قسمت قبل اطلاعات مشخصی مثل نام و تاریخ را از متن بیرون کشیدیم. در این قسمت دو وظیفهی دیگر روی همان متن را میبینیم؛ ترجمه و تحلیل احساسات. هر دو به فهم معنای کل جمله نیاز دارند، نه فقط کلمات. میبینیم چرا روشهای ساده شکست میخورند و مدلهای امروزی چطور بهتر عمل میکنند.
ترجمه ماشینی؛ از قاعده تا شبکه عصبی
ترجمه یکی از سختترین مسائل پردازش زبان است. هزاران زبان وجود دارد و هرکدام قواعد دستوری متفاوتی دارند. ترجمهی خوب فقط جایگزینی کلمات نیست؛ انتقال معناست با ساختاری که در زبان مقصد طبیعی باشد.
دام ترجمهی لفظی
یک مثال مشهور، جملهی انگلیسی «I feel happy» است. در زبان ایرلندی، این جمله «Tá athas orm» گفته میشود که ترجمهی لفظیاش «شادی بر من است» است. ساختار کاملاً متفاوت است؛ فعل اول، بعد صفت و در پایان فاعل.
فارسی هم پر از چنین نمونههایی است. «دلم برایت تنگ شده» اگر لفظی ترجمه شود، به جملهی بیمعنایی دربارهی تنگ شدن قلب میرسد. مترجم خوب معنا را منتقل میکند، نه کلمات را. برنامهای که فقط کلمه به کلمه جایگزین کند، ترجمههای بد و گاهی خندهدار میسازد.
سه نسل ترجمهی ماشینی
نسل اول ترجمهی ماشینی بر قاعده تکیه داشت. زبانشناسان قواعد دستوری هر جفت زبان را مینوشتند. نتیجه برای جملههای ساده قابل قبول بود، اما نگهداری هزاران قاعده ممکن نبود.
نسل دوم آماری بود. از میلیونها جملهی ترجمهشده توسط انسان، احتمال ترجمهی هر عبارت استخراج میشد. نسل سوم ترجمهی ماشینی عصبی است که با معماری رمزگذار-رمزگشا و بعد ترنسفورمر ساخته شد. امروز ترجمهی مدلهای عصبی در بسیاری از موارد به کیفیت مترجم انسانی نزدیک است.
وقتی ماشین از انسان بهتر ترجمه میکند
در درس اصلی، جملهی مشهور ابتدای رمان «غرور و تعصب» با ترجمهی ماشینی به فرانسوی برگردانده میشود. نتیجه جالب است. ترجمهی ماشینی از ترجمهی فرانسوی چاپشدهی این کتاب در سال ۱۹۳۲ دقیقتر است. مترجم انسانی آن زمان جزئیاتی به متن اضافه کرده بود که در اصل نبود.
این مثال نشان میدهد مدلهایی که روی حجم عظیم ترجمهی انسانی آموزش دیدهاند، چقدر قوی شدهاند. اما یادتان باشد؛ ترجمهی ماشینی هنوز در متنهای تخصصی، اصطلاحات محلی و طنز خطا میکند. برای متن حساس، بازبینی انسانی لازم است.
بیشتر بخوانید: معماری رمزگذار-رمزگشا و ترنسفورمر را که پشت ترجمهی ماشینی عصبی است، در ترنسفورمر چیست؟ توضیح دادهایم.
تحلیل احساسات؛ از واژهنامه تا یادگیری ماشین
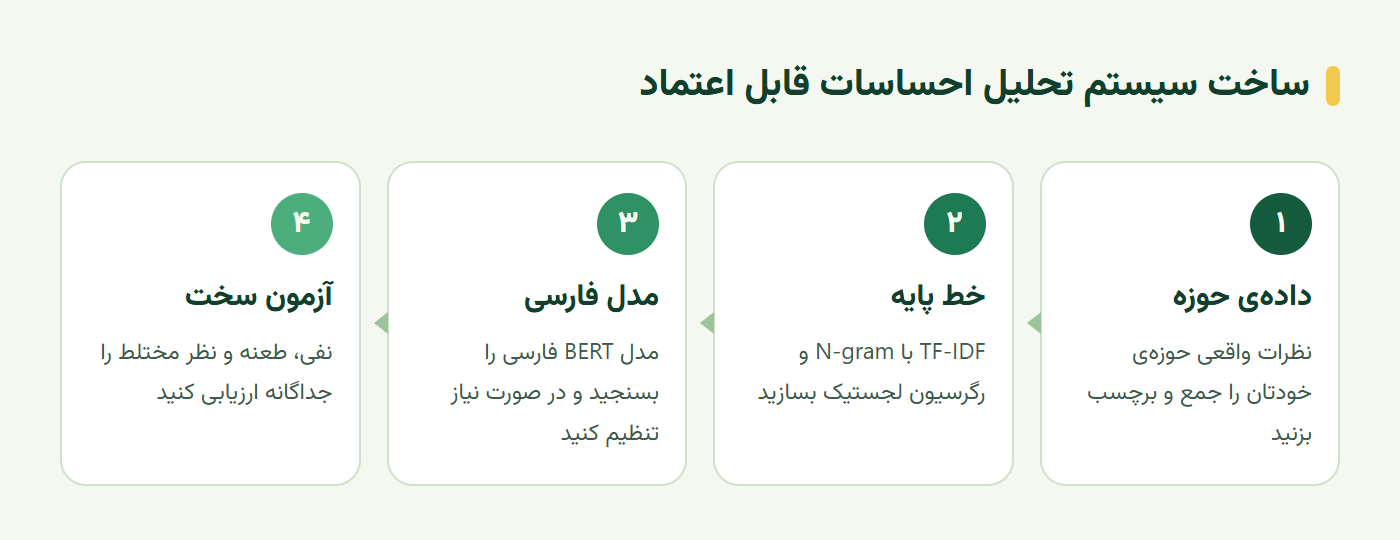
تحلیل احساسات لحن یا نگرش متن را تشخیص میدهد. برای یک سکوی آموزشی، کاربردهای زیادی دارد؛ پیدا کردن دانشجوهای ناراضی، خلاصه کردن بازخورد هر دوره و اولویتبندی پیامهای پشتیبانی. نمودار زیر مسیر ساخت یک سیستم تحلیل احساسات قابل اعتماد را نشان میدهد.
روش واژهنامه
سادهترین روش، واژهنامهای از کلمات مثبت و منفی است. «عالی»، «خوب» و «مفید» مثبتاند و «بد»، «ضعیف» و «خستهکننده» منفی. امتیاز متن مجموع امتیاز کلماتش است. سریع و قابل توضیح است.
اما این روش بهراحتی فریب میخورد. «اصلاً بد نبود» دو کلمهی منفی دارد اما مثبت است. «عالی، باز هم کلاس کنسل شد» یک کلمهی مثبت دارد اما منفی است. واژهنامه نفی، طعنه و بافت را نمیفهمد.
روش یادگیری ماشین
در روش یادگیری ماشین، هزاران نظر با برچسب مثبت یا منفی جمع میشود. مدل یاد میگیرد کدام الگوها با کدام برچسب همراهاند. با TF-IDF و رگرسیون لجستیک که در قسمتهای قبل دیدیم، یک خط پایهی قوی میسازید.
N-gram در این روش مهم است. «بد نبود» بهعنوان یک ویژگی جداگانه، نفی را تا حدی میگیرد. اما برای طعنه و بافت پیچیده، به مدلهایی نیاز داریم که کل جمله را بفهمند. مدلهای BERT فارسی که روی نظرات کاربران تنظیم شدهاند، همین کار را انجام میدهند.
تحلیل احساسات فارسی با مدل آماده
برای فارسی، مدلهای آمادهای روی نظرات کاربران سایتهای ایرانی تنظیم شدهاند. این مدلها با زبان محاوره و غلطهای املایی رایج آشنا هستند. کد زیر یکی از آنها را روی چند نظر اجرا میکند:
from transformers import pipeline
clf = pipeline("text-classification",
model="HooshvareLab/bert-fa-base-uncased-sentiment-snappfood")
reviews = [
"استاد خیلی خوب درس داد و تمرینها مفید بود",
"اصلاً بد نبود، فقط کمی طولانی بود",
"عالی، باز هم کلاس کنسل شد",
]
for r, p in zip(reviews, clf(reviews)):
print(p["label"], round(p["score"], 2), "|", r)حوزهی داده مهم است
این مدل روی نظرات سفارش غذا آموزش دیده است. زبان نظرات غذا با نظرات دورههای آموزشی فرق دارد. کلمهای مثل «سنگین» دربارهی غذا شاید منفی باشد، اما دربارهی یک دورهی پیشرفته لزوماً نه.
پس مدل آماده را روی نمونههای واقعی خودتان بسنجید. اگر دقتش کافی نیست، با چند صد نظر برچسبخورده از حوزهی خودتان، همان مدل را تنظیم دقیق کنید. همان ایدهی یادگیری انتقالی که در بخش بینایی دیدیم.
ترجمه، بعد تحلیل؟ معمولاً نه
یک وسوسهی رایج این است که متن فارسی را اول به انگلیسی ترجمه کنیم و بعد با ابزارهای قوی انگلیسی تحلیل کنیم. این کار معمولاً ایدهی خوبی نیست. ترجمه خطای خودش را اضافه میکند و ظرافتهایی مثل طعنه و لحن محاورهای در ترجمه گم میشوند.
دو خطای پشت سر هم، خطای کل را بزرگتر میکند. امروز مدلهای فارسی و چندزبانهی کافی وجود دارند که مستقیم روی متن فارسی کار کنند. ترجمه را فقط وقتی به کار ببرید که واقعاً هیچ مدلی برای زبان مبدأ ندارید.
ارزیابی تحلیل احساسات
مثل همهی وظایف دستهبندی، ارزیابی تحلیل احساسات هم به دادهی برچسبخوردهی مستقل نیاز دارد. اما چند نکتهی ویژه هم دارد.
نمونههای سخت را عمداً بگذارید
در مجموعهی آزمون، نمونههای سخت را عمداً بگذارید؛ نفی، طعنه، نظر مختلط و جملهی بسیار کوتاه. مدلی که روی نظرات ساده ۹۵ درصد دقت دارد، ممکن است روی طعنه تقریباً همیشه اشتباه کند.
دقت را برای هر نوع نمونه جداگانه گزارش کنید. همان ارزیابی تفکیکی که در قسمت سوگیری دیدیم. این کار نشان میدهد مدل کجا قابل اعتماد است و کجا نه.
خنثی و مختلط
بسیاری از نظرات نه مثبتاند و نه منفی. «کلاس ساعت ۱۰ برگزار شد» خنثی است. «استاد عالی بود ولی کلاس شلوغ بود» مختلط است. اگر مدل فقط دو دسته داشته باشد، این نمونهها را به زور در یکی جا میدهد.
برای تحلیل بازخورد، معمولاً تحلیل احساسات مبتنی بر جنبه مفیدتر است. یعنی برای هر جنبه، مثل استاد، محتوا و زمانبندی، احساس جداگانه تشخیص داده شود. این نتیجه برای بهبود دوره بسیار کاربردیتر از یک برچسب کلی است.
تمرین عملی؛ آزمون سخت برای تحلیل احساسات
یک مجموعهی آزمون کوچک اما سخت بسازید و سه روش را مقایسه کنید:
- بیست نظر ساده: ده مثبت و ده منفی روشن.
- بیست نظر سخت: نفی، طعنه، مختلط و بسیار کوتاه.
- روش واژهنامه: یک فهرست کوچک کلمات مثبت و منفی بسازید و امتیاز بدهید.
- روش TF-IDF: با رگرسیون لجستیک و N-gram یک و دو کلمهای.
- مدل آمادهی فارسی: مدل کد بالا.
دقت هر روش را برای نظرات ساده و سخت جداگانه گزارش کنید. فاصلهی این دو عدد برای هر روش، درس اصلی این تمرین است.
سخن پایانی
ترجمهی ماشینی از قاعده به آمار و بعد به شبکهی عصبی رسید. ترجمهی لفظی ساختار زبان مقصد را نادیده میگیرد، اما ترجمهی عصبی معنا را منتقل میکند. تحلیل احساسات هم از واژهنامهی ساده به مدلهایی رسید که بافت، نفی و گاهی طعنه را میفهمند.
برای فارسی، مستقیم با مدلهای فارسی یا چندزبانه کار کنید، نه ترجمه و بعد تحلیل. مدل آماده را روی دادهی حوزهی خودتان بسنجید و نمونههای سخت را عمداً در آزمون بگذارید. تحلیل احساسات مبتنی بر جنبه هم نتیجهی کاربردیتری از یک برچسب کلی میدهد.
این آموزش بر پایهی درس Translation and sentiment analysis with ML از مجموعهی آزاد ML for Beginners مایکروسافت (مجوز MIT) به فارسی بازنویسی و تکمیل شده است.
پرسشهای پرتکرار
تحلیل احساسات چیست؟
تحلیل احساسات وظیفهای در پردازش زبان است که لحن یا نگرش یک متن را تشخیص میدهد؛ معمولاً مثبت، منفی یا خنثی. برای تحلیل نظرات کاربران، بازخورد دورهها، پیامهای پشتیبانی و شبکههای اجتماعی کاربرد دارد.
چرا تحلیل احساسات با واژهنامه کافی نیست؟
چون فقط کلمات مثبت و منفی را میشمارد و بافت را نمیفهمد. جملهای مثل «عالی، باز هم کلاس کنسل شد» کلمهی مثبت دارد اما طعنهآمیز و منفی است. نفی مثل «اصلاً بد نبود» هم این روش را فریب میدهد.
آیا برای تحلیل احساسات فارسی باید متن را اول به انگلیسی ترجمه کرد؟
معمولاً نه. ترجمه خطای خودش را اضافه میکند و ظرافتهایی مثل طعنه و لحن محاورهای از بین میرود. امروز مدلهای فارسی و چندزبانهای هستند که مستقیم روی متن فارسی تحلیل احساسات انجام میدهند و نتیجهی بهتری دارند.
ترجمه ماشینی عصبی چه فرقی با ترجمه لفظی دارد؟
ترجمهی لفظی کلمه به کلمه جایگزین میکند و ساختار زبان مقصد را نادیده میگیرد. ترجمهی ماشینی عصبی کل جمله را میفهمد و معنای آن را با ساختار طبیعی زبان مقصد بیان میکند. به همین دلیل ترجمهاش روانتر و دقیقتر است.
دیدگاهها
هنوز دیدگاهی ثبت نشده است. شروعکننده باشید — پرسش و اصلاح را با آغوش باز میپذیریم.