
آموزش Hugging Face معمولاً با یک خط جادویی شروع میشود؛ pipeline("sentiment-analysis") و تمام. این یک خط برای شروع عالی است. اما روزی میرسد که خروجی عجیب است، جملهی طولانی خطا میدهد یا باید مدل را در سیستم خودتان مستقر کنید. آن روز باید بدانید پشت این یک خط چه اتفاقی میافتد.
در قسمتهای قبل چند بار از pipeline برای مدلهای فارسی استفاده کردیم. در این قسمت آخر بخش NLP، پرده را کنار میزنیم. سه مرحلهی پشت صحنهی pipeline را باز میکنیم؛ توکنساز، مدل و پسپردازش. هر مرحله را با یک مدل فارسی قدمبهقدم اجرا میکنیم.
Hugging Face و سه مرحله pipeline
Hugging Face مخزنی عمومی با صدها هزار مدل آماده است و کتابخانهی متنباز Transformers راه استاندارد استفاده از آنهاست. مدلهای فارسی زیادی هم در آن هست؛ از ParsBERT تا مدلهای چندزبانه.
سه مرحله در یک نگاه
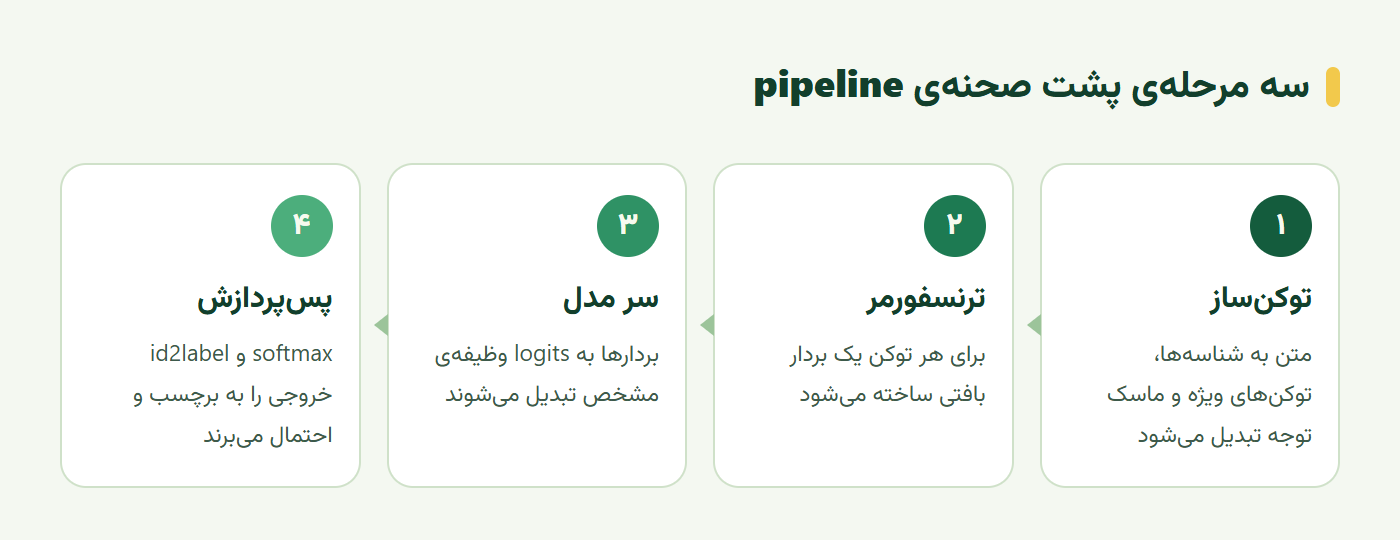
هر pipeline سه مرحله را پشت سر هم انجام میدهد. مرحلهی اول پیشپردازش با توکنساز است که متن را به عدد تبدیل میکند. مرحلهی دوم عبور از مدل است که عددها را به خروجی خام تبدیل میکند. مرحلهی سوم پسپردازش است که خروجی خام را به نتیجهی قابل فهم تبدیل میکند.
نکتهی مهم این است که توکنساز و مدل باید دقیقاً با هم جفت باشند. هر مدل با یک توکنساز مشخص آموزش دیده است. اگر توکنساز دیگری به کار ببرید، شناسهها معنای دیگری دارند و خروجی بیمعنا میشود. کلاسهای Auto این جفت را خودکار درست بارگذاری میکنند.
چرا باید پشت صحنه را بدانید؟
دانستن این سه مرحله در چند موقعیت ضروری است. وقتی میخواهید چند هزار متن را در دستههای بزرگ و سریع پردازش کنید. وقتی متن از طول مجاز مدل بلندتر است. وقتی میخواهید خروجی میانی مدل، مثل بردار جمله، را برای کار دیگری بگیرید.
و مهمتر از همه، وقتی نتیجه اشتباه است. اگر بدانید متن چطور توکن شده، اغلب علت خطا را فوراً پیدا میکنید. مثلاً میبینید نیمفاصلهها کلمه را به تکههای بیمعنا تقسیم کردهاند.
مرحله اول؛ توکنساز
توکنساز متن را به توکن تقسیم میکند و هر توکن را به یک شناسهی عددی از واژگان مدل تبدیل میکند. توکنسازهای مدلهای ترنسفورمر معمولاً زیرکلمهایاند. کلمات رایج یک توکناند و کلمات نادر به چند تکه تقسیم میشوند.
شناسهها و توکنهای ویژه
توکنساز علاوه بر کلمات، توکنهای ویژه هم اضافه میکند. در مدلهای BERT، توکن [CLS] در ابتدا و [SEP] در انتهای هر جمله میآید. مدل در آموزش یاد گرفته از بردار [CLS] برای دستهبندی کل جمله استفاده کند.
from transformers import AutoTokenizer
name = "HooshvareLab/bert-fa-base-uncased-sentiment-snappfood"
tok = AutoTokenizer.from_pretrained(name)
enc = tok(["کلاس خیلی مفید بود", "ویدئوها مدام قطع میشد و صدا ضعیف بود"],
padding=True, truncation=True, max_length=128, return_tensors="pt")
print(enc["input_ids"].shape)
print(tok.convert_ids_to_tokens(enc["input_ids"][0]))
print(enc["attention_mask"][0])padding، truncation و ماسک توجه
مدلها ورودی را به شکل تنسور میخواهند و همهی ردیفهای یک تنسور باید همطول باشند. پس جملههای کوتاهتر با توکن پرکننده بلند میشوند. به این کار padding میگویند. جملههایی که از max_length بلندترند هم بریده میشوند که truncation نام دارد.
ماسک توجه به مدل میگوید کدام توکنها واقعیاند و کدام پرکننده. خانههای یک یعنی توکن واقعی و صفر یعنی پرکننده. بدون این ماسک، مدل به توکنهای پرکننده هم توجه میکند و نتیجهی جملهی کوتاه تغییر میکند. همیشه attention_mask را همراه input_ids به مدل بدهید.
بیشتر بخوانید: نقش [CLS]، سازوکار توجه و معماری BERT را در ترنسفورمر چیست؟ از نزدیک دیدیم.
مرحله دوم؛ عبور از مدل
خروجی توکنساز مستقیم به مدل داده میشود. اما «مدل» در Hugging Face دو بخش دارد. بخش اصلی ترنسفورمر است که برای هر توکن یک بردار میسازد. بخش دوم سر مدل است که این بردارها را به خروجی وظیفهی مشخص تبدیل میکند. نمودار زیر این مسیر را نشان میدهد.
حالتهای پنهان؛ سه بعد
خروجی بخش اصلی ترنسفورمر، حالتهای پنهان است. این تنسور سه بعد دارد؛ اندازهی دسته، طول دنباله و اندازهی بردار پنهان. برای دو جمله با طول پانزده توکن و مدل پایهی BERT، شکلش دو در پانزده در ۷۶۸ است.
هر ردیف این تنسور، بردار بافتی یک توکن است که در قسمت امبدینگ دربارهاش حرف زدیم. اگر بردار جمله میخواهید، میتوانید میانگین این بردارها را با در نظر گرفتن ماسک توجه بگیرید. کلاس AutoModel فقط همین بخش را بدون سر برمیگرداند.
سر مدل؛ از بردار به وظیفه
برای هر وظیفه، سر متفاوتی روی ترنسفورمر قرار میگیرد. AutoModelForSequenceClassification یک لایهی خطی روی بردار [CLS] دارد و برای هر دسته یک عدد میدهد. AutoModelForTokenClassification برای هر توکن جداگانه، که در NER دیدیم.
import torch
from transformers import AutoModelForSequenceClassification

model = AutoModelForSequenceClassification.from_pretrained(name).eval()
with torch.no_grad():
    out = model(**enc)
print(out.logits.shape)       # (تعداد جمله، تعداد دسته)
print(out.logits)
مرحله سوم؛ پسپردازش
خروجی مدل با سر دستهبندی، logits است. logits عدد خام است و احتمال نیست. میتواند منفی یا بزرگتر از یک باشد. برای تبدیل به احتمال، باید از softmax عبور کند.
از logits تا برچسب
softmax logits را به احتمالهایی تبدیل میکند که جمعشان یک است. بعد محتملترین دسته انتخاب میشود. اما مدل فقط شمارهی دسته را میداند. نام دسته در پیکربندی مدل، در id2label، ذخیره شده است:
probs = torch.softmax(out.logits, dim=-1)
for p in probs:
    i = int(p.argmax())
    print(model.config.id2label[i], round(float(p[i]), 3))
حالا دقیقاً همان کاری را انجام دادیم که pipeline در یک خط میکند. اما این بار کنترل کامل داریم. میتوانیم دستههای بزرگ بفرستیم، آستانهی دلخواه بگذاریم یا احتمال همهی دستهها را ذخیره کنیم.
نکتههای استقرار
در استقرار واقعی، چند نکته را رعایت کنید. مدل را یک بار هنگام شروع برنامه بارگذاری کنید، نه برای هر درخواست. model.eval() و torch.no_grad() را فراموش نکنید؛ اولی Dropout را خاموش میکند و دومی حافظه و زمان را کم.
متنهای طولانیتر از حد مجاز را آگاهانه مدیریت کنید. truncation بیصدا انتهای متن را حذف میکند و ممکن است مهمترین بخش در همان انتها باشد. برای متن بلند، آن را به تکههایی با همپوشانی تقسیم کنید و نتیجهها را ترکیب کنید.
تمرین عملی؛ pipeline دستی
با یک مدل فارسی دستهبندی متن، این کارها را انجام دهید:
- مقایسه: نتیجهی
pipelineو نسخهی دستی سهمرحلهای را روی ده جمله مقایسه کنید؛ باید یکسان باشند. - توکنها: توکنهای پنج جمله با نیمفاصلهی درست و نادرست را ببینید و تفاوت را بنویسید.
- ماسک توجه: یک جملهی کوتاه را یک بار تنها و یک بار در دسته با یک جملهی بلند اجرا کنید و logits را مقایسه کنید.
- متن بلند: یک متن هزارکلمهای را با truncation و با تکهبندی پردازش کنید و نتیجه را مقایسه کنید.
تمرین سوم نشان میدهد ماسک توجه چرا مهم است. اگر نتیجهی جملهی کوتاه در دسته عوض شد، جایی ماسک را فراموش کردهاید.
سخن پایانی
pipeline در Hugging Face سه مرحله دارد؛ توکنساز متن را به شناسههای عددی و ماسک توجه تبدیل میکند، مدل با بخش اصلی ترنسفورمر و سر وظیفه logits میسازد و پسپردازش با softmax و id2label آن را به برچسب و احتمال تبدیل میکند.
توکنساز و مدل همیشه باید جفت باشند و ماسک توجه همیشه همراه شناسهها برود. با دانستن این سه مرحله، از یک خط جادویی به کنترل کامل میرسید. همین دانش پایهی استفاده از مدلهای زبانی بزرگ در قسمتهای بعدی است.
این آموزش بر پایهی بخشهای Behind the pipeline و Models از دورهی آزاد Hugging Face (مجوز Apache 2.0) به فارسی بازنویسی و تکمیل شده است.
پرسشهای پرتکرار
Hugging Face چیست؟
Hugging Face شرکت و جامعهای است که کتابخانهی متنباز Transformers و یک مخزن عمومی با صدها هزار مدل آماده را ارائه میکند. با آن میشود مدلهای زبانی، بینایی و صوتی را با چند خط کد بارگذاری، اجرا و تنظیم دقیق کرد.
pipeline در Hugging Face چه کاری انجام میدهد؟
pipeline سه مرحله را پشت سر هم انجام میدهد؛ متن را با توکنساز به شناسههای عددی تبدیل میکند، آنها را از مدل عبور میدهد و خروجی خام مدل را به نتیجهی قابل فهم مثل برچسب و احتمال تبدیل میکند.
ماسک توجه چیست؟
ماسک توجه برداری از صفر و یک است که به مدل میگوید کدام توکنها واقعیاند و کدام پرکننده. وقتی چند جمله با طول متفاوت را در یک دسته میفرستید، جملههای کوتاه با توکن پرکننده بلند میشوند و ماسک توجه جلوی توجه مدل به آنها را میگیرد.
logits چیست؟
logits خروجی خام لایهی آخر مدل است؛ یک عدد برای هر دسته که هنوز احتمال نیست و میتواند منفی یا بزرگتر از یک باشد. با عبور از تابع softmax، logits به احتمالهایی تبدیل میشوند که جمعشان یک است.
دیدگاهها
هنوز دیدگاهی ثبت نشده است. شروعکننده باشید — پرسش و اصلاح را با آغوش باز میپذیریم.