
طبقهبندی متن در آموزشها معمولاً با یک مجموعهدادهی تمیز و برچسبخورده شروع میشود. در پروژهی واقعی اما هیچکدام از اینها را ندارید. هزاران بازخورد آزاد دارید که کسی برچسبشان نزده است. نمیدانید چه دستههایی لازم است و ستونهایی دارید که به نظر مفیدند اما گمراهکنندهاند.
در چند قسمت قبل ابزارهای NLP را یکییکی دیدیم؛ پیشپردازش، امبدینگ، ترنسفورمر، NER و تحلیل احساسات. در این قسمت همه را در یک پروژهی کامل کنار هم میگذاریم. اول با یک مجموعهدادهی بزرگ واقعی کار میکنیم و بعد یک طبقهبند بازخورد دورهها را از صفر طراحی میکنیم.
طبقهبندی متن در پروژه واقعی از کجا شروع میشود؟
بیشتر پروژههای طبقهبندی متن با این جمله شروع میشوند: «میخواهیم بفهمیم کاربران دربارهی چه چیزهایی شکایت دارند.» این هنوز یک مسئلهی طبقهبندی نیست. باید آن را به دستههای مشخص، دادهی برچسبخورده و معیار موفقیت تبدیل کنید.
چهار سؤال پیش از هر کد
پیش از نوشتن هر خط کد، به این چهار سؤال پاسخ دهید:
- تصمیم: نتیجهی طبقهبندی به چه تصمیمی کمک میکند؟
- دستهها: چه دستههایی لازم است و آیا یک متن میتواند چند دسته داشته باشد؟
- داده: چه دادهای داریم و آیا ستونی هست که بتواند برچسب باشد؟
- معیار: چه دقتی برای کدام دسته کافی است؟
پاسخ سؤال اول همهچیز را تعیین میکند. اگر هدف این است که شکایتهای مربوط به پرداخت به تیم مالی برود، دستهی «پرداخت» باید بازیابی بالایی داشته باشد. از دست دادن یک شکایت مالی از چند ارجاع اشتباه بدتر است.
شناخت داده؛ ۵۱۵ هزار نظر هتل
برای دیدن مشکلات دادهی واقعی، با مجموعهدادهی ۵۱۵ هزار نظر هتلهای اروپا از Kaggle کار میکنیم. هر ردیف نظر یک مسافر دربارهی یک هتل است. ستونهایی مثل نام هتل، امتیاز کاربر، ملیت، نظر مثبت، نظر منفی و برچسبهای سفر دارد.
مقادیر جایگزین پنهان
این داده دو ستون متنی جدا برای نظر مثبت و منفی دارد. اگر کاربر چیزی ننوشته باشد، به جای خالی گذاشتن، عبارت «No Negative» یا «No Positive» آمده است. این همان مقدار گمشدهی پنهانی است که در قسمت تحلیل اکتشافی دیدیم.
اگر این عبارتها را پاک نکنید، مدل یاد میگیرد «No Negative» یعنی نظر مثبت. در آزمون عالی کار میکند و روی دادهی واقعی شکست میخورد. کد زیر آنها را به مقدار خالی تبدیل و تعدادشان را گزارش میکند:
import pandas as pd

df = pd.read_csv("Hotel_Reviews.csv")
for col, placeholder in [("Negative_Review", "No Negative"), ("Positive_Review", "No Positive")]:
    mask = df[col].str.strip().eq(placeholder)
    print(col, "placeholders:", round(mask.mean() * 100, 1), "%")
df.loc[mask, col] = pd.NAستونهایی که به نظر مفیدند
ستون امتیاز کاربر بین ۲٫۵ و ۱۰ است. هیچ توضیحی نیست که چرا کمترین امتیاز ۲٫۵ است. ستون تعداد کلمات منفی به نظر نشانهی نارضایتی است، اما بعضی کاربران در خانهی نظر منفی نوشتهاند «هیچ مشکلی نبود». پس تعداد کلمات منفی لزوماً یعنی نارضایتی نیست.
درس مهم این است؛ هر ستون را پیش از استفاده بررسی کنید. اگر میخواهید امتیاز کاربر را برچسب تحلیل احساسات قرار دهید، اول همبستگیاش با احساس متن را بسنجید. در درس اصلی، امتیاز تحلیل احساسات خودکار با امتیاز کاربر همبستگی دارد، اما کامل نیست. بخشی از این اختلاف خطای ابزار است و بخشی رفتار واقعی کاربران.
بیشتر بخوانید: مدل آمادهی تحلیل احساسات فارسی و مشکل نفی و طعنه را در تحلیل احساسات و ترجمه ماشینی با مثال دیدیم.
طراحی طبقهبند بازخورد دورهها
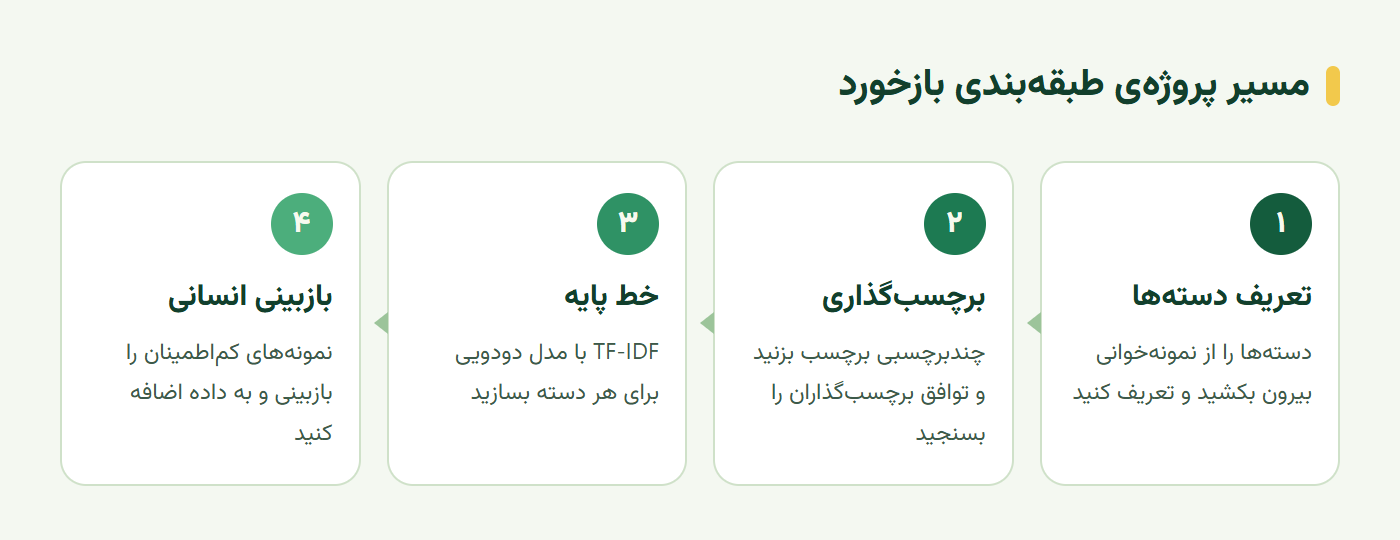
حالا همین نگاه را به پروژهی خودمان میبریم. یک سکوی آموزشی هزاران بازخورد آزاد از دانشجویان دارد. میخواهیم هر بازخورد را به جنبههایی که دربارهاش است دستهبندی کنیم. نمودار زیر مسیر کامل پروژه را نشان میدهد.
تعریف دستهها با نمونهخوانی
دستهها را از ذهن ننویسید. دویست بازخورد تصادفی را بخوانید و یادداشت کنید هرکدام دربارهی چیست. بعد یادداشتها را گروهبندی کنید. احتمالاً به دستههایی مثل محتوا، استاد، تمرین، سکوی آنلاین، زمانبندی و قیمت میرسید.
برای هر دسته یک تعریف کتبی و دو مثال مرزی بنویسید. همان کاری که در قسمت طبقهبندی در یادگیری ماشین گفتیم. یک دستهی «سایر» هم لازم است، اما اگر بیش از ده درصد داده در آن افتاد، دستهها ناقصاند.
چندبرچسبی، نه چندکلاسه
بازخورد «استاد عالی بود ولی ویدئوها مدام قطع میشد» هم دربارهی استاد است و هم دربارهی سکو. اگر مسئله را چندکلاسه تعریف کنید، یکی از این دو اطلاعات از دست میرود. بیشتر بازخوردهای واقعی چندبرچسبیاند.
در طبقهبندی چندبرچسبی، برای هر دسته یک تصمیم دودویی جداگانه گرفته میشود. پس هر دسته آستانهی خودش را دارد. این به شما اجازه میدهد برای دستههای مهمتر، مثل «قیمت» که به تیم مالی میرود، آستانه را پایینتر بگذارید تا بازیابی بالاتر باشد.
ساخت، ارزیابی و بهبود
با تعریف دستهها و چند صد بازخورد برچسبخورده، نوبت ساخت مدل است. مثل همیشه، از خط پایهی ساده شروع میکنیم.
خط پایهی چندبرچسبی
کد زیر یک طبقهبند چندبرچسبی با TF-IDF و رگرسیون لجستیک میسازد. برای هر دسته یک مدل دودویی جداگانه آموزش میبیند:
from sklearn.feature_extraction.text import TfidfVectorizer
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import classification_report
from sklearn.multiclass import OneVsRestClassifier
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import MultiLabelBinarizer

mlb = MultiLabelBinarizer()
Y = mlb.fit_transform(labels)            # مثلاً [["استاد"], ["استاد", "سکو"], ...]
model = make_pipeline(TfidfVectorizer(ngram_range=(1, 2), min_df=2),
                      OneVsRestClassifier(LogisticRegression(max_iter=1000, class_weight="balanced")))
model.fit(train_texts, Y[train_idx])
print(classification_report(Y[test_idx], model.predict(test_texts), target_names=mlb.classes_))
از خط پایه تا مدل بهتر
گزارش طبقهبندی برای هر دسته دقت مثبت، بازیابی و F1 را نشان میدهد. دستههایی که F1 پایینی دارند را بررسی کنید. معمولاً یا نمونهی کمی دارند یا تعریفشان با دستهی دیگری همپوشانی دارد.
قدم بعد تنظیم دقیق یک مدل BERT فارسی برای طبقهبندی چندبرچسبی است. این مدلها بافت را میفهمند و معمولاً چند درصد بهتر عمل میکنند. اما فقط وقتی سراغشان بروید که خط پایه و تعریف دستهها محکم شده باشد. مدل قویتر، تعریف بد را درست نمیکند.
چرخهی بازبینی انسانی
پس از استقرار، مدل کامل نیست. پیشبینیهایی که اطمینان پایینی دارند را به یک صف بازبینی انسانی بفرستید. کارشناس برچسب درست را میزند و این نمونهها به دادهی آموزش اضافه میشوند.
این چرخه دو فایده دارد. مدل بهتدریج روی سختترین نمونهها بهتر میشود. و وقتی موضوع تازهای در بازخوردها ظاهر میشود، مثلاً یک مشکل فنی جدید، کارشناس زود متوجه میشود. شاید وقت اضافه کردن یک دستهی تازه باشد.
تمرین عملی؛ طبقهبند بازخورد خودتان
این پروژه را روی بازخوردهای واقعی یا نمونهی ساختگی اجرا کنید:
- نمونهخوانی: دویست بازخورد را بخوانید و دستهها را از داده بیرون بکشید.
- تعریفها: برای هر دسته تعریف کتبی و دو مثال مرزی بنویسید.
- برچسبگذاری: پانصد بازخورد را چندبرچسبی برچسب بزنید و توافق دو نفر را روی پنجاه نمونه بسنجید.
- خط پایه: کد بالا را اجرا کنید و F1 هر دسته را گزارش دهید.
- آستانهها: برای دستهی مهمتر، آستانهای انتخاب کنید که بازیابی دستکم ۹۰ درصد باشد.
در پایان، یک صفحه گزارش با قالب قسمت داستانسرایی با داده بنویسید؛ تصمیم، عدد اصلی، محدودیت و قدم بعد.
سخن پایانی
پروژهی واقعی طبقهبندی متن با تصمیم، دستهها، داده و معیار شروع میشود، نه با مدل. دادهی هتلها نشان داد مقادیر جایگزین پنهان و ستونهای بهظاهر مفید چطور مدل را گمراه میکنند. هر ستون را پیش از استفاده بررسی کنید.
برای بازخورد کاربران، دستهها را از نمونهخوانی بیرون بکشید و مسئله را چندبرچسبی تعریف کنید. از خط پایهی TF-IDF شروع کنید، آستانهی هر دسته را بر اساس اهمیتش تنظیم کنید و با چرخهی بازبینی انسانی، مدل را در طول زمان بهتر کنید.
این آموزش بر پایهی درسهای Sentiment analysis with hotel reviews و ادامهی آن از مجموعهی آزاد ML for Beginners مایکروسافت (مجوز MIT) به فارسی بازنویسی و تکمیل شده است.
پرسشهای پرتکرار
طبقهبندی متن چیست؟
طبقهبندی متن وظیفهای در پردازش زبان است که به هر متن یک یا چند برچسب از میان دستههای از پیش تعریفشده میدهد؛ مثل موضوع پیام، نوع شکایت یا احساس نظر. پایهی بسیاری از سیستمهای پشتیبانی و تحلیل بازخورد است.
طبقهبندی چندبرچسبی چه فرقی با چندکلاسه دارد؟
در طبقهبندی چندکلاسه هر متن دقیقاً یک برچسب میگیرد. در چندبرچسبی، هر متن میتواند چند برچسب همزمان داشته باشد؛ مثلاً بازخوردی که هم دربارهی استاد است و هم دربارهی قیمت. بیشتر بازخوردهای واقعی چندبرچسبیاند.
برای شروع پروژه طبقهبندی متن به چند نمونه برچسبخورده نیاز داریم؟
برای یک خط پایه با TF-IDF، چند صد نمونه برای هر دسته معمولاً کافی است. برای تنظیم دقیق یک مدل BERT هم چند صد تا چند هزار نمونه نتیجهی خوبی میدهد. مهمتر از تعداد، کیفیت و ثبات برچسبهاست.
چرا امتیاز عددی کاربر با احساس متن همیشه یکی نیست؟
چون کاربران گاهی نظر منفی مینویسند اما امتیاز بالا میدهند، یا برعکس. بعضی هم در خانهی نظر منفی چیز مثبتی مینویسند؛ مثل «هیچ مشکلی نبود». پیش از استفاده از امتیاز بهعنوان برچسب، رابطهاش با متن را بررسی کنید.
دیدگاهها
هنوز دیدگاهی ثبت نشده است. شروعکننده باشید — پرسش و اصلاح را با آغوش باز میپذیریم.