
فاینتیون ترنسفورمر همان کاری است که وقتی مدل آماده روی دادهی شما به اندازهی کافی خوب نیست، انجام میدهید. در قسمت تحلیل احساسات دیدیم مدلی که روی نظرات سفارش غذا آموزش دیده، با زبان بازخورد دورههای آموزشی کاملاً آشنا نیست. چند صد نمونهی برچسبخورده از حوزهی خودتان کافی است تا همان مدل را برای کار شما تنظیم کنید.
در قسمت ۵۰ دیدیم پشت صحنهی pipeline چه میگذرد. در قسمت ۳۲ هم حلقهی آموزش را دستی در PyTorch نوشتیم. حالا این دو را کنار هم میگذاریم. در این قسمت یک مدل BERT را با کتابخانههای datasets و Trainer برای دستهبندی متن فاینتیون میکنیم. تمرکز ما روی کنترل آزمایش است؛ اینکه نتیجه قابل اعتماد و تکرارپذیر باشد.
فاینتیون ترنسفورمر؛ کی و چرا؟
فاینتیون تنها راه بهبود نتیجه نیست. پیش از آن، دو گزینهی ارزانتر را امتحان کنید. اول، یک مدل آماده که روی وظیفهی مشابهی تنظیم شده است. دوم، برای مدلهای زبانی بزرگ، پرامپت بهتر با چند مثال.
نشانههای نیاز به فاینتیون
فاینتیون وقتی ارزش دارد که وظیفهی شما مشخص و تکرارشونده است؛ مثل دستهبندی هزاران بازخورد در روز. همچنین وقتی مدل آماده روی دادهی شما دقت کافی ندارد و چند صد تا چند هزار نمونهی برچسبخورده دارید.
یک مدل BERT کوچک فاینتیونشده برای دستهبندی، معمولاً از یک مدل زبانی بزرگ با پرامپت ارزانتر، سریعتر و پایدارتر است. میتوانید آن را روی سرور خودتان اجرا کنید و داده از سازمان بیرون نمیرود. اما به دادهی برچسبخورده و کمی زحمت آموزش نیاز دارد.
خط پایه را فراموش نکنید
پیش از فاینتیون، خط پایهی TF-IDF و رگرسیون لجستیک را بسازید؛ همان که در قسمت ۴۹ ساختیم. اگر فاینتیون فقط یک درصد بهتر است، شاید پیچیدگیاش ارزش نداشته باشد. اگر ده درصد بهتر است، کاملاً ارزش دارد.
خط پایه یک فایدهی دیگر هم دارد. اگر فاینتیون بدتر از خط پایه شد، میدانید جایی خطا دارید؛ مثلاً نرخ یادگیری خیلی بزرگ یا برچسبهای جابهجا. بدون خط پایه، نتیجهی بد ممکن است عادی به نظر برسد.
آمادهسازی داده با datasets
کتابخانهی datasets داده را به شکلی نگه میدارد که برای آموزش مدلهای ترنسفورمر بهینه است. از فایل CSV، JSON یا مجموعهدادههای مخزن Hugging Face داده را میخواند. عملیات روی داده هم با map و بهصورت دستهای انجام میشود.
بارگذاری و تقسیم ثابت
داده را یک بار تقسیم کنید و تقسیم را ذخیره کنید. اگر هر بار تقسیم تازهای بسازید، نتیجهی اجراهای مختلف قابل مقایسه نیست. بذر تصادفی ثابت و ذخیرهی تقسیم، پایهی آزمایش قابل تکرار است:
from datasets import load_dataset
ds = load_dataset("csv", data_files="feedback.csv")["train"]
ds = ds.class_encode_column("label")
splits = ds.train_test_split(test_size=0.2, seed=42, stratify_by_column="label")
splits.save_to_disk("feedback_splits") # همین تقسیم در همهی اجراهاتوکنسازی دستهای با map
توکنساز را با map روی کل داده اجرا میکنیم. پارامتر batched=True توکنسازی را بهصورت دستهای و بسیار سریعتر انجام میدهد. توکنسازهای سریع Hugging Face به Rust نوشته شدهاند و از این کار بیشترین بهره را میبرند.
نکتهی مهم این است که اینجا padding نمیکنیم. فقط truncation تا طول بیشینه. padding را به مرحلهی ساخت دسته میسپاریم تا هر دسته فقط تا طول بلندترین جملهی خودش پر شود. به این کار padding پویا میگویند.
بیشتر بخوانید: توکنساز، ماسک توجه و سر مدل را که اینجا با Trainer آموزش میدهیم، در آموزش Hugging Face Transformers باز کردیم.
آموزش با Trainer
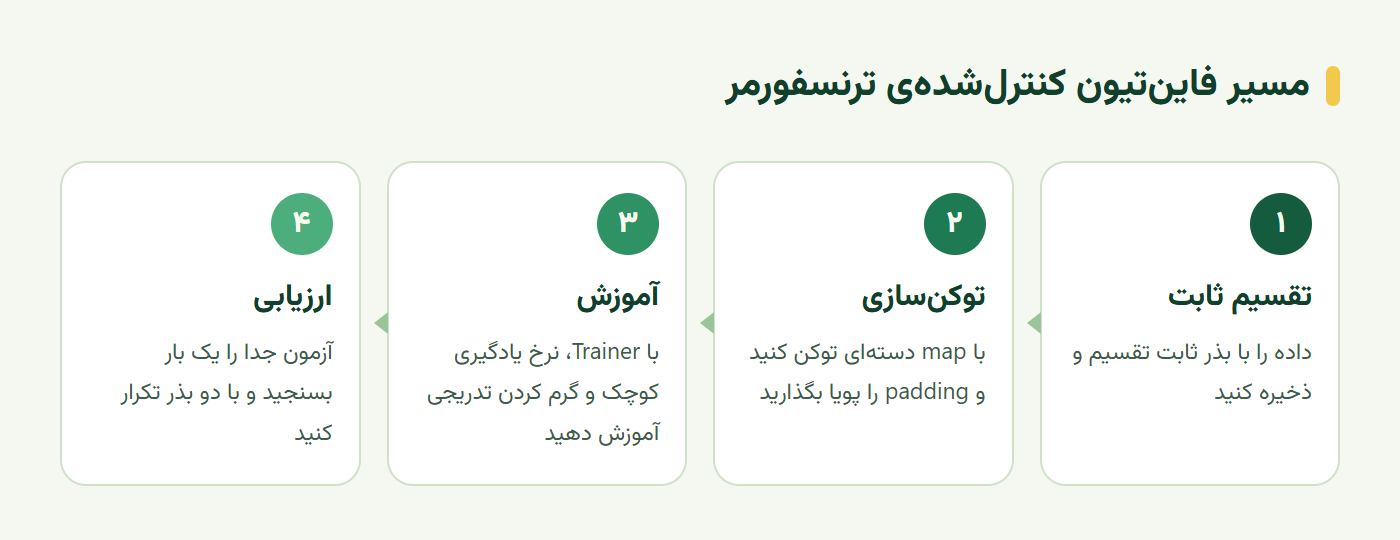
Trainer حلقهی آموزشی را که در قسمت ۳۲ دستی نوشتیم، با همهی جزئیات حرفهای آماده دارد. ارزیابی دورهای، ذخیرهی نقطهی بازیابی، زمانبندی نرخ یادگیری و آموزش روی چند پردازندهی گرافیکی. نمودار زیر مسیر کامل فاینتیون را نشان میدهد.
پیکربندی و اجرا
کد زیر یک مدل BERT فارسی را برای دستهبندی بازخورد فاینتیون میکند. DataCollatorWithPadding همان padding پویاست:
import numpy as np
from datasets import load_from_disk
from sklearn.metrics import f1_score
from transformers import (AutoModelForSequenceClassification, AutoTokenizer,
                          DataCollatorWithPadding, Trainer, TrainingArguments, set_seed)

set_seed(42)
base = "HooshvareLab/bert-fa-base-uncased"
tok = AutoTokenizer.from_pretrained(base)
splits = load_from_disk("feedback_splits").map(
    lambda b: tok(b["text"], truncation=True, max_length=256), batched=True)
n = splits["train"].features["label"].num_classes
model = AutoModelForSequenceClassification.from_pretrained(base, num_labels=n)

def metrics(p):
    return {"macro_f1": f1_score(p.label_ids, np.argmax(p.predictions, -1), average="macro")}

args = TrainingArguments("out", learning_rate=3e-5, per_device_train_batch_size=16,
                         num_train_epochs=4, warmup_ratio=0.1, weight_decay=0.01,
                         eval_strategy="epoch", save_strategy="epoch",
                         load_best_model_at_end=True, metric_for_best_model="macro_f1")
trainer = Trainer(model=model, args=args, train_dataset=splits["train"],
                  eval_dataset=splits["test"], data_collator=DataCollatorWithPadding(tok),
                  compute_metrics=metrics)
trainer.train()
نرخ یادگیری و زمانبندی
نرخ یادگیری مهمترین ابرپارامتر فاینتیون است. مدل آماده دانش ارزشمندی دارد و نرخ بزرگ آن را خراب میکند. بازهی رایج بین دو و پنج در ده به توان منفی پنج است. همان ایدهای که در یادگیری انتقالی تصویر هم دیدیم.
warmup_ratio نرخ یادگیری را در ده درصد اول آموزش از صفر به مقدار اصلی میرساند. بعد نرخ بهتدریج و بهصورت خطی تا صفر کم میشود. این زمانبندی آموزش را پایدارتر میکند. در درس اصلی، همین کار با زمانبندی کاهش چندجملهای در Keras انجام میشود.
ارزیابی و کنترل آزمایش
آموزش تمام شد و یک عدد F1 دارید. آیا این عدد قابل اعتماد است؟ چند عادت ساده جواب این سؤال را مثبت میکند.
یک آزمون ثابت، یک بار
در کد بالا، برای سادگی، دادهی آزمون در انتخاب بهترین دوره هم به کار رفت. در پروژهی واقعی این کار نشت است. داده را سهقسمتی کنید؛ آموزش، اعتبارسنجی برای انتخاب دوره و ابرپارامتر، و آزمون که فقط یک بار در پایان سنجیده میشود.
پس از آموزش، پیشبینیها را با trainer.predict بگیرید و گزارش طبقهبندی را برای هر دسته ببینید. ماتریس درهمریختگی نشان میدهد کدام دستهها با هم اشتباه گرفته میشوند. ده نمونهی اشتباه را هم با چشم بخوانید؛ گاهی برچسب اشتباه است، نه مدل.
ثبت همهچیز
برای هر اجرا، نسخهی مدل پایه، نسخهی کتابخانهها، بذر تصادفی، ابرپارامترها و عدد نهایی را ثبت کنید. TrainingArguments را میشود در یک فایل ذخیره کرد. نسخهی دقیق مدل پایه را هم با پارامتر revision ثابت کنید.
یک آزمون سادهی قابل تکرار بودن هم انجام دهید. همان اجرا را با دو بذر مختلف تکرار کنید. اگر F1 بیش از یکی دو درصد فرق کرد، تفاوتهای کوچک بین تنظیمات مختلف را جدی نگیرید. این همان نگاه آماری است که در قسمت هفتم دیدیم.
تمرین عملی؛ فاینتیون کنترلشده
با بازخوردهای برچسبخوردهی قسمت ۴۹ یا یک مجموعهدادهی فارسی عمومی، این آزمایش را انجام دهید:
- خط پایه: F1 کلان TF-IDF و رگرسیون لجستیک را روی تقسیم ذخیرهشده ثبت کنید.
- فاینتیون: کد بالا را با تقسیم سهقسمتی اجرا کنید.
- نرخ یادگیری: سه نرخ ۱e-5، ۳e-5 و ۱e-4 را امتحان کنید و منحنی خطای اعتبارسنجی را مقایسه کنید.
- دو بذر: بهترین تنظیم را با دو بذر تکرار کنید و اختلاف را گزارش دهید.
- خطاها: ده نمونهی اشتباه را بخوانید و علت هرکدام را بنویسید.
احتمالاً میبینید نرخ ۱e-4 آموزش را ناپایدار میکند. این تجربه اهمیت نرخ یادگیری کوچک را ملموستر از هر توضیحی نشان میدهد.
سخن پایانی
فاینتیون ترنسفورمر یک مدل آماده را با دادهی شما برای وظیفهی مشخصی تنظیم میکند. کتابخانهی datasets داده را با map و padding پویا آماده میکند و Trainer حلقهی آموزش را با ارزیابی، ذخیره و زمانبندی نرخ یادگیری اجرا میکند. نرخ یادگیری کوچک با گرم کردن تدریجی، کلید آموزش پایدار است.
مهمتر از خود آموزش، کنترل آزمایش است. تقسیم ثابت و ذخیرهشده، آزمون جداگانه که یک بار سنجیده میشود، ثبت همهی تنظیمات و تکرار با بذرهای مختلف. بدون اینها، عدد نهایی فقط یک عدد است، نه یک نتیجه.
این آموزش بر پایهی بخشهای Fine-tuning a model with Keras و Processing the data از دورهی آزاد Hugging Face (مجوز Apache 2.0) به فارسی بازنویسی و تکمیل شده است.
پرسشهای پرتکرار
فاینتیون ترنسفورمر چیست؟
فاینتیون یا تنظیم دقیق یعنی یک مدل ترنسفورمر از پیش آموزشدیده، مثل BERT، را با دادهی برچسبخوردهی خودتان برای یک وظیفهی مشخص، مثل دستهبندی متن، بیشتر آموزش دهید. وزنهای مدل کمی تغییر میکنند تا با وظیفه و دادهی شما هماهنگ شوند.
padding پویا چیست؟
به جای اینکه همهی جملهها تا طول بیشینهی کل داده پر شوند، هر دسته فقط تا طول بلندترین جملهی همان دسته پر میشود. این کار محاسبات هدررفته روی توکنهای پرکننده را کم میکند و آموزش را سریعتر میکند.
چرا نرخ یادگیری در فاینتیون باید کوچک باشد؟
چون وزنهای مدل آماده دانش ارزشمندی از پیشآموزش دارند. نرخ یادگیری بزرگ این دانش را سریع خراب میکند. نرخهای رایج بین دو در ده به توان منفی پنج و پنج در ده به توان منفی پنجاند و معمولاً در طول آموزش بهتدریج کم میشوند.
چطور آزمایش فاینتیون را قابل تکرار کنیم؟
بذر تصادفی را ثابت کنید، نسخهی مدل پایه و کتابخانهها را ثبت کنید، تقسیم داده را ذخیره کنید و همهی ابرپارامترها را در یک فایل پیکربندی نگه دارید. نتیجهی هر اجرا را با همان دادهی آزمون ثابت گزارش کنید.
دیدگاهها
هنوز دیدگاهی ثبت نشده است. شروعکننده باشید — پرسش و اصلاح را با آغوش باز میپذیریم.