
پایگاه داده برداری در بیشتر آموزشها با یک خط شروع و تمام میشود؛ بردارها را اضافه کن و جستجو کن. اما شش ماه بعد، آییننامهی آموزشگاه عوض شده و دستیار هنوز قانون قدیمی را نقل میکند. یک دانشجو درخواست حذف دادهاش را داده و نمیدانید قطعههای متن او کجای نمایهاند. اینها مشکلات واقعیاند و از طراحی نمایه میآیند، نه از الگوریتم جستجو.
در قسمت امبدینگ دیدیم متن چطور به بردار تبدیل میشود و شباهت کسینوسی نزدیکی معنا را میسنجد. در این قسمت یک قدم مهندسی جلوتر میرویم. یاد میگیریم نمایهی برداری را طوری طراحی کنیم که بهروزرسانی، حذف و کنترل دسترسی در آن ممکن و قابل آزمون باشد.
پایگاه داده برداری چیست؟
پایگاه دادهی برداری بردارها را همراه فراداده ذخیره میکند و برای یک بردار پرسش، نزدیکترین بردارها را سریع پیدا میکند. برای چند هزار بردار، حتی جستجوی کامل با NumPy کافی است. برای میلیونها بردار، الگوریتمهای جستجوی تقریبی مثل HNSW لازماند.
جایگاه نمایه در RAG
در RAG، اسناد به قطعه تقسیم میشوند، هر قطعه به بردار تبدیل میشود و در نمایه ذخیره میشود. هنگام پرسش، پرسش هم به بردار تبدیل میشود، نزدیکترین قطعهها بازیابی میشوند و همراه پرسش به مدل زبانی داده میشوند. مدل پاسخ را بر اساس همین قطعهها مینویسد.
درس اصلی همین مسیر را با کتابخانهی scikit-learn و جستجوی نزدیکترین همسایه نشان میدهد. برای شروع عالی است. اما در محصول واقعی، پرسش مهم این نیست که جستجو چطور کار میکند. پرسش این است که وقتی داده عوض میشود، نمایه چطور درست میماند.
نمایه یک نسخهی مشتق است
اصل اول طراحی این است: نمایهی برداری منبع حقیقت نیست. سند اصلی در مخزن معتبر نگهداری میشود؛ پایگاه داده، سیستم مدیریت محتوا یا فایلهای رسمی. بردار فقط کمکی برای پیدا کردن آن است.
این نگاه تصمیمها را ساده میکند. اگر نمایه خراب شد، از روی منبع دوباره ساخته میشود. اگر سندی حذف شد، نمایه باید از منبع پیروی کند. هیچ اطلاعاتی نباید فقط در نمایه وجود داشته باشد.
شناسهها و فراداده؛ ستون فقرات نمایه
بیشتر مشکلات نگهداری از شناسههای ضعیف میآیند. اگر فقط نام فایل را شناسه بگذارید، با تغییر نام یا نسخهی تازه، رابطهی بردارها با سند گم میشود. جدول زیر فیلدهای ضروری هر رکورد نمایه را نشان میدهد.
| فیلد | نقش |
|---|---|
| شناسهی سند | پایدار؛ با تغییر متن عوض نمیشود |
| نسخهی سند | نشان میدهد قطعه از کدام نسخه آمده است |
| شناسهی قطعه | قطعی؛ از شناسهی سند، نسخه و جایگاه قطعه ساخته میشود |
| منشأ قابل نمایش | عنوان، بخش یا صفحه برای نشان دادن منبع به کاربر |
| مالک و دسترسی | چه کسی اجازهی دیدن این قطعه را دارد |
| مدل و روش قطعهبندی | نام و نسخهی مدل بردارساز و روش تقسیم متن |
شناسهی قطعی به جای تصادفی
شناسهی قطعه را تصادفی نسازید. اگر اتصال قطع شود و عملیات تکرار شود، شناسهی تصادفی تازه یعنی رکورد تکراری. همان متن دو بار در نمایه مینشیند و در نتایج جستجو دو بار ظاهر میشود.
شناسهی قطعی، مثلاً ترکیب شناسهی سند، نسخه و شمارهی قطعه، این مشکل را حل میکند. اجرای دوباره همان رکورد را بازنویسی میکند. به این ویژگی عملیات تکرارپذیر یا idempotent میگویند و برای هر سیستمی که با شبکه کار میکند ضروری است.
منشأ قابل نمایش
شناسهی داخلی برای اتصال رکوردها مناسب است، اما برای کاربر معنایی ندارد. برای نمایش منبع، عنوان سند، بخش و صفحه را کنار قطعه ذخیره کنید. دستیاری که میگوید «طبق بند ۴ آییننامهی ثبتنام» قابل اعتمادتر از دستیاری است که فقط پاسخ میدهد.
آزمون ارجاع را هم فراموش نکنید. از نتیجهی جستجو به قطعهی اصلی بروید و بررسی کنید متن واقعاً در همان نسخهی سند هست. اگر فقط آخرین نسخه را نگه میدارید، ارجاع به نسخهی قدیمی ممکن است به متنی اشاره کند که دیگر وجود ندارد.
بیشتر بخوانید: امبدینگ، بردار جمله و شباهت کسینوسی را که این نمایه روی آن ساخته میشود، در امبدینگ کلمه چیست؟ دیدیم.
افزودن و بهروزرسانی سند
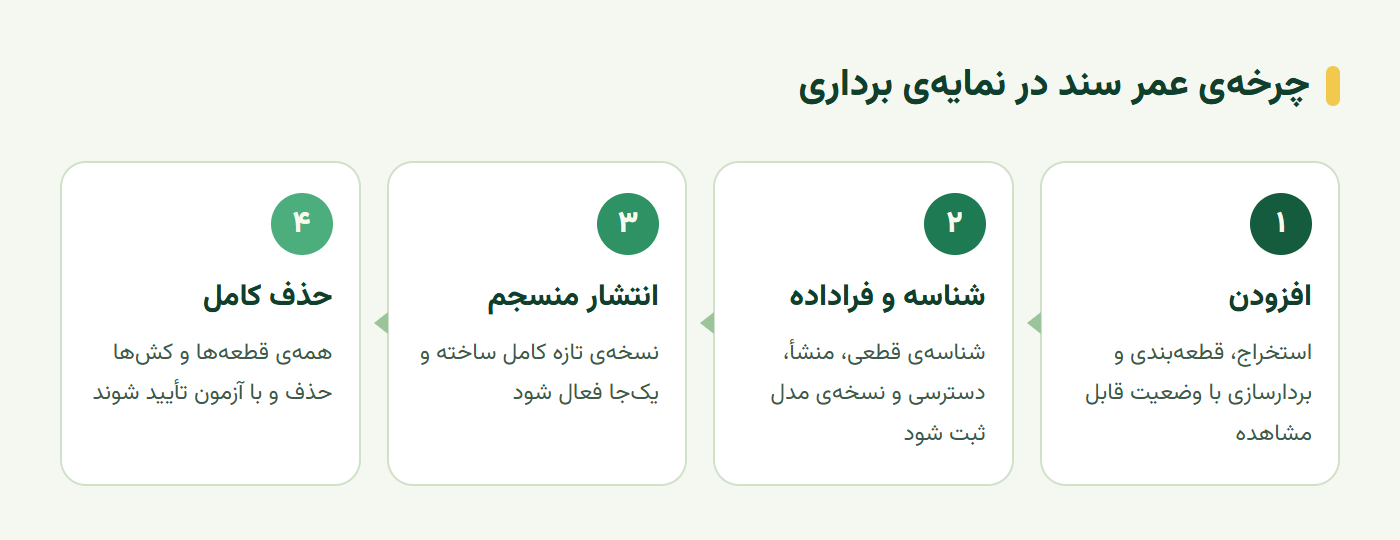
افزودن سند چند مرحله دارد و هر مرحله شکست خودش را دارد. دریافت فایل، استخراج متن، قطعهبندی، ساخت بردار و ثبت در نمایه. نمودار زیر چرخهی کامل عمر یک سند در نمایه را نشان میدهد.
مسیر چندمرحلهای قابل مشاهده
وضعیت هر مرحله را در یک رکورد ثبت کنید؛ شناسهی کار، نسخهی هدف، مرحلهی فعلی و آخرین خطای قابل فهم. اینطور سند نیمهپردازششده با سند آماده اشتباه گرفته نمیشود. اگر استخراج متن یک PDF شکست خورد، میدانید دقیقاً کجا.
دادهی حساس یا کلید سرویس را در پیام خطا ذخیره نکنید. پیام خطا باید برای عیبیابی کافی باشد، اما خودش راه نشت اطلاعات نشود. همان اصلی که در قسمت اخلاق داده دیدیم.
انتشار منسجم نسخهی تازه
فرض کنید نسخهی تازهی یک جزوه ده قطعه دارد. اگر قطعهها یکییکی جایگزین شوند، در فاصلهی بهروزرسانی، جستجو ترکیبی از نسخهی قدیم و جدید را میبیند. دستیار ممکن است نیمی از قانون قدیم و نیمی از قانون جدید را کنار هم نقل کند.
راهحل انتشار منسجم است. نسخهی تازه را کامل بسازید، بعد با یک تغییر، نسخهی فعال را عوض کنید. این کار با فضای نام جدا، شناسهی نسل نمایه یا یک اشارهگر نسخهی فعال در فراداده ممکن است. جستجو فقط قطعههای نسخهی فعال را برمیگرداند.
حذف، دسترسی و تغییر مدل
سه موضوع دیگر معمولاً دیر به ذهن میرسد و دیر شدنشان گران تمام میشود. حذف کامل، کنترل دسترسی و تغییر مدل بردارساز. هر سه را از روز اول در طراحی بگذارید.
حذف سند و همهی مشتقات
حذف فایل اصلی بهتنهایی تضمین نمیکند قطعهها، بردارها و نسخههای کششده هم حذف شوند. برای هر سند، مسیر همهی مشتقاتش را قابل ردگیری نگه دارید. با شناسهی پایدار سند، حذف همهی قطعهها یک پرسوجوی ساده است.
آزمون حذف را با یک عبارت منحصربهفرد انجام دهید. عبارتی را در سند آزمایشی بگذارید که جای دیگری نیست. پیش از حذف باید بازیابی شود و پس از حذف دیگر نه. این آزمون را در هر تغییر سیستم تکرار کنید.
کنترل دسترسی در سمت سرویس
اگر اسناد به کاربران یا گروههای مختلف تعلق دارند، مرز مالکیت را در فراداده ثبت کنید. فیلتر دسترسی را در سمت سرویس و بر اساس هویت معتبر اعمال کنید، نه با خواهش از مدل زبانی. مدل نباید اصلاً قطعهای را ببیند که کاربر اجازهاش را ندارد.
برای آزمون، دو سند با متن یکسان اما مالکان متفاوت بسازید. شباهت برداری آنها یکسان است؛ پس فقط کنترل دسترسی تعیین میکند کدام برگردد. اگر کاربر الف قطعهی کاربر ب را دید، مشکل امنیتی جدی دارید.
سازگاری مدل بردارساز
نام مدل و طول بردار را در مشخصات نمایه ثبت کنید. اگر مدل عوض شد، بردارهای قدیم با پرسشهای جدید قابل مقایسه نیستند، حتی اگر طولشان یکی باشد. فضای برداری هر مدل مخصوص خودش است.
تغییر مدل یعنی ساخت دوبارهی کل نمایه. نمایهی تازه را کنار قدیمی بسازید، با مجموعهی ثابتی از پرسشها و پاسخهای مورد انتظار کیفیت بازیابی را مقایسه کنید و فقط اگر بهتر بود، سوئیچ کنید. نمایهی سریعتری که اسناد درست را پیدا نکند، بهتر نیست.
تمرین عملی؛ آزمونهای نمایه
برای نمایهی دستیار آموزشی، این آزمونها را طراحی و اجرا کنید:
- تکرار عملیات: یک سند را دو بار اضافه کنید و بررسی کنید تعداد قطعهها دو برابر نشده باشد.
- نسخهی تازه: نسخهی دوم یک سند را منتشر کنید و مطمئن شوید هیچ پرسشی ترکیب دو نسخه را برنمیگرداند.
- حذف: با عبارت منحصربهفرد، حذف کامل را آزمون کنید.
- دسترسی: با دو کاربر و دو سند هممتن، فیلتر دسترسی را بسنجید.
- تغییر مدل: کیفیت بازیابی دو مدل بردارساز را روی بیست پرسش ثابت مقایسه کنید.
نتیجه را در یک جدول با ستونهای «عملیات، رفتار مورد انتظار، نتیجه» ثبت کنید. این جدول مستندات نگهداری نمایهی شماست.
سخن پایانی
پایگاه دادهی برداری فقط جای ذخیرهی بردار نیست؛ نسخهای مشتق از دادهی شماست که باید با آن همگام بماند. شناسهی پایدار سند، شناسهی قطعی قطعه و فرادادهی کامل ستون فقرات این همگامیاند.
مسیر افزودن را چندمرحلهای و قابل مشاهده کنید، نسخهی تازه را منسجم منتشر کنید، حذف را کامل و قابل آزمون کنید، دسترسی را در سمت سرویس کنترل کنید و با تغییر مدل، نمایه را دوباره بسازید. این طراحی تفاوت یک نمایش آزمایشی با سیستمی است که سالها کار میکند.
این آموزش بر پایهی درس Retrieval Augmented Generation and Vector Databases از مجموعهی آزاد Generative AI for Beginners مایکروسافت (مجوز MIT) به فارسی بازنویسی و تکمیل شده است.
پرسشهای پرتکرار
پایگاه داده برداری چیست؟
پایگاه داده برداری سیستمی است که بردارهای عددی، مثل امبدینگ متن، را همراه فراداده ذخیره میکند و برای یک بردار پرسش، نزدیکترین بردارها را سریع پیدا میکند. پایهی جستجوی معنایی و RAG است.
چه فرادادهای کنار بردار باید ذخیره شود؟
دستکم شناسهی پایدار سند، نسخهی سند، شناسهی قطعه، عنوان و محل قطعه در سند برای نمایش منبع، مالک یا سطح دسترسی، نام و نسخهی مدل بردارساز و نسخهی روش قطعهبندی.
وقتی مدل امبدینگ را عوض میکنیم چه باید کرد؟
بردارهای مدل قدیم با پرسشهای مدل جدید قابل مقایسه نیستند، حتی اگر طولشان یکی باشد. باید کل نمایه را با مدل جدید دوباره بسازید، کیفیت بازیابی را با آزمون ثابت بسنجید و بعد به نمایهی جدید سوئیچ کنید.
چطور مطمئن شویم سند حذفشده دیگر در پاسخها نمیآید؟
برای هر سند مسیر همهی مشتقاتش را نگه دارید؛ قطعهها، بردارها و کشها. هنگام حذف همه را پاک کنید و با یک عبارت منحصربهفرد آزمون بگیرید که پیش از حذف بازیابی میشد و بعد از آن دیگر نمیشود.
دیدگاهها
هنوز دیدگاهی ثبت نشده است. شروعکننده باشید — پرسش و اصلاح را با آغوش باز میپذیریم.