
مدل زبانی بزرگ چیست و چرا دستیاری که همهی پرسشهای عمومی را عالی جواب میدهد، دربارهی ساعت کلاس فردای آموزشگاه شما با اطمینان کامل پاسخ غلط میدهد؟ پاسخ در سازوکار این مدلهاست. LLM برای نوشتن متن محتمل ساخته شده، نه برای دانستن حقیقت. تا این تفاوت را نفهمید، محصول قابل اعتمادی روی آن نمیسازید.
در پنجاه قسمت قبل مسیری طولانی را رفتیم؛ از داده و آمار تا شبکهی عصبی، بینایی و پردازش زبان. در قسمت ترنسفورمر دیدیم GPT از خانوادهی رمزگشاست. در این قسمت همهی این قطعهها را کنار هم میگذاریم تا بفهمیم مدل زبانی بزرگ چیست. بعد شش محدودیت مهمش را برای طراحی محصول میشناسیم.
چگونه به هوش مصنوعی مولد رسیدیم؟
هوش مصنوعی مولد نتیجهی دههها تحول است. شناختن این مسیر کمک میکند بفهمید چرا مدلهای امروزی اینطور رفتار میکنند. هر مرحله محدودیت مرحلهی قبل را حل کرد.
از قاعده تا یادگیری آماری
نخستین رباتهای گفتوگو، مثل ELIZA، بر پایگاه دانش و قاعدههای دستی تکیه داشتند. هر پرسش با کلمات کلیدی به یک پاسخ آماده وصل میشد. این روش مقیاسپذیر نبود و با هر پرسش پیشبینینشده شکست میخورد.
در دههی ۱۹۹۰، رویکرد آماری آمد. یادگیری ماشین الگوها را از داده بیرون میکشید، بدون اینکه کسی قاعده بنویسد. مدلها میتوانستند موضوع یک متن را تشخیص دهند یا نیت کاربر را حدس بزنند. اما هنوز نمیتوانستند متن طبیعی و روان تولید کنند.
از دستیارهای مجازی تا ترنسفورمر
با رشد توان سختافزار و داده، شبکههای عصبی و بهویژه RNNها پیشرفت بزرگی در فهم زبان ساختند. دستیارهای مجازی نسل قبل از همین فناوری استفاده میکردند. نیت کاربر را میفهمیدند و کار از پیش تعریفشدهای را انجام میدادند.
جهش اصلی با ترنسفورمر آمد. سازوکار توجه اجازه داد مدلها روی حجم بیسابقهای از متن موازی آموزش ببینند. وقتی اندازهی مدل و داده بهطور همزمان بزرگ شد، تواناییهایی ظاهر شد که کسی صریحاً آموزش نداده بود؛ از خلاصهسازی تا نوشتن کد.
مدل زبانی بزرگ چطور کار میکند؟
در هستهی هر مدل زبانی بزرگ یک کار ساده قرار دارد. با گرفتن متن تا اینجا، توکن بعدی را پیشبینی کن. همان کاری که در قسمت تولید متن دیدیم. تفاوت در مقیاس است؛ میلیاردها پارامتر و صدها میلیارد توکن متن آموزشی.
توکن و پنجرهی زمینه
مدل متن را بهصورت توکن میبیند، نه کلمه یا نویسه. در انگلیسی هر توکن حدود سهچهارم یک کلمه است. در فارسی معمولاً هر کلمه به توکنهای بیشتری تقسیم میشود. این یعنی متن فارسی برای همان محتوا توکن و هزینهی بیشتری دارد.
پنجرهی زمینه حداکثر توکنی است که مدل در یک درخواست میبیند. همهچیز باید در آن جا شود؛ دستور سیستم، تاریخچهی گفتوگو، اسناد و خود پاسخ. مدل حافظهی دیگری ندارد. آنچه در پنجره نیست، برای مدل وجود ندارد.
پیشآموزش و تنظیم برای گفتوگو
ساخت یک دستیار مبتنی بر LLM دو مرحلهی اصلی دارد. در پیشآموزش، مدل روی متن عظیم اینترنت فقط پیشبینی توکن بعدی را یاد میگیرد. نتیجه مدلی است که زبان را میشناسد، اما لزوماً به پرسشها جواب نمیدهد؛ فقط متن را ادامه میدهد.
در مرحلهی دوم، مدل با نمونههای پرسش و پاسخ و بازخورد انسانی برای گفتوگو تنظیم میشود. همان یادگیری تقویتی که در قسمت ۲۹ دیدیم، اینجا با پاداشی از ترجیح انسان به کار میرود. حالا مدل یاد گرفته دستور را دنبال کند، مفید باشد و از بعضی درخواستها خودداری کند.
بیشتر بخوانید: برای مقایسهی عملی مدلهای زبانی با آزمون واقعی محصول خودتان، انتخاب مدل زبانی را بخوانید.
شش محدودیت مدل زبانی بزرگ برای محصول
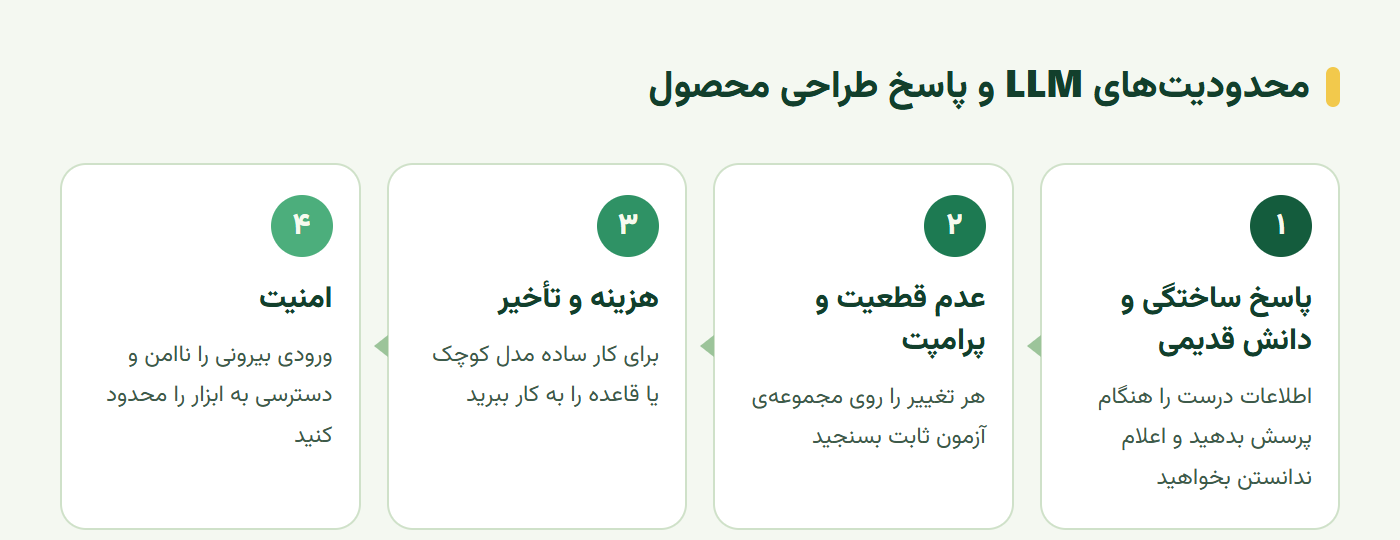
قدرت LLMها واقعی است. اما هر محصولی که روی آنها ساخته میشود، باید محدودیتهایشان را بشناسد و برایشان طراحی کند. نمودار زیر شش محدودیت اصلی و پاسخ طراحی هرکدام را خلاصه میکند.
پاسخ ساختگی و تاریخ قطع دانش
مهمترین محدودیت، پاسخ ساختگی یا توهم است. مدل برای تولید متن محتمل آموزش دیده، نه متن درست. وقتی پاسخ را نمیداند، اغلب متنی محتمل و مطمئن میسازد. منبعی نقل میکند که وجود ندارد یا ساعتی برای کلاس میگوید که هرگز تعیین نشده است.
محدودیت دوم تاریخ قطع دانش است. دانش مدل به دادهی آموزش محدود است. از رویدادهای بعد از آن، و از هر دادهی خصوصی سازمان شما، خبر ندارد. راهحل هر دو محدودیت یکی است؛ اطلاعات درست را در زمان پرسش به مدل بدهید و از او بخواهید فقط از همان پاسخ دهد. این همان ایدهی RAG است.
عدم قطعیت و حساسیت به پرامپت
محدودیت سوم، تغییر پاسخ در اجراهای مختلف است. حتی با دمای پایین، پاسخها همیشه کاملاً یکسان نیستند. محدودیت چهارم، حساسیت به عبارتبندی پرامپت است. یک تغییر کوچک در پرسش گاهی پاسخ را بهکلی عوض میکند.
پاسخ طراحی به این دو، آزمون سیستماتیک است. مجموعهای از پرسشهای واقعی با پاسخ مورد انتظار بسازید. هر تغییر پرامپت یا مدل را روی کل این مجموعه بسنجید، نه با چند امتحان دستی.
هزینه، تأخیر و امنیت
محدودیت پنجم هزینه و زمان پاسخ است. هر توکن ورودی و خروجی هزینه دارد و پاسخ طولانی چند ثانیه طول میکشد. برای کارهای ساده، مدل کوچکتر یا حتی قاعدهی ساده ارزانتر و سریعتر است.
محدودیت ششم امنیت است. مدل هر متنی را که در پنجرهی زمینه باشد، بهعنوان دستور احتمالی میخواند. اگر یک سند یا ایمیل دستور مخربی داشته باشد، مدل ممکن است آن را اجرا کند. به این حمله تزریق پرامپت میگویند. هر ورودی بیرونی را ناامن فرض کنید و دسترسی مدل به ابزارها را محدود کنید.
مدل زبانی بزرگ در دستیار آموزشی
حالا به سناریوی مجموعه برگردیم؛ یک استارتاپ آموزشی که میخواهد دستیار هوشمند بسازد. LLM کجا ارزش واقعی میسازد و کجا خطر دارد؟
جاهایی که LLM میدرخشد
LLM در کارهای زبانی باز عالی است. توضیح یک مفهوم به زبان ساده برای دانشجوی مبتدی، ساختن تمرینهای متنوع، خلاصه کردن بازخوردهای یک دوره و پیشنویس پاسخ به ایمیلها از این جملهاند. در همهی اینها، یک پاسخ «کاملاً درست» وجود ندارد و تنوع ارزش است.
برای معلم هم کاربردهای زیادی دارد. پیشنویس طرح درس، ایده برای فعالیت کلاسی و بازخورد اولیه روی نوشتهی دانشجو. در همهی این موارد، انسان خروجی را بازبینی میکند و تصمیم نهایی با اوست.
جاهایی که LLM بهتنهایی کافی نیست
برای پرسشهایی که پاسخ قطعی از دادهی سازمان دارند، LLM بهتنهایی خطرناک است. ساعت کلاس، نمرهی دانشجو، شرایط بازپرداخت شهریه. این پاسخها باید از پایگاه داده یا سند رسمی بیایند. LLM فقط میتواند آنها را به زبان طبیعی بیان کند.
قاعدهی طراحی ساده است. هر جا اشتباه پرهزینه است، LLM نباید منبع حقیقت باشد. منبع حقیقت دادهی شماست و LLM رابط زبانی آن. این همان اصلی است که از قسمت اول با «از مسئله شروع کنید، نه از ابزار» شروع کردیم.
تمرین عملی؛ نقشهی ریسک LLM
برای دستیار آموزشی یا محصول خودتان، این جدول را پر کنید:
- ده کار: ده کاری که میخواهید LLM انجام دهد را فهرست کنید.
- پاسخ قطعی: برای هر کار مشخص کنید آیا پاسخ قطعی از دادهی سازمان دارد یا باز است.
- هزینهی خطا: هزینهی یک پاسخ اشتباه را کم، متوسط یا زیاد علامت بزنید.
- منبع حقیقت: برای کارهای قطعی، منبع داده را نام ببرید.
- آزمون: برای هر کار دستکم سه پرسش آزمون با پاسخ مورد انتظار بنویسید.
کارهایی که پاسخ قطعی و هزینهی خطای بالا دارند، باید با دادهی سازمان و بازبینی طراحی شوند، نه با LLM تنها.
سخن پایانی
مدل زبانی بزرگ یک ترنسفورمر عظیم است که با پیشبینی توکن بعدی روی متن عظیم آموزش دیده و بعد برای گفتوگو تنظیم شده است. متن را بهصورت توکن میبیند و فقط آنچه در پنجرهی زمینه است را میداند. همین سازوکار ساده، تواناییهای شگفتانگیزی ساخته است.
اما شش محدودیت را فراموش نکنید؛ پاسخ ساختگی، تاریخ قطع دانش، عدم قطعیت، حساسیت به پرامپت، هزینه و امنیت. محصول قابل اعتماد روی این محدودیتها طراحی میشود. دادهی شما منبع حقیقت است و LLM رابط زبانی آن.
این آموزش بر پایهی درس Introduction to Generative AI and Large Language Models از مجموعهی آزاد Generative AI for Beginners مایکروسافت (مجوز MIT) به فارسی بازنویسی و تکمیل شده است.
پرسشهای پرتکرار
مدل زبانی بزرگ چیست؟
مدل زبانی بزرگ یا LLM یک شبکهی عصبی ترنسفورمر با میلیاردها پارامتر است که روی حجم عظیمی از متن آموزش دیده تا توکن بعدی را پیشبینی کند. همین توانایی ساده، پس از تنظیم برای گفتوگو، به پاسخ دادن، خلاصه کردن، ترجمه و نوشتن کد میرسد.
توهم یا پاسخ ساختگی در مدل زبانی چیست؟
یعنی مدل پاسخی روان و مطمئن میدهد که نادرست یا ساختگی است؛ مثلاً منبعی را نقل میکند که وجود ندارد. دلیلش این است که مدل برای تولید متن محتمل آموزش دیده، نه برای بیان حقیقت. اتکا به منبع و اعلام ندانستن راههای کاهش آناند.
پنجره زمینه چیست؟
پنجرهی زمینه حداکثر تعداد توکنی است که مدل در یک درخواست میتواند ببیند؛ شامل پرامپت، تاریخچهی گفتوگو، اسناد و پاسخ. هرچه بزرگتر باشد، اسناد بیشتری جا میشود، اما هزینه و زمان پاسخ هم بالا میرود.
چرا مدل زبانی از رویدادهای اخیر خبر ندارد؟
چون دانش مدل به دادهی آموزش محدود است و آموزش در تاریخ مشخصی متوقف شده است. به این تاریخ، تاریخ قطع دانش میگویند. برای اطلاعات تازه یا خصوصی، باید آن را در زمان پرسش از طریق جستجو یا RAG به مدل داد.
دیدگاهها
هنوز دیدگاهی ثبت نشده است. شروعکننده باشید — پرسش و اصلاح را با آغوش باز میپذیریم.