
گراف دانش پاسخ سؤالی است که جستجوی برداری در آن ناکام میماند. دانشجو میپرسد «برای یادگیری ماشین پیشرفته، چه دورههایی را باید اول بگذرانم؟» پاسخ یک زنجیره است؛ یادگیری ماشین پیشرفته به مقدماتی نیاز دارد، مقدماتی به آمار و آمار به پایتون. هیچ قطعهی متنی کل این زنجیره را یکجا ندارد. اما یک گراف دانش آن را در یک پرسوجو برمیگرداند.
در قسمت سوم با بازنمایی دانش و سیستمهای خبره آشنا شدیم و دیدیم سهتایی «شیء، ویژگی، مقدار» چطور دانش را نگه میدارد. در دو قسمت قبل هم RAG و نمایهی برداری را ساختیم. در این قسمت این دو دنیا را به هم وصل میکنیم. گراف دانش، هستیشناسی و وب معنایی را میشناسیم و یاد میگیریم رابطه را کنار متن در دستیار به کار ببریم.
گراف دانش چیست؟
گراف دانش دانش را به شکل موجودیتها و رابطهها نگه میدارد. موجودیتها گرههای گرافاند؛ مثل دوره، استاد و دانشجو. رابطهها یالهای گرافاند؛ مثل «پیشنیاز دارد» یا «تدریس میکند». هر واقعیت یک سهتایی است.
از سهتایی تا گراف
در قسمت سوم، سهتایی را به شکل «Python، سازنده، گیدو ون روسوم» دیدیم. گراف دانش مجموعهی بزرگی از همین سهتاییهاست. وقتی سهتاییها به هم وصل شوند، میشود روی آنها مسیر پیدا کرد. «الف پیشنیاز ب است» و «ب پیشنیاز ج است» یعنی الف بهطور غیرمستقیم پیشنیاز ج است.
این قدرت استنتاج، مزیت اصلی گراف دانش است. دادهای که صریح ذخیره نشده، از رابطههای موجود نتیجه گرفته میشود. جستجوی برداری چنین کاری نمیکند؛ فقط متنهای مشابه را پیدا میکند.
هستیشناسی؛ قواعد بازی
گراف دانش بدون قاعده، بهسرعت آشفته میشود. یک نفر رابطهی «پیشنیاز» را بین دو دوره میگذارد و دیگری بین دوره و کتاب. هستیشناسی این قواعد را تعریف میکند؛ چه نوع موجودیتهایی داریم و چه رابطههایی بین کدام نوعها مجاز است.
هستیشناسی سلسلهمراتب هم تعریف میکند. «دورهی آنلاین» یک نوع «دوره» است. پس هر رابطهای که برای دوره مجاز است، برای دورهی آنلاین هم مجاز است. همان ایدهی قابها و سلسلهمراتب که در قسمت سوم دیدیم، اینجا رسمی و قابل پردازش شده است.
وب معنایی و پایگاههای دانش باز
در پایان قرن بیستم، ایدهای مطرح شد که کل وب را با دانش ساختاریافته حاشیهنویسی کند. این ایده وب معنایی نام گرفت. هدف این بود که ماشینها بتوانند صفحهها را نه فقط بخوانند، بلکه بفهمند و دربارهشان استدلال کنند.
RDF، OWL و URI
وب معنایی سه جزء اصلی دارد. همهی مفاهیم و رابطهها با یک شناسهی جهانی یا URI نامیده میشوند. پس «سازنده» در دو سایت مختلف دقیقاً یک مفهوم است. داده با زبان RDF به شکل سهتایی نوشته میشود و هستیشناسی با زبان OWL تعریف میشود.
OWL بر منطق توصیفی تکیه دارد که در قسمت سوم به آن اشاره کردیم. استدلالگرهای OWL میتوانند از هستیشناسی نتیجه بگیرند؛ مثلاً اگر کسی «مادر» است، «والد» هم هست. ابزاری مثل Protégé ساخت و ویرایش هستیشناسی را بصری میکند.
ویکیداده و پرسوجوی SPARQL
بزرگترین موفقیت عملی این ایدهها ویکیداده است؛ پایگاه دانش بازی که به ویکیپدیا وصل است و میلیونها موجودیت دارد. پرسوجو روی آن با زبان SPARQL انجام میشود که شبیه SQL است اما روی سهتاییها کار میکند:
SELECT ?lang ?langLabel WHERE {
?lang wdt:P31 wd:Q9143 . # نمونهای از «زبان برنامهنویسی»
SERVICE wikibase:label { bd:serviceParam wikibase:language "fa,en". }
}
LIMIT 20پروژههایی مثل Microsoft Concept Graph هم نشان دادند گراف دانش را میشود خودکار از متن استخراج کرد. این گراف میلیونها رابطهی «نوعی از» دارد؛ مثلاً «مایکروسافت نوعی شرکت است». امروز مدلهای زبانی بزرگ این استخراج را بسیار سادهتر کردهاند.
بیشتر بخوانید: سهتاییها، قابها و استنتاج پیشرو و بازگشتی را که ریشهی گراف دانشاند، در سیستم خبره چیست؟ دیدیم.
ساخت گراف پیشنیاز دورهها
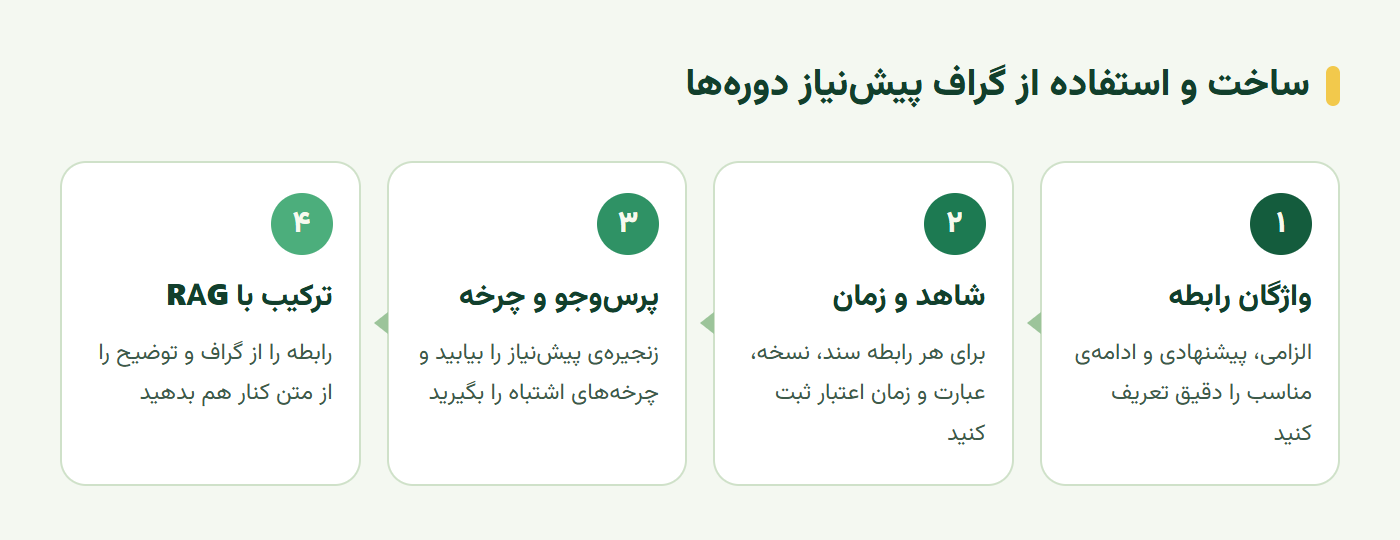
حالا یک گراف دانش کوچک و کاربردی برای دستیار آموزشی میسازیم؛ گراف پیشنیاز دورهها. نمودار زیر مسیر ساخت و استفاده از آن را نشان میدهد.
واژگان رابطه را محدود کنید
در توضیح دورهها، جملههایی مثل «آشنایی مقدماتی با پایتون توصیه میشود» و «گذراندن دورهی پایتون الزامی است» هر دو دیده میشوند. این دو یکسان نیستند. اولی دانش پیشنهادی است و دومی پیشنیاز الزامی.
پس واژگان رابطه را از ابتدا محدود و دقیق تعریف کنید؛ مثلاً «پیشنیاز الزامی»، «دانش پیشنهادی» و «ادامهی مناسب». اگر همه را «پیشنیاز» بنامید، دستیار به دانشجو میگوید بدون دورهای که فقط پیشنهاد شده بود، نمیتواند ثبتنام کند.
منشأ و اعتبار زمانی هر رابطه
هر رابطه باید به شاهدش اشاره کند؛ از کدام سند، کدام نسخه و کدام عبارت آمده است. اگر رابطه را یک مدل زبانی از متن استخراج کرده، این را هم ثبت کنید و پیش از استفاده، انسان تأییدش کند.
رابطهها همیشه معتبر نمیمانند. سرفصلها و شرایط ورود عوض میشوند. زمان اعتبار را کنار هر رابطه نگه دارید. کد زیر یک گراف کوچک با کتابخانهی networkx میسازد و همهی پیشنیازهای یک دوره را همراه منشأشان برمیگرداند:
import networkx as nx

g = nx.DiGraph()
g.add_edge("python-basics", "statistics", kind="required", source="syllabus-v3#2.1")
g.add_edge("statistics", "ml-basics", kind="required", source="syllabus-v3#4.2")
g.add_edge("ml-basics", "ml-advanced", kind="required", source="syllabus-v3#7.1")
g.add_edge("pandas", "ml-basics", kind="suggested", source="syllabus-v3#4.3")

required = g.edge_subgraph([(u, v) for u, v, d in g.edges(data=True) if d["kind"] == "required"])
print(nx.ancestors(required, "ml-advanced"))
print(list(nx.simple_cycles(g)))          # باید خالی باشد
ترکیب گراف دانش با RAG
گراف دانش و جستجوی برداری رقیب نیستند؛ مکملاند. گراف برای پرسشهای دقیق ساختاری عالی است؛ «پیشنیازهای این دوره چیست؟» متن آزاد برای توضیح چرایی و جزئیات ارزش دارد؛ «چرا آمار پیشنیاز یادگیری ماشین است؟»
GraphRAG؛ رابطه و متن کنار هم
در ترکیب این دو، که گاهی GraphRAG نامیده میشود، برای پرسش کاربر هر دو بازیابی میشوند. رابطههای مرتبط از گراف و قطعههای متنی از نمایهی برداری. هر دو به مدل زبانی داده میشوند و مدل پاسخی میسازد که هم دقیق است و هم توضیح دارد.
در ایجنتهای امروزی، گراف دانش اغلب یک ابزار است. ایجنت تصمیم میگیرد برای کدام بخش پرسش از گراف پرسوجو کند و برای کدام بخش از جستجوی متنی. همان الگوی بازیابی چندمرحلهای که در سری قبلی با عنوان Agentic RAG دیدیم.
سه حالت را جدا کنید
برای آزمون، سه دورهی فرضی بسازید. یکی پیشنیاز الزامی صریح دارد، یکی فقط دانش پیشنهادی و سومی هیچ اطلاعاتی دربارهی پیشنیاز ندارد. پاسخ درست برای این سه کاملاً متفاوت است.
برای دورهی سوم، دستیار نباید «پیشنیازی ندارد» بگوید. پاسخ درست «اطلاعاتی دربارهی پیشنیاز این دوره ثبت نشده است» است. نبود رابطه در گراف با نبود پیشنیاز در واقعیت یکی نیست. همان تفاوت مقدار خالی و صفر که از قسمت اول تأکید کردیم.
چرخهها و استنتاج ناخواسته
اگر دورهی الف پیشنیاز ب و ب پیشنیاز الف ثبت شود، داده اشتباه است یا تعریف رابطه مبهم. چنین چرخهای استنتاج را خراب میکند و ممکن است دانشجو هیچوقت نتواند ثبتنام کند. تابع simple_cycles در کد بالا این چرخهها را پیدا میکند.
استنتاج ناخواسته هم خطر دیگری است. اگر «دانش پیشنهادی» را بهاشتباه در زنجیرهی پیشنیاز الزامی بگذارید، فهرست پیشنیازها بهطور مصنوعی طولانی میشود. پس زنجیرهها را فقط روی رابطههای الزامی محاسبه کنید، همانطور که در کد دیدیم.
تمرین عملی؛ گراف پیشنیاز با شاهد
برای ده دورهی واقعی یا فرضی، این گراف را بسازید و آزمون کنید:
- فرهنگ رابطه: سه نوع رابطه با تعریف و مثال بنویسید.
- رکورد با شاهد: هر رابطه را با سند، نسخه و عبارت منبع ثبت کنید.
- پرسوجوها: همهی پیشنیازهای الزامی مستقیم و غیرمستقیم یک دوره را پیدا کنید.
- چرخه: عمداً یک چرخه اضافه کنید و مطمئن شوید آزمون آن را پیدا میکند.
- سه حالت: برای دورهی با پیشنیاز، با دانش پیشنهادی و بدون اطلاعات، پاسخ مورد انتظار دستیار را بنویسید.
در گزارش، تفاوت رابطهی صریح، رابطهی پیشنهادی و نبود اطلاعات را با یک مثال برای هرکدام توضیح دهید.
سخن پایانی
گراف دانش دانش را به شکل موجودیت و رابطه نگه میدارد و پرسشهای دقیق و چندمرحلهای را ممکن میکند. هستیشناسی قواعد آن را تعریف میکند و وب معنایی با RDF، OWL و SPARQL این ایده را در مقیاس وب پیاده کرد. ویکیداده بزرگترین نمونهی عملی آن است.
در دستیار، گراف دانش را کنار جستجوی برداری به کار ببرید. واژگان رابطه را دقیق تعریف کنید، منشأ و زمان اعتبار هر رابطه را ثبت کنید، چرخهها را پیدا کنید و نبود رابطه را با نبود واقعیت یکی ندانید.
این آموزش بر پایهی درس Knowledge Representation and Expert Systems از مجموعهی AI for Beginners و درس Agentic RAG از مجموعهی AI Agents for Beginners مایکروسافت (مجوز MIT) به فارسی بازنویسی و تکمیل شده است.
پرسشهای پرتکرار
گراف دانش چیست؟
گراف دانش شیوهای برای ذخیرهی دانش به شکل موجودیتها و رابطههای بین آنهاست. هر واقعیت یک سهتایی از فاعل، رابطه و مفعول است؛ مثلاً «پایتون پیشرفته، پیشنیاز دارد، پایتون مقدماتی». این ساختار پرسشهای دقیق و چندمرحلهای را ممکن میکند.
هستیشناسی چیست؟
هستیشناسی یا Ontology تعریف رسمی مفاهیم یک حوزه و رابطههای مجاز بین آنهاست. مثلاً تعریف میکند «دوره» و «دانشجو» چه نوع موجودیتیاند و رابطهی «پیشنیاز» فقط بین دو دوره برقرار است.
تفاوت گراف دانش و جستجوی برداری چیست؟
جستجوی برداری متنهای مشابه از نظر معنا را پیدا میکند اما رابطهی دقیق را نمیداند. گراف دانش رابطهها را صریح نگه میدارد و به پرسشهایی مثل همهی پیشنیازهای مستقیم و غیرمستقیم یک دوره پاسخ دقیق میدهد. سیستمهای خوب هر دو را ترکیب میکنند.
GraphRAG چیست؟
GraphRAG ترکیب گراف دانش با RAG است. برای پرسش کاربر، هم رابطههای مرتبط از گراف و هم قطعههای متنی از نمایهی برداری بازیابی میشوند و هر دو به مدل زبانی داده میشوند تا پاسخ هم دقیق و هم توضیحی باشد.
دیدگاهها
هنوز دیدگاهی ثبت نشده است. شروعکننده باشید — پرسش و اصلاح را با آغوش باز میپذیریم.