
قطعهبندی اسناد جایی است که بیشتر سیستمهای RAG بیصدا شکست میخورند. آییننامهای را تصور کنید که در یک بند میگوید «تکلیف تا پایان هفته پذیرفته میشود» و در بند بعد میافزاید «به جز پروژههای گروهی که مهلتشان دو هفته است». اگر این دو بند در دو قطعهی جدا بیفتند، دانشجویی که دربارهی پروژهی گروهی میپرسد، پاسخ غلط و مطمئنی میگیرد.
در قسمت قبل نمایهی برداری را طوری طراحی کردیم که بهروزرسانی و حذف در آن ممکن باشد. حالا یک قدم عقبتر میرویم؛ به اسنادی که وارد نمایه میشوند. در این قسمت یاد میگیریم اسناد را پاکسازی کنیم، درست قطعهبندی کنیم و منشأ را حفظ کنیم تا بازیابی به پاسخ درست برسد.
چرا آمادهسازی اسناد مهمترین بخش RAG است؟
در RAG، مدل زبانی فقط قطعههایی را میبیند که بازیابی شدهاند. اگر قطعهی درست بازیابی نشود، بهترین مدل هم پاسخ درست نمیدهد. اگر قطعه ناقص باشد، مدل با اطمینان بر اساس نیمی از حقیقت پاسخ میدهد.
ورودی بد، پاسخ بد
همان اصلی که در قسمت پاکسازی داده دیدیم، اینجا هم صادق است. اسناد سازمانی پر از مشکلاند؛ نسخههای تکراری، سربرگ و پانویس تکرارشونده در هر صفحه، متن استخراجشدهی بههمریخته از PDF و جدولهایی که به ردیفهای بیمعنا تبدیل شدهاند.
هرکدام از این مشکلات کیفیت بازیابی را پایین میآورد. سربرگ تکراری «آموزشگاه تخته سبز، صفحهی ۳» در همهی قطعهها، شباهت برداری آنها را به هم نزدیک میکند. نسخهی تکراری یک سند، جای قطعههای مفید دیگر را در نتایج میگیرد.
حذف تکراری و پاکسازی
پیش از قطعهبندی، اسناد تکراری را حذف کنید. دو فایل با نام متفاوت اما محتوای یکسان رایجاند. با درهمسازی متن نرمالشده، تکراریهای دقیق پیدا میشوند. برای تکراریهای نزدیک، مثل دو نسخه با یک جمله تفاوت، شباهت برداری کل سند کمک میکند.
بعد متن را پاکسازی کنید. سربرگ و پانویس تکرارشونده، شمارهی صفحه و کاراکترهای خراب استخراج را حذف کنید. متن فارسی را هم با همان نرمالسازی قسمت پیشپردازش متن یکدست کنید. اما مراقب باشید چیزی را حذف نکنید که بخشی از معناست.
قطعهبندی اسناد؛ اندازه، مرز و همپوشانی
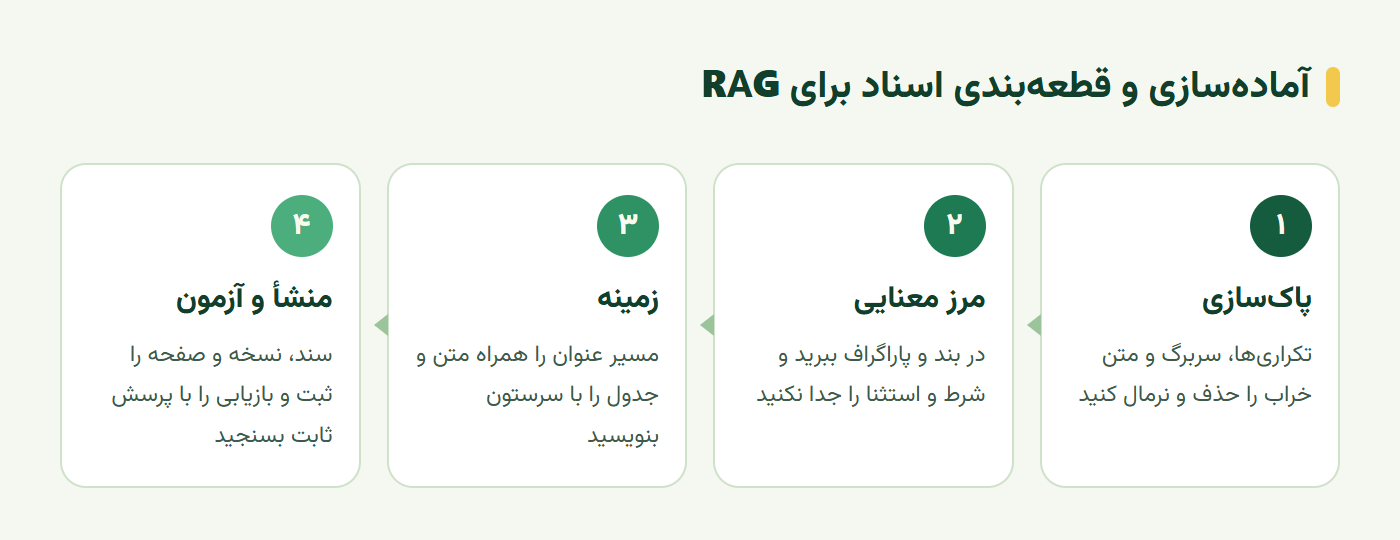
قطعهبندی سه تصمیم دارد؛ اندازهی قطعه، محل مرز و مقدار همپوشانی. هیچ عدد جادویی وجود ندارد. تصمیم درست به نوع سند و نوع پرسشها بستگی دارد. نمودار زیر مسیر کامل آمادهسازی را نشان میدهد.
اندازهی قطعه
قطعهی خیلی کوچک، مثلاً یک جمله، زمینهی کافی ندارد. «این مهلت دو هفته است» بدون جملهی قبلی معنایی ندارد. قطعهی خیلی بزرگ، مثلاً یک فصل کامل، معنا را رقیق میکند. بردار آن میانگین ده موضوع است و به هیچ پرسشی دقیق نزدیک نیست.
نقطهی شروع رایج چند صد توکن است؛ حدود یک یا دو پاراگراف. اما عدد نهایی را با آزمون انتخاب کنید. بیست پرسش واقعی با قطعهی درست مورد انتظار بنویسید و ببینید با هر اندازه، قطعهی درست چند بار در پنج نتیجهی اول میآید.
مرز معنایی و همپوشانی
به جای بریدن در تعداد ثابت نویسه، در مرزهای طبیعی ببرید؛ عنوان، پاراگراف و جمله. سند ساختاریافته مثل آییننامه، بند به بند قطعهبندی شود. متن آزاد، پاراگراف به پاراگراف. فقط اگر پاراگرافی خیلی بلند بود، آن را در مرز جمله تقسیم کنید.
همپوشانی از گم شدن اطلاعات در مرز جلوگیری میکند. با همپوشانی ده تا بیست درصد، انتهای هر قطعه در ابتدای قطعهی بعد تکرار میشود. کد زیر قطعهبندی بر اساس پاراگراف با سقف اندازه و همپوشانی جملهای را نشان میدهد:
import re
def chunk(text, max_chars=1200, overlap_sents=1):
sents = [s for p in text.split("\n\n") for s in re.split(r"(?<=[.!؟?])\s+", p.strip()) if s]
chunks, cur = [], []
for s in sents:
if cur and sum(len(x) for x in cur) + len(s) > max_chars:
chunks.append(" ".join(cur))
cur = cur[-overlap_sents:] # همپوشانی با قطعهی قبل
cur.append(s)
if cur:
chunks.append(" ".join(cur))
return chunksبیشتر بخوانید: شناسهی پایدار، فراداده و انتشار منسجم قطعهها در نمایه را در پایگاه داده برداری طراحی کردیم.
حفظ معنا؛ شرط، عنوان و جدول
قطعهبندی درست فقط اندازه و مرز نیست. سه نوع اطلاعات بهراحتی در قطعهبندی از دست میرود؛ رابطهی شرط و استثنا، زمینهی عنوان و ساختار جدول. هرکدام راهحل خودش را دارد.
شرط و استثنا را کنار هم نگه دارید
سند آموزشی مجموعهای از جملههای مستقل نیست. یک بند شرطی دارد و بند بعدی آن را با استثنا محدود میکند. اگر این دو جدا شوند، بازیابی بند اول بهتنهایی پاسخ نادرست میسازد. همان مثال مهلت تکلیف و پروژهی گروهی.
در قطعهبندی، کلماتی مثل «به جز»، «مگر»، «در صورتی که» و «این قاعده شامل … نمیشود» را نشانهی پیوند با جملهی قبل بدانید. قطعه را پیش از آنها نبرید. برای آزمون، پرسشهایی دربارهی استثناها را عمداً در مجموعهی آزمون بگذارید.
عنوان و منشأ همراه متن
جملهای مثل «این روش برای سطح مقدماتی مناسب است» بیرون از عنوان بخشش مبهم است. کدام روش؟ کدام دوره؟ مسیر عنوانها را به ابتدای متن هر قطعه اضافه کنید؛ مثلاً «آییننامهی آموزشی › مهلتها › پروژههای گروهی». این کار هم بازیابی را بهتر میکند و هم فهم مدل را.
برای ارجاع، شناسهی سند، نسخه و محل قطعه را در فراداده ثبت کنید. اگر متن از PDF استخراج شده، بررسی کنید شمارهی صفحه با نسخهی قابل نمایش هماهنگ است. دستیاری که میگوید «طبق صفحهی ۷ آییننامه» باید واقعاً صفحهی ۷ را نشان دهد.
جدول را به ردیف بیمعنا تبدیل نکنید
در جدول، معنای هر عدد به سرستون و عنوان جدول وابسته است. استخراج فقط مقدار سلولها رابطه را نابود میکند. عدد «۸» بدون سرستون «مدت به هفته» و ردیف «پایتون مقدماتی» هیچ معنایی ندارد.
هر ردیف جدول را همراه نام ستونها به یک جمله تبدیل کنید؛ «دورهی پایتون مقدماتی؛ مدت: ۸ هفته؛ پیشنیاز: ندارد؛ شهریه: …». عنوان جدول را هم به ابتدای آن اضافه کنید. حالا هر ردیف یک قطعهی خودکفا و قابل بازیابی است.
الگوهای سازمانی RAG
درس اصلی RAG را در مقیاس سازمانی با .NET و Microsoft Foundry بررسی میکند. جدا از زبان و سرویس، چند الگوی آن در هر سازمانی کاربرد دارد.
امنیت و مدیریت اسناد
اسناد سازمانی سطح دسترسی دارند. کنترل دسترسی باید در زمان بازیابی و در سمت سرویس اعمال شود، همانطور که در قسمت قبل دیدیم. دادهی حساس مثل شمارهی ملی یا اطلاعات مالی را پیش از ورود به نمایه شناسایی و در صورت امکان حذف یا پنهان کنید.
اسناد هم زندهاند. آییننامهها عوض میشوند و دورهها اضافه و حذف میشوند. یک فرایند منظم برای دریافت نسخهی تازه، قطعهبندی دوباره و انتشار منسجم لازم است. بدون آن، دستیار بهتدریج از واقعیت فاصله میگیرد.
پردازش ناهمگام و پایش
پردازش هزاران سند زمانبر است. آن را ناهمگام و در صف انجام دهید، نه در زمان درخواست کاربر. هر سند وضعیت خودش را داشته باشد تا شکست یک فایل، کل فرایند را متوقف نکند.
کیفیت بازیابی را هم در طول زمان بپایید. پرسشهایی که پاسخ خوبی نگرفتند را جمع کنید و بررسی کنید مشکل از بازیابی بود یا از تولید پاسخ. بیشتر وقتها ریشهی مشکل در قطعهبندی است، نه در مدل.
تمرین عملی؛ آزمون قطعهبندی
یک سند واقعی، مثلاً آییننامهی آموزشی با دستکم یک جدول و چند استثنا، انتخاب کنید و این کارها را انجام دهید:
- پاکسازی: سربرگ، پانویس و شمارهی صفحه را حذف و متن را نرمال کنید.
- سه اندازه: سند را با سه اندازهی قطعه، کوچک، متوسط و بزرگ، قطعهبندی کنید.
- پرسشهای آزمون: بیست پرسش بنویسید که دستکم پنجتایشان دربارهی استثنا و سهتایشان دربارهی جدول باشد.
- سنجش بازیابی: برای هر اندازه، بشمارید قطعهی درست چند بار در پنج نتیجهی اول آمده است.
- مقایسهی قبل و بعد: یک نمونهی ساده، یک نمونهی دارای استثنا و یک ردیف جدول را قبل و بعد از قطعهبندی کنار هم بگذارید.
نتیجه نشان میدهد کدام اندازه برای سند شما بهتر است و آیا استثناها و جدولها درست حفظ شدهاند.
سخن پایانی
قطعهبندی اسناد تعیین میکند دستیار RAG چه چیزی را ببیند. پیش از آن، اسناد را پاکسازی و تکراریها را حذف کنید. قطعهها را در مرزهای معنایی با اندازهی سنجیده و همپوشانی ببرید و اندازهی نهایی را با آزمون بازیابی انتخاب کنید.
معنا را هم حفظ کنید؛ شرط و استثنا را کنار هم نگه دارید، عنوان و منشأ را همراه هر قطعه ثبت کنید و جدول را با سرستونهایش به متن تبدیل کنید. بیشتر مشکلات کیفیت RAG در همین مرحله حل میشوند، نه با مدل بزرگتر.
این آموزش بر پایهی درس Working with Data: Data Preparation از مجموعهی Data Science for Beginners و نمونهی RAG سازمانی .NET از مجموعهی AI Agents for Beginners مایکروسافت (مجوز MIT) به فارسی بازنویسی و تکمیل شده است.
پرسشهای پرتکرار
قطعهبندی اسناد در RAG یعنی چه؟
یعنی تقسیم اسناد طولانی به تکههای کوچکتر پیش از بردارسازی. هر تکه جداگانه در نمایه ذخیره و بازیابی میشود. اندازه و مرز قطعهها تعیین میکند مدل چه زمینهای برای پاسخ دارد.
اندازه مناسب قطعه چقدر است؟
پاسخ ثابتی ندارد. قطعهی خیلی کوچک زمینه را از دست میدهد و قطعهی خیلی بزرگ معنا را رقیق و هزینه را زیاد میکند. نقطهی شروع رایج چند صد توکن با همپوشانی حدود ده تا بیست درصد است، اما عدد نهایی را با آزمون بازیابی روی پرسشهای واقعی انتخاب کنید.
چرا همپوشانی بین قطعهها لازم است؟
چون مرز قطعه ممکن است وسط یک ایده بیفتد. با همپوشانی، انتهای یک قطعه در ابتدای قطعهی بعد تکرار میشود تا جملهها و ارتباطشان در مرز گم نشوند.
با جدولها در RAG چه کنیم؟
جدول را به ردیفهای بیسرستون تبدیل نکنید. هر ردیف را همراه نام ستونها و عنوان جدول به متن تبدیل کنید، مثلاً «دوره پایتون مقدماتی؛ مدت ۸ هفته؛ بدون پیشنیاز». اینطور معنای هر عدد حفظ میشود.
دیدگاهها
هنوز دیدگاهی ثبت نشده است. شروعکننده باشید — پرسش و اصلاح را با آغوش باز میپذیریم.