
توهم هوش مصنوعی خطرناک است، نه به این دلیل که پاسخ غلط میدهد، بلکه به این دلیل که پاسخ غلط را با اطمینان کامل میدهد. دانشجو میپرسد «اگر یک جلسه غیبت کنم، از امتحان محروم میشوم؟» و دستیار با لحنی مطمئن جوابی میدهد که در هیچ آییننامهای نیامده است. دانشجو هم دلیلی برای شک کردن ندارد.
در قسمت مدل زبانی بزرگ، پاسخ ساختگی را اولین محدودیت LLM شمردیم. در این قسمت همین محدودیت را از نزدیک بررسی میکنیم. میبینیم چرا رخ میدهد، چطور در چهار لایه کاهشش دهیم و چطور دستیاری بسازیم که وقتی نمیداند، صادقانه بگوید نمیدانم.
توهم هوش مصنوعی چیست و چرا رخ میدهد؟
توهم یعنی پاسخی که روان و معقول به نظر میرسد، اما نادرست یا ساختگی است. نمونههای رایجش منبع و مقالهای است که وجود ندارد، عددی که از هیچ جا نیامده، یا قانونی که با قانون واقعی شباهت دارد اما جزئیاتش ساختگی است.
ریشهی توهم
مدل زبانی برای پیشبینی محتملترین ادامهی متن آموزش دیده است. وقتی از او دربارهی آییننامهی آموزشگاه شما میپرسند، آییننامه را ندیده است. اما هزاران آییننامهی دیگر دیده است. پس متنی میسازد که شبیه یک آییننامهی معمولی است.
آموزش برای مفید بودن هم گاهی مشکل را بدتر میکند. مدل یاد گرفته پاسخ دادن را کاربران بیشتر میپسندند تا «نمیدانم». بدون دستور صریح و دادهی درست، تمایل دارد جای خالی را با متن محتمل پر کند.
چرا توهم از خطای معمولی خطرناکتر است؟
خطای معمولی نرمافزار معمولاً خودش را نشان میدهد؛ صفحه باز نمیشود یا پیام خطا میآید. توهم خودش را نشان نمیدهد. پاسخ درست و غلط هر دو روان و مطمئناند. کاربر هیچ نشانهای برای تشخیص ندارد.
به همین دلیل، کاهش توهم نمیتواند فقط بر عهدهی کاربر باشد. باید در طراحی سیستم ساخته شود. اصول هوش مصنوعی مسئولانه که در قسمت سوگیری دیدیم، مثل شفافیت و قابلیت اطمینان، اینجا مستقیم به کار میآیند.
چهار لایه کاهش آسیب
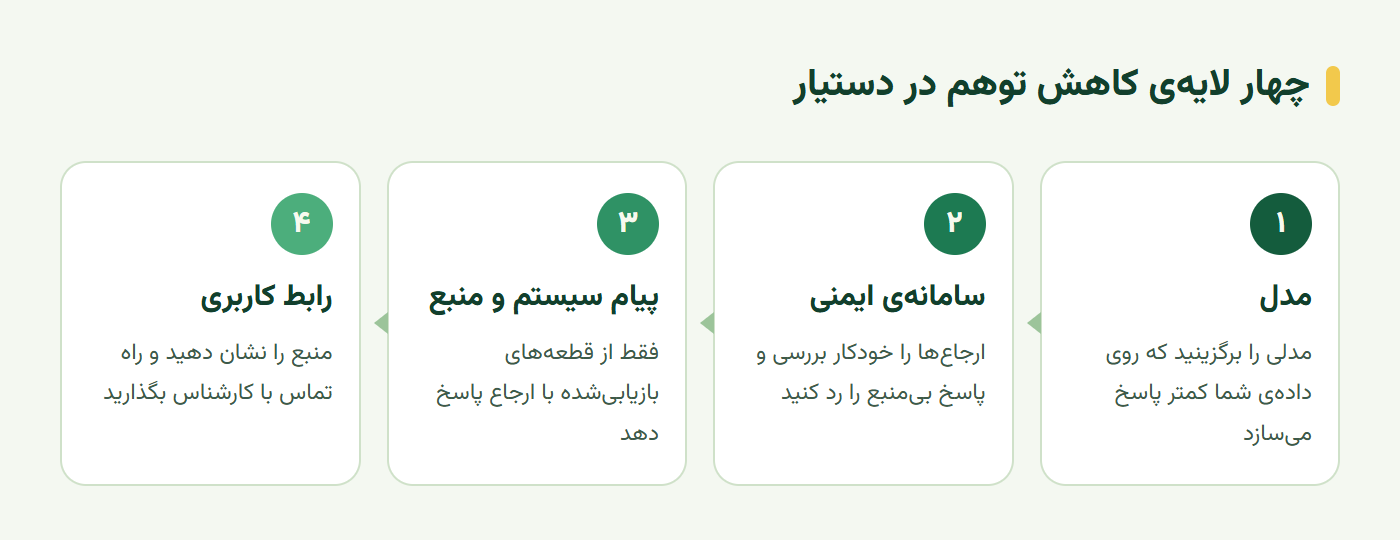
درس اصلی مایکروسافت کاهش آسیب را در چهار لایه تعریف میکند. هیچ لایهای بهتنهایی کافی نیست؛ ترکیبشان است که سیستم قابل اعتماد میسازد. نمودار زیر این چهار لایه را نشان میدهد.
لایهی مدل و سامانهی ایمنی
لایهی اول انتخاب مدل مناسب است. بعضی مدلها در اعتراف به ندانستن و پیروی از دستور «فقط از منبع پاسخ بده» بهتر عمل میکنند. این را با آزمون روی دادهی خودتان بسنجید، نه با جدولهای عمومی.
لایهی دوم سامانهی ایمنی است؛ فیلترهای محتوا، پایش و محدودیتهایی که بیرون از مدل اعمال میشوند. برای توهم، این لایه میتواند شامل بررسی خودکار ارجاعها باشد. اگر پاسخ به بندی ارجاع میدهد که در منبع نیست، پاسخ رد یا علامتگذاری شود.
پیام سیستم و اتکا به منبع
لایهی سوم پیام سیستم یا فراپرامپت است. اینجا رفتار مدل را صریح تعریف میکنید؛ فقط از منبع دادهشده پاسخ بده، برای هر ادعا به بند منبع ارجاع بده و اگر پاسخ در منبع نیست، صریح بگو اطلاعات کافی نداری. مهمتر از همه، اطلاعات درست را با RAG در همان درخواست به مدل بدهید.
مدل بدون منبع، هرچقدر هم دستور دقیق بگیرد، چیزی برای استناد ندارد. پس پیام سیستم و بازیابی منبع دو نیمهی یک راهحلاند. کیفیت بازیابی هم مستقیم روی توهم اثر دارد؛ اگر قطعهی درست بازیابی نشود، مدل یا نمیداند یا از قطعهی نامرتبط نتیجهی غلط میگیرد.
رابط کاربری
لایهی چهارم رابط کاربری است. منبع هر پاسخ را کنارش نشان دهید تا کاربر بتواند بررسی کند. برای پرسشهای حساس، مثل محرومیت از امتحان، یک پیوند به متن کامل آییننامه یا مسیر تماس با کارشناس بگذارید.
به کاربر هم بگویید با یک دستیار هوش مصنوعی حرف میزند که ممکن است خطا کند. این شفافیت انتظار را درست تنظیم میکند. کاربری که میداند باید منبع را برای تصمیم مهم بررسی کند، کمتر آسیب میبیند.
بیشتر بخوانید: اصول طراحی دستیار مسئولانه، از سنجش آسیب تا راهاندازی امن، را در دستیار هوش مصنوعی مسئولانه مفصل دیدیم.
طراحی پاسخ مستند
حالا این لایهها را در یک طراحی عملی کنار هم میگذاریم. هدف دستیاری است که هر ادعایش را به منبع ارجاع دهد و وقتی منبعی ندارد، بگوید.
پیام سیستم نمونه
پیام سیستم باید کوتاه، صریح و قابل آزمون باشد. نمونهی زیر سه رفتار را تعریف میکند؛ پاسخ از منبع، ارجاع و اعلام ندانستن:
You answer questions about the school's regulations.
Use ONLY the numbered excerpts provided below. Cite the excerpt number for every claim, e.g. [2].
If the excerpts do not contain the answer, reply exactly:
"این مورد در آییننامههای موجود نیامده است. لطفاً با کارشناس آموزش تماس بگیرید."
Never guess dates, numbers, fees or deadlines.
Answer in Persian.قطعههای بازیابیشده با شماره زیر همین پیام قرار میگیرند. جملهی اعلام ندانستن دقیقاً از پیش نوشته شده تا بشود در آزمون خودکار آن را تشخیص داد. قید آخر دربارهی تاریخ، عدد و مبلغ هم حساسترین نوع توهم را هدف میگیرد.
رفتار در نبود مدرک
اعلام ندانستن باید یک رفتار طراحیشده باشد، نه یک اتفاق. جملهی دقیقش را از پیش تعیین کنید و مسیر بعدی را هم به کاربر بدهید؛ تماس با کارشناس یا پیوند به صفحهی مرتبط. «نمیدانم» بدون راه ادامه، کاربر را ناامید میکند.
حالت میانه را هم در نظر بگیرید؛ وقتی منبع بخشی از پاسخ را دارد. مثلاً آییننامه قاعدهی کلی غیبت را دارد اما دربارهی غیبت پزشکی چیزی نمیگوید. پاسخ درست این است که بخش موجود را با ارجاع بگوید و صریح اعلام کند دربارهی بخش دیگر اطلاعاتی نیست.
ارزیابی اتکا به منبع
بدون ارزیابی نمیدانید دستیار چقدر توهم میزند. ارزیابی توهم به یک مجموعهی آزمون ویژه نیاز دارد، نه فقط پرسشهایی که پاسخشان در منبع هست.
مجموعهی آزمون سهبخشی
مجموعهی آزمون سه نوع پرسش داشته باشد. پرسشهایی که پاسخ کامل در منبع دارند؛ پرسشهایی که پاسخ بخشی دارند؛ و پرسشهایی که هیچ پاسخی در منبع ندارند. نوع سوم مهمترین است. دستیاری که روی این پرسشها پاسخ میسازد، در عمل توهم میزند.
برای هر پرسش، رفتار مورد انتظار را از پیش بنویسید. بعد نرخ درست بودن را برای هر نوع جداگانه گزارش کنید. همان ارزیابی تفکیکی که از قسمت سوگیری با آن آشنا هستید.
سنجش ادعا به ادعا
برای پاسخهایی که داده شده، اتکا به منبع را ادعا به ادعا بسنجید. پاسخ را به ادعاهای جداگانه تقسیم کنید و برای هرکدام بررسی کنید در قطعهی ارجاعشده هست یا نه. نسبت ادعاهای پشتیبانیشده، معیار اتکا به منبع است.
این کار را میشود با یک مدل داور خودکار کرد. اما مدل داور هم خطا دارد. پس نمونهای از داوریهایش را انسان بررسی کند. هر تغییر پرامپت، مدل یا روش بازیابی را روی همین مجموعهی آزمون بسنجید.
تمرین عملی؛ آزمون توهم
برای دستیار آییننامهی آموزشی، این آزمون را طراحی و اجرا کنید:
- منبع: یک آییننامهی کوتاه با ده بند شمارهدار آماده کنید.
- سی پرسش: ده پرسش با پاسخ کامل، ده با پاسخ بخشی و ده بدون پاسخ در منبع بنویسید.
- دو پرامپت: یک پرامپت ساده و پیام سیستم نمونهی بالا را امتحان کنید.
- نرخ توهم: برای پرسشهای بیپاسخ، درصد پاسخهای ساختگی را برای هر پرامپت حساب کنید.
- اتکا به منبع: برای پنج پاسخ، ادعاها را جدا و پشتیبانی هرکدام را بررسی کنید.
تفاوت نرخ توهم بین دو پرامپت، اثر طراحی را ملموس نشان میدهد. اگر حتی با پیام سیستم دقیق هم توهم ماند، مدل یا بازیابی را بررسی کنید.
سخن پایانی
توهم هوش مصنوعی از سازوکار مدلهای زبانی میآید؛ آنها برای متن محتمل آموزش دیدهاند، نه متن درست. خطرش در اطمینانی است که پاسخ غلط با آن گفته میشود. کاهشش در چهار لایه انجام میشود؛ مدل، سامانهی ایمنی، پیام سیستم و رابط کاربری.
دستیار قابل اعتماد اطلاعات درست را از منبع میگیرد، به آن ارجاع میدهد و وقتی منبعی ندارد، صادقانه میگوید و راه بعدی را نشان میدهد. و همهی اینها را با مجموعهی آزمونی میسنجید که پرسشهای بیجواب را عمداً در خود دارد.
این آموزش بر پایهی درس Using Generative AI Responsibly از مجموعهی Generative AI for Beginners و درس Building Trustworthy AI Agents از مجموعهی AI Agents for Beginners مایکروسافت (مجوز MIT) به فارسی بازنویسی و تکمیل شده است.
پرسشهای پرتکرار
توهم هوش مصنوعی چیست؟
توهم یا Hallucination یعنی مدل زبانی پاسخی روان، مطمئن و بهظاهر معقول میدهد که نادرست یا ساختگی است؛ مثلاً منبعی را نقل میکند که وجود ندارد یا قانونی را شرح میدهد که هرگز نوشته نشده است.
چرا مدلهای زبانی توهم میزنند؟
چون برای تولید محتملترین ادامهی متن آموزش دیدهاند، نه برای بیان حقیقت. وقتی اطلاعات کافی ندارند، متنی میسازند که شبیه پاسخ درست است. آموزش برای مفید بودن هم گاهی آنها را به پاسخ دادن به جای اعتراف به ندانستن تشویق میکند.
چطور توهم را در دستیار کاهش دهیم؟
اطلاعات درست را هنگام پرسش به مدل بدهید، از او بخواهید فقط از همان منبع پاسخ دهد و به آن ارجاع دهد، رفتار اعلام ندانستن را صریح تعریف کنید و با مجموعهای از پرسشهای بیجواب آزمون بگیرید. در رابط کاربری هم منبع را نشان دهید.
چطور اتکای پاسخ به منبع را ارزیابی کنیم؟
برای هر پاسخ بررسی کنید آیا هر ادعای آن در منبع دادهشده وجود دارد. نسبت ادعاهای پشتیبانیشده به کل ادعاها، معیار اتکا به منبع است. این بررسی را میشود با انسان یا با یک مدل داور و نمونهبرداری انسانی انجام داد.
دیدگاهها
هنوز دیدگاهی ثبت نشده است. شروعکننده باشید — پرسش و اصلاح را با آغوش باز میپذیریم.