
استقرار مدل یادگیری ماشین همان قدمی است که بیشتر پروژهها هرگز برنمیدارند. مدل در نوتبوک دقت خوبی دارد، نمودارها زیبا هستند و گزارش نوشته شده است. اما هیچ برنامهای از آن استفاده نمیکند. ارزش واقعی مدل وقتی ساخته میشود که برنامهای بتواند با یک درخواست ساده، پیشبینی بگیرد.
در قسمت قبل مرز یک سرویس هوش مصنوعی را در جاوا طراحی کردیم. در این قسمت همان اصول را برای یک مدل یادگیری ماشین کلاسیک در پایتون به کار میبریم. با یک مجموعهدادهی جالب مدل میسازیم، آن را امن ذخیره میکنیم و به یک API با قرارداد روشن تبدیل میکنیم.
از نوتبوک تا سرویس
نوتبوک برای آزمایش عالی است، اما برای استقرار نه. کد پراکنده است، ترتیب اجرای سلولها مهم است و وضعیت در حافظه نگه داشته میشود. برای استقرار، باید آموزش و پیشبینی را از هم جدا کنیم.
سه پرسش پیش از استقرار
پیش از ساخت API، به این سه پرسش پاسخ دهید. مدل کجا اجرا میشود؛ روی سرور، در مرورگر یا روی گوشی؟ دادهی ورودی در زمان پیشبینی از کجا میآید و آیا همان ویژگیهای آموزش را دارد؟ و مدل هر چند وقت یک بار دوباره آموزش میبیند؟
پاسخ پرسش اول ابزار را تعیین میکند. برای سرور، یک API وب با Flask یا FastAPI رایج است. برای مرورگر، ONNX را در قسمت طبقهبندی دیدیم. پاسخ پرسش دوم مهمترین خطر استقرار را آشکار میکند؛ ویژگیای که در آموزش بود اما در زمان پیشبینی نیست.
دادهی گزارشهای مشاهدهی بشقابپرنده
درس اصلی از یک مجموعهدادهی جالب استفاده میکند؛ حدود هشتاد هزار گزارش مشاهدهی اشیای ناشناختهی پرنده از مرکز ملی گزارشهای آمریکا. هر گزارش زمان، مدت مشاهده به ثانیه، شهر، کشور و مختصات جغرافیایی دارد.
سؤال مدل این است: با دانستن مدت مشاهده و مختصات، گزارش از کدام کشور آمده است؟ مسئله کمی سرگرمکننده است، اما همهی چالشهای واقعی استقرار را دارد. پاکسازی، انتخاب ویژگی و ساختن سرویسی که ورودی نامعتبر را رد کند.
ساخت و ذخیره امن مدل
ابتدا داده را پاکسازی و مدل را آموزش میدهیم. بعد مهمترین تصمیم استقرار را میگیریم؛ مدل را چطور ذخیره کنیم که در سرویس دقیقاً همان رفتار را داشته باشد.
پاکسازی و آموزش
ردیفهای خالی را حذف و مدت مشاهده را به بازهی ۱ تا ۶۰ ثانیه محدود میکنیم؛ گزارشهای خیلی طولانی اغلب نامعتبرند. کشور با رمزگذار برچسب به عدد تبدیل میشود. مدل یک رگرسیون لجستیک است.
نکتهی مهم این است که پیشپردازش و مدل را در یک Pipeline بگذاریم. همان درسی که در قسمت مهندسی ویژگی دیدیم. اگر مقیاسبندی جدا از مدل ذخیره شود، ممکن است API آن را فراموش کند و پیشبینیها بیصدا غلط شوند:
import joblib
import pandas as pd
from sklearn.linear_model import LogisticRegression
from sklearn.model_selection import train_test_split
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler

ufos = pd.read_csv("ufos.csv").dropna(subset=["duration (seconds)", "latitude", "longitude", "country"])
ufos = ufos[ufos["duration (seconds)"].between(1, 60)]
X = ufos[["duration (seconds)", "latitude", "longitude"]].to_numpy()
y = ufos["country"]
X_tr, X_te, y_tr, y_te = train_test_split(X, y, test_size=0.2, stratify=y, random_state=0)

model = make_pipeline(StandardScaler(), LogisticRegression(max_iter=1000)).fit(X_tr, y_tr)
print("accuracy:", round(model.score(X_te, y_te), 3))
joblib.dump({"model": model, "version": "2026.11-1", "features": ["seconds", "latitude", "longitude"]},
            "ufo_model.joblib")
خطر pickle
درس اصلی مدل را با pickle ذخیره میکند و joblib هم در پشت صحنه از همان سازوکار استفاده میکند. یک خطر امنیتی جدی اینجا هست. باز کردن فایل pickle میتواند کد دلخواه اجرا کند. اگر کسی فایل مدل را دستکاری کند، سرور شما را در دست میگیرد.
قاعده ساده است. فقط فایلهایی را باز کنید که خودتان ساختهاید و در مسیری نگه داشتهاید که فقط سیستم استقرار به آن دسترسی نوشتن دارد. برای مدلهایی که بین تیمها یا سازمانها جابهجا میشوند، قالبهای امنتر مثل ONNX یا skops را به کار ببرید.
بیشتر بخوانید: قرارداد درخواست، مهلت، تلاش دوباره و نگاشت خطا را برای یک سرویس هوش مصنوعی در سرویس هوش مصنوعی در جاوا طراحی کردیم.
ساخت API با Flask
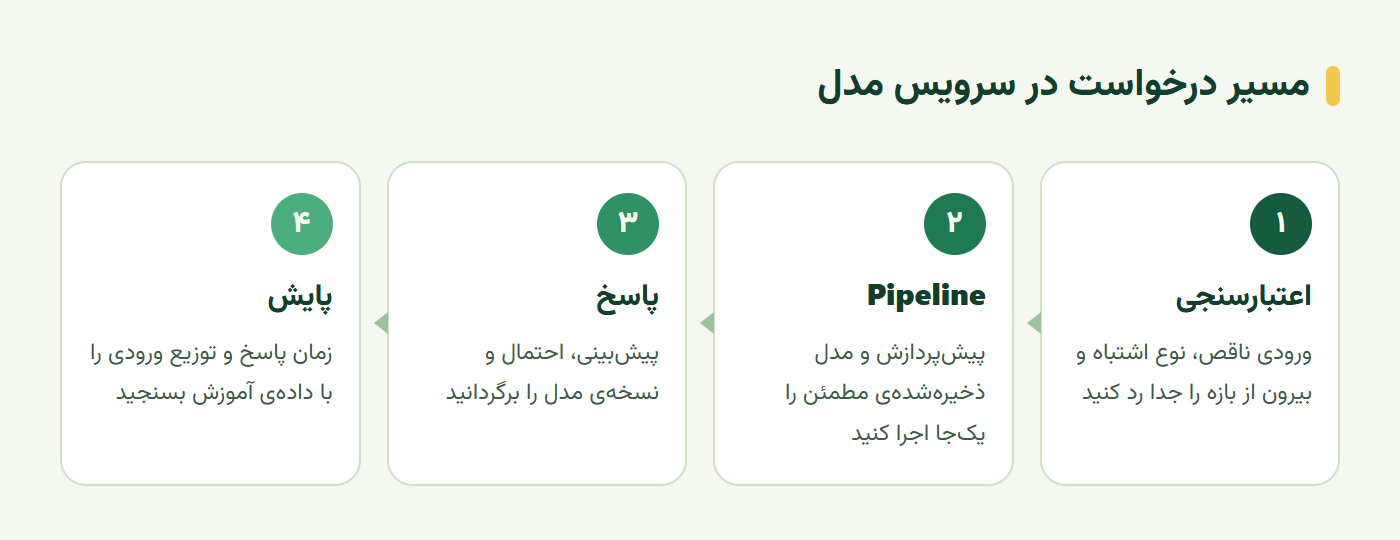
حالا مدل ذخیرهشده را در یک سرویس وب بارگذاری میکنیم. درس اصلی یک صفحهی وب با فرم میسازد. ما یک API با JSON میسازیم که هر برنامهای بتواند صدایش بزند. نمودار زیر مسیر یک درخواست را در این سرویس نشان میدهد.
کد سرویس
مدل یک بار هنگام شروع سرویس بارگذاری میشود، نه برای هر درخواست. ورودی اعتبارسنجی میشود و خروجی علاوه بر پیشبینی، احتمال و نسخهی مدل را هم دارد:
import joblib
from flask import Flask, jsonify, request
app = Flask(__name__)
bundle = joblib.load("ufo_model.joblib") # فقط فایل ساختهی خودمان
model, VERSION = bundle["model"], bundle["version"]
@app.post("/api/v1/predict")
def predict():
body = request.get_json(silent=True) or {}
try:
s, lat, lon = float(body["seconds"]), float(body["latitude"]), float(body["longitude"])
except (KeyError, TypeError, ValueError):
return jsonify(error="seconds, latitude and longitude are required numbers"), 400
if not (1 <= s <= 60 and -90 <= lat <= 90 and -180 <= lon <= 180):
return jsonify(error="value out of the range the model was trained on"), 422
proba = model.predict_proba([[s, lat, lon]])[0]
i = proba.argmax()
return jsonify(country=str(model.classes_[i]), probability=round(float(proba[i]), 3),
model_version=VERSION)
@app.get("/health")
def health():
return jsonify(status="ok", model_version=VERSION)قرارداد ورودی و خروجی
به دو نوع خطای ورودی دقت کنید. خطای ۴۰۰ یعنی ورودی ناقص یا از نوع اشتباه است. خطای ۴۲۲ یعنی ورودی درست است، اما بیرون از بازهای که مدل با آن آموزش دیده. مدل روی مشاهدههای یک تا شصت ثانیه آموزش دیده است. پیشبینی برای ده هزار ثانیه برونیابی است و قابل اعتماد نیست.
خروجی هم نسخهی مدل را دارد. وقتی مدل تازهای مستقر میشود و کسی گزارش خطا میدهد، میدانید کدام نسخه پاسخ داده است. احتمال را هم برگردانید تا مصرفکننده بتواند برای پیشبینیهای کماطمینان رفتار متفاوتی داشته باشد.
پس از استقرار؛ پایش و نسخه
استقرار پایان کار نیست؛ شروع مرحلهی تازهای است. مدل در محیط واقعی با دادهای روبهرو میشود که ممکن است با دادهی آموزش فرق داشته باشد.
پایش سرویس و داده
دو نوع پایش لازم است. پایش سرویس زمان پاسخ، نرخ خطا و در دسترس بودن را میسنجد؛ مثل هر سرویس وب دیگری. پایش داده توزیع ورودیها و پیشبینیها را در طول زمان میسنجد.
همان مقایسهی هیستوگرام که در قسمت توزیع داده دیدیم، اینجا به کار میآید. اگر توزیع ورودیها از دادهی آموزش دور شد، رانش داده رخ داده است. اگر نسبت پیشبینی یک دسته ناگهان عوض شد، چیزی تغییر کرده که باید بررسی شود.
نسخه و بازگشت
هر مدل مستقرشده یک نسخهی مشخص داشته باشد که همراه دادهی آموزش، کد و عدد ارزیابیاش ثبت شده است. مدل تازه را کنار مدل قدیم مستقر کنید و درصد کمی از درخواستها را به آن بفرستید.
اگر مدل تازه مشکلی داشت، بازگشت به نسخهی قبل باید در چند دقیقه ممکن باشد. این همان منطق انتشار منسجم است که در قسمت پایگاه دادهی برداری دیدیم. هیچ مدلی را طوری مستقر نکنید که راه برگشت نداشته باشد.
تمرین عملی؛ API مدل خودتان
یکی از مدلهایی که در این مجموعه ساختید را به API تبدیل کنید:
- Pipeline: پیشپردازش و مدل را در یک Pipeline ذخیره کنید، همراه نسخه و فهرست ویژگیها.
- سرویس: نقطهی پایانی پیشبینی و سلامت بسازید.
- اعتبارسنجی: ورودی ناقص، نوع اشتباه و بیرون از بازه را جداگانه رد کنید.
- آزمون: برای هر سه نوع خطا و یک ورودی درست، آزمون خودکار بنویسید.
- پایش: ورودیها را بدون دادهی شخصی ثبت کنید و پس از صد درخواست، هیستوگرامشان را با دادهی آموزش مقایسه کنید.
در پایان بررسی کنید آیا کسی جز سیستم استقرار میتواند فایل مدل را تغییر دهد. اگر بله، این یک مشکل امنیتی است.
سخن پایانی
استقرار مدل یادگیری ماشین آن را از نوتبوک به سرویسی میبرد که برنامهها صدایش میزنند. پیشپردازش و مدل را در یک Pipeline ذخیره کنید، خطر pickle را جدی بگیرید و مدل را یک بار هنگام شروع سرویس بارگذاری کنید.
قرارداد روشن ورودی و خروجی، اعتبارسنجی بازهی آموزش، نسخهی مدل در پاسخ و نقطهی پایانی سلامت، سرویس را قابل اعتماد میکنند. پس از استقرار هم سرویس و داده را بپایید و همیشه راه بازگشت به نسخهی قبل را باز نگه دارید.
این آموزش بر پایهی درس Build a Web App to use a ML Model از مجموعهی آزاد ML for Beginners مایکروسافت (مجوز MIT) به فارسی بازنویسی و تکمیل شده است.
پرسشهای پرتکرار
استقرار مدل یادگیری ماشین یعنی چه؟
یعنی مدلی که آموزش دادهاید را در محیطی قرار دهید که برنامهها و کاربران بتوانند از آن پیشبینی بگیرند؛ معمولاً به شکل یک API وب. شامل ذخیرهی مدل، ساخت سرویس، تعریف قرارداد ورودی و خروجی و پایش عملکرد در محیط واقعی است.
چرا pickle برای ذخیره مدل خطرناک است؟
چون باز کردن فایل pickle میتواند کد دلخواه اجرا کند. اگر فایل مدل از منبع نامطمئن بیاید یا دستکاری شود، باز کردنش سیستم را به خطر میاندازد. فقط فایلهایی را باز کنید که خودتان ساختهاید یا از قالبهای امنتر مثل ONNX یا skops استفاده کنید.
چرا پیشپردازش باید همراه مدل ذخیره شود؟
چون مدل روی دادهی پیشپردازششده آموزش دیده است. اگر API ورودی را کمی متفاوت از آموزش آماده کند، مثلاً مقیاسبندی نکند، پیشبینیها بیصدا اشتباه میشوند. ذخیرهی کل Pipeline این خطر را از بین میبرد.
پس از استقرار مدل چه چیزهایی را باید پایش کرد؟
زمان پاسخ و نرخ خطای سرویس، توزیع ورودیها برای کشف رانش داده، توزیع پیشبینیها و در صورت امکان دقت روی نمونههایی که برچسب واقعیشان بعداً معلوم میشود.
دیدگاهها
هنوز دیدگاهی ثبت نشده است. شروعکننده باشید — پرسش و اصلاح را با آغوش باز میپذیریم.